วิธีที่เร็วที่สุดในการถอดความวิดีโอเป็นข้อความคือการให้เครื่องมือแปลงเสียงเป็นข้อความด้วย AI ทำการถอดความรอบแรก: อัปโหลดไฟล์วิดีโอหรือวางลิงก์ YouTube ปล่อยให้ระบบแปลงเสียงพูดเป็นถอดความที่แก้ไขได้ แล้วจึงตรวจทานส่วนที่มีแนวโน้มผิดพลาดมากที่สุด ขั้นตอนสุดท้ายนั้นสำคัญกว่าที่คนส่วนใหญ่คาดคิด เพราะคำว่า "เร็ว" ควรหมายถึงการถอดความรอบแรกอย่างรวดเร็วบวกกับการตรวจสอบคุณภาพสั้น ๆ ไม่ใช่ความสมบูรณ์แบบในทันที ในทางกลับกัน การพิมพ์เองหมายถึงการหยุด กรอกลับ และพิมพ์ใหม่ทุกบรรทัด ซึ่งเป็นจุดที่เวลาหายไปเป็นชั่วโมง
หากคุณต้องการวิธีปฏิบัติจริงในการถอดความวิดีโอเป็นข้อความ เวิร์กโฟลว์ Speech to Text ของเรารองรับการอัปโหลดวิดีโอและลิงก์ YouTube ให้คุณแก้ไขโปรเจกต์ที่ได้ รองรับมากกว่า 60 ภาษา และจัดการไฟล์ขนาดสูงสุด 5 GB โดยไม่มีการระบุขีดจำกัดความยาวของวิดีโอ ส่วนที่เหลือของคู่มือนี้จะอธิบายกลไกเบื้องหลัง วิธีเลือกรูปแบบผลลัพธ์ที่เหมาะสม และวิธีรักษาความแม่นยำให้สูงเมื่อเสียงต่อต้าน
สารบัญ
การถอดความวิดีโอเป็นข้อความหมายถึงอะไรจริง ๆ
การถอดความวิดีโอแปลงเสียงพูดภายในวิดีโอเป็นคำที่เขียนออกมา ผลลัพธ์เดียวนี้สามารถใช้ได้หลายงาน: ถอดความวิดีโอฉบับเต็ม ซับไตเติลหรือคำบรรยายปิด สคริปต์สำหรับการตัดต่อ ร่างบล็อกหรือจดหมายข่าว บันทึกที่ค้นหาได้ของการประชุมและการบรรยาย หรือข้อความต้นฉบับที่คุณจะแปลในภายหลังสำหรับผู้ชมกลุ่มใหม่
มันช่วยให้แยกความแตกต่างของสามคำที่มักสับสนกันได้ การถอดความ (Transcription) รักษาภาษาพูดต้นฉบับไว้ในรูปแบบข้อความ การแปล (Translation) แปลงเนื้อหานั้นเป็นอีกภาษาหนึ่ง การพากย์ (Dubbing) แทนที่หรือเพิ่มเสียงพูดในภาษาอื่น คุณถอดความก่อน แล้วจึงตัดสินใจว่าการแปลหรือการพากย์เป็นขั้นตอนถัดไปหรือไม่ หากคุณต้องการคำนิยามเชิงลึกของเทคโนโลยีการรู้จำเสียงเบื้องหลังทั้งหมดนี้ คู่มือของเราเกี่ยวกับวิธีการทำงานของ speech-to-text ครอบคลุมพื้นฐานไว้
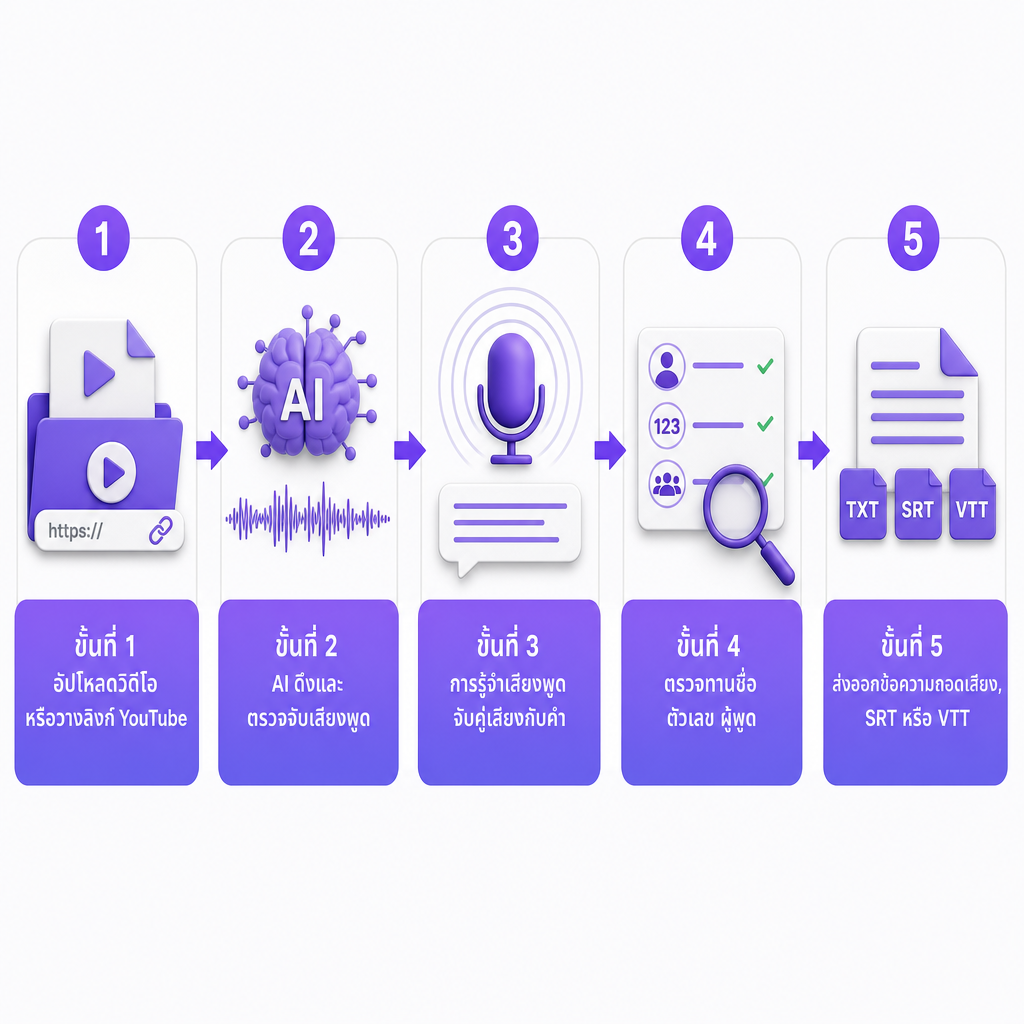
การถอดความวิดีโอด้วย AI ทำงานเบื้องหลังอย่างไร
การรู้จักกระบวนการช่วยให้คุณคาดการณ์ได้ว่าข้อผิดพลาดมาจากที่ใด ระบบถอดความอัตโนมัติส่วนใหญ่ผ่านขั้นตอนเดียวกัน อย่างแรก ระบบอ่านแทร็กเสียงภายในวิดีโอ ถัดมา มันตรวจจับว่าส่วนใดมีคำพูดจริง ๆ จากนั้นโมเดลการรู้จำจะจับคู่รูปแบบเสียงกับคำ และขั้นตอนการประมวลผลภาษาจะใช้บริบทโดยรอบเพื่อปรับปรุงการคาดการณ์เหล่านั้น คำที่รู้จำได้จะถูกประกอบเป็นประโยคหรือเป็นช่วงที่มีเวลากำกับ และสุดท้ายคุณแก้ไขและส่งออกผลลัพธ์
โมเดลการรู้จำเป็นเพียงส่วนหนึ่งของสมการคุณภาพ คุณภาพไมโครโฟน ผู้พูดซ้อนทับกัน สำเนียง ดนตรีพื้นหลัง เสียงก้องในห้อง คำศัพท์เทคนิค และการพูดแทรก ล้วนกำหนดผลลัพธ์ ระบบ Speech to Text ของเราถูกสร้างมาเพื่อจัดการกับสภาพแวดล้อมที่มีเสียงรบกวน ผู้พูดหลายคน และภาษาและสำเนียงที่ต่างกัน โดยมีข้อควรระวังตามจริงว่าความแม่นยำแปรผันตามคุณภาพเสียงและความหลากหลายของสำเนียง ข้อควรระวังนั้นคือเหตุผลที่มีการตรวจทาน ไม่ใช่ข้อบกพร่องที่ต้องปกปิด
ถอดความ คำบรรยาย หรือซับไตเติล: เลือกผลลัพธ์ที่ถูกต้อง
รูปแบบการส่งออกที่ดีที่สุดขึ้นอยู่กับว่าข้อความนั้นมีไว้เพื่ออะไรทั้งหมด และการเลือกผิดทำให้เสียเวลาในภายหลัง
ถอดความแบบธรรมดาคือข้อความที่อ่านได้โดยไม่ต้องมีการกำหนดเวลา ใช้มันเมื่อคุณต้องการบันทึกการวิจัย บันทึกการประชุม สคริปต์วิดีโอ ร่างบล็อกหรือจดหมายข่าว หรือเนื้อหาที่จะนำไปใช้ซ้ำ ไทม์สแตมป์เป็นทางเลือกในกรณีนี้ แม้ว่าจะช่วยให้ผู้ตัดต่อข้ามไปมาได้
คำบรรยาย (Captions) ซิงค์ข้อความกับวิดีโอและสามารถบรรจุข้อมูลที่ไม่ใช่คำพูดที่เกี่ยวข้อง เช่น ดนตรี เสียงปรบมือ หรือเสียงประตูปิด มันสำคัญสำหรับการเข้าถึงและสำหรับใครก็ตามที่ดูโดยไม่มีเสียง ซับไตเติล (Subtitles) โดยทั่วไปแสดงบทสนทนาที่พูดสำหรับผู้ชมที่ไม่เข้าใจภาษา เมื่อคุณต้องการซับไตเติลในอีกภาษาหนึ่ง ให้ถอดความต้นฉบับก่อน แล้วจึงแปลและกำหนดเวลาให้ข้อความที่แปล
สำหรับรูปแบบที่มีเวลากำกับ WebVTT เป็นมาตรฐานเว็บสำหรับแทร็กข้อความที่จัดวางตามเวลา ข้อกำหนด W3C WebVTT อธิบายว่าเป็นรูปแบบสำหรับคำบรรยาย ซับไตเติล บท คำอธิบาย และข้อมูลเมตาอื่น ๆ ที่ซิงค์กับเสียงหรือวิดีโอ สำหรับการอัปโหลด YouTube ทั้ง SubRip .srt และ .vtt ล้วนอยู่ในรูปแบบซับไตเติลที่รองรับ และ YouTube ระบุว่าไฟล์ .srt พื้นฐานต้องใช้การเข้ารหัส UTF-8 แบบธรรมดา
ทำความสะอาดเสียงก่อนถอดความวิดีโอที่มีเสียงรบกวน
เสียงรบกวนพื้นหลังเป็นหนึ่งในสาเหตุที่พบบ่อยที่สุดของข้อผิดพลาดในการถอดความ เสียงบนถนน เครื่องปรับอากาศ เสียงสะท้อนกลับของไมโครโฟน ดนตรีที่แข่งกัน และเสียงก้องในห้อง ล้วนทำให้เขตแดนระหว่างคำพร่าเลือน และโมเดลการรู้จำมีสัญญาณน้อยลงให้ใช้งาน
วิธีแก้ไขคือการแยกคำพูดออกมาก่อนการถอดความ Speech Separator ของเราขจัดเสียงรบกวนพื้นหลังและแยกคำพูดออกจากเสียงโดยรอบ รองรับรูปแบบหลัก ๆ เช่น MP3, WAV และ AAC รวมถึงไฟล์วิดีโอ มันคุ้มค่าที่จะมีในเวิร์กโฟลว์สำหรับการสัมภาษณ์ที่บันทึกกลางแจ้ง พอดแคสต์ที่บันทึกในห้องที่ไม่ได้ปรับสภาพเสียง วิดีโอที่มีดนตรีพื้นหลังหนัก การอภิปรายแบบคณะที่มีระดับไมโครโฟนไม่สม่ำเสมอ และฟุตเทจจากคลังที่มีเสียงฮัมหรือเสียงรอบข้าง
ข้อควรระวังหนึ่งสำหรับงานด้านการเข้าถึง: อย่าตัดเสียงทุกอย่างออกโดยอัตโนมัติ หากเสียงหนึ่งมีความหมาย เช่น เสียงไซเรน เสียงสัญญาณเตือน หรือประกาศทางลำโพง มันอาจยังต้องแสดงในคำบรรยายแม้ว่าจะถูกตัดออกจากแทร็กคำพูดที่สะอาดซึ่งคุณส่งไปถอดความ
วิธีเพิ่มความแม่นยำของการถอดความ
ปฏิบัติต่อการถอดความด้วย AI เสมือนร่างแรกที่แข็งแกร่ง แล้วจึงใช้การควบคุมแบบเจาะจงแทนการอ่านซ้ำทุกอย่างอย่างตาบอด
เริ่มด้วยไฟล์ต้นฉบับที่ชัดเจนที่สุด อัปโหลดการบันทึกต้นฉบับแทนที่จะเป็นไฟล์ดาวน์โหลดจากโซเชียลมีเดียที่ถูกบีบอัด เพราะสัญญาณคำพูดที่สะอาดกว่าให้โมเดลมีข้อมูลมากขึ้นให้ใช้งาน ลดเสียงที่แข่งกันด้วยการลดหรือขจัดดนตรีพื้นหลัง และใช้แทร็กคำพูดที่สะอาดที่สุดที่มีอยู่หากวิดีโอมีแทร็กแยก เลือกภาษาหรือสำเนียงที่ตรงกับการบันทึกเมื่อมีตัวเลือกนั้น ซึ่งช่วยให้ระบบตีความการออกเสียง การสะกด และโครงสร้างประโยค
จากนั้นให้มุ่งไปที่จุดที่มักล้มเหลวได้ง่าย ค้นหาในถอดความสำหรับคำนามเฉพาะ เช่น ชื่อ แบรนด์ สถานที่ ศัพท์ผลิตภัณฑ์ และศัพท์เฉพาะ แทนที่จะไว้วางใจการอ่านทั่วไป ตรวจทานการเปลี่ยนผู้พูด และเพิ่มป้ายกำกับผู้พูดด้วยตนเองเมื่อถอดความจะถูกใช้เพื่อวัตถุประสงค์ทางกฎหมาย การศึกษา การวิจัย หรือบรรณาธิการ ตรวจสอบรายการสั้น ๆ ที่สำคัญต่อความหมาย: วันที่ ราคา เปอร์เซ็นต์ หน่วยวัด URL ตัวย่อ คำปฏิเสธอย่าง "not" และคำที่ออกเสียงคล้ายกัน เพราะความพลาดเพียงครั้งเดียวสามารถพลิกความหมายของประโยคได้
วิธีที่เชื่อถือได้ที่สุดคือการเล่นวิดีโอไปพร้อมกับติดตามถอดความ สำหรับการบันทึกยาว ให้ข้ามไปยังส่วนที่มีชื่อ ตัวเลข เสียงที่ไม่ชัดเจน หรือเสียงที่ซ้อนทับกันก่อน สิ่งนี้สะท้อนข้อควรระวังที่ควรจดจำไว้: คำบรรยายอัตโนมัติอาจตีความคำพูดผิดเพราะการออกเสียงผิด สำเนียง ภาษาถิ่น และเสียงรบกวนพื้นหลัง
การจับคู่เวิร์กโฟลว์ให้เข้ากับประเภทเนื้อหาของคุณ
รูปแบบที่ต่างกันสร้างความกดดันต่อส่วนต่าง ๆ ของกระบวนการ ดังนั้นปรับว่าคุณจะใช้เวลาตรวจทานที่ใด
สำหรับ วิดีโอ YouTube ถอดความจะป้อนให้กับคำบรรยาย คำอธิบาย บท การเลือกคลิป และการนำไปใช้ซ้ำที่เน้นการค้นหา ใช้ไฟล์อัปโหลดต้นฉบับหรือแหล่งที่มาคุณภาพสูงเมื่อคุณเป็นเจ้าของวิดีโอ การสัมภาษณ์และพอดแคสต์ มักต้องมีป้ายกำกับผู้พูดและการจัดการเสียงรบกวนที่แข็งแกร่งขึ้น ดังนั้นทำความสะอาดเสียงจากสภาพแวดล้อมที่พลุกพล่านก่อน และรักษาตัวตนผู้พูดให้สอดคล้องกัน วิดีโอ e-learning และฝึกอบรม ควรให้ความสำคัญกับความแม่นยำในคำสั่ง คำศัพท์ ตัวเลข และการอ้างอิงบนหน้าจอ โดยมีคำบรรยายที่ซิงค์ใกล้เคียงพอที่ผู้เรียนจะติดตามคำอธิบายและหน้าจอไปพร้อมกัน
การประชุมธุรกิจ กลายเป็นบันทึกที่ค้นหาได้และรายการสิ่งที่ต้องทำ แต่การสนทนาที่ละเอียดอ่อนต้องการความระมัดระวังเพิ่มเติม: ตรวจสอบชื่อ การตัดสินใจ วันที่ และความรับผิดชอบที่มอบหมายก่อนแบ่งปัน วิดีโอโซเชียลแบบสั้น มักแปลงถอดความเป็นคำบรรยายบนหน้าจอ คำอธิบายโพสต์ หรือเวอร์ชันที่แปลแล้ว ดังนั้นให้ตัดบรรทัดสั้น ๆ สำหรับมือถือ และตรวจสอบให้แน่ใจว่าคำบรรยายไม่บังภาพสำคัญ
วิธีเลือกเครื่องมือแปลงวิดีโอเป็นข้อความ
ประเมินเวิร์กโฟลว์ทั้งหมด ไม่ใช่แค่ตัวเลขความแม่นยำที่โฆษณา ตารางด้านล่างจับคู่เกณฑ์ที่เปลี่ยนเวลาดำเนินการและคุณภาพผลลัพธ์ของคุณจริง ๆ
| เกณฑ์การตัดสินใจ | สิ่งที่ต้องตรวจสอบ |
|---|---|
| การรองรับอินพุต | มันรองรับวิดีโอ เสียง หรือ URL ของ YouTube ของคุณหรือไม่? |
| ขีดจำกัดไฟล์ | ขนาดไฟล์สูงสุดและระยะเวลาวิดีโอสูงสุดคือเท่าใด? |
| การครอบคลุมภาษา | มันรองรับภาษา ภาษาถิ่น และสำเนียงของคุณหรือไม่? |
| การจัดการผู้พูด | คุณสามารถระบุหรือแยกผู้พูดหลายคนได้หรือไม่? |
| รูปแบบผลลัพธ์ | คุณสามารถส่งออกข้อความธรรมดา SRT หรือ VTT ได้หรือไม่? |
| การผสานรวม | มี API สำหรับประมวลผลวิดีโอในระดับใหญ่หรือไม่? |
หน้า Speech to Text สาธารณะของเรายืนยันการรองรับอินพุตวิดีโอและลิงก์ YouTube โปรเจกต์ที่แก้ไขได้ การดาวน์โหลด การรองรับมากกว่า 60 ภาษา และขีดจำกัดขนาด 5 GB เราไม่ได้ระบุในหน้านั้นว่าผลลัพธ์ทุกรายการมีไทม์สแตมป์หรือไม่ ไฟล์ถูกเก็บรักษานานเท่าใด หรือการระบุผู้พูดเป็นอัตโนมัติหรือไม่ ดังนั้นโปรดยืนยันรายละเอียดเฉพาะเหล่านั้นสำหรับเวิร์กโฟลว์ของคุณเองก่อนที่จะมอบเนื้อหาที่ละเอียดอ่อนหรือจำนวนมาก หากคำตอบใด ๆ เหล่านั้นมีความสำคัญชี้ขาดสำหรับคุณ บอกเราถึงประเภทไฟล์ ภาษา จำนวนผู้พูด และผลลัพธ์ที่ต้องการ แล้วเราสามารถชี้ให้คุณไปยังการกำหนดค่าที่ถูกต้องได้
ความเป็นส่วนตัว สิทธิ์ และมาตรฐานการตรวจทานที่สมเหตุสมผล
ถอดความสามารถมีข้อมูลธุรกิจที่เป็นความลับ ข้อมูลส่วนบุคคล การสนทนากับลูกค้า เนื้อหาที่ยังไม่เผยแพร่ หรือเนื้อหาที่มีลิขสิทธิ์ ก่อนอัปโหลด ให้ยืนยันว่าคุณมีสิทธิ์ประมวลผลการบันทึก ว่ามีความยินยอมของผู้พูดที่จำเป็นอยู่ และว่าวิดีโอมีข้อมูลที่เป็นความลับหรืออยู่ภายใต้การควบคุมหรือไม่ ตรวจสอบว่าผู้ให้บริการจัดเก็บและลบไฟล์ที่อัปโหลดและถอดความที่สร้างขึ้นอย่างไร ใครสามารถเข้าถึงโปรเจกต์และไฟล์ส่งออกได้ และว่าไฟล์อาจถูกใช้สำหรับการฝึกโมเดลหรือไม่ จำไว้ว่าการถอดความการบันทึกที่มีลิขสิทธิ์นั้นทำได้ง่ายในทางเทคนิค แต่ไม่ได้ให้สิทธิ์ในการเผยแพร่เนื้อหาซ้ำ คุณยังคงต้องมีสิทธิ์ในการเผยแพร่แหล่งที่มา ถอดความ คำบรรยาย หรือการแปล
ปรับความลึกของการตรวจทานให้เหมาะกับความเสี่ยง การตรวจทานแบบเบาเหมาะกับคลิปโซเชียล บันทึกภายใน และการระดมความคิดแบบคร่าว ๆ: สแกนหาข้อผิดพลาดที่ชัดเจน ชื่อ ตัวเลข และประโยคที่ขาดหายไป การตรวจทานแบบเต็มเหมาะกับหลักสูตร คำบรรยายสาธารณะ การสัมภาษณ์ บันทึกลูกค้า เนื้อหาทางกฎหมาย และสิ่งใด ๆ ที่เผยแพร่: ฟังการบันทึกทั้งหมด แก้ไขถ้อยคำ ตรวจสอบป้ายกำกับผู้พูด ตรวจไทม์สแตมป์ และยืนยันว่าคำบรรยายตรงตามกฎรูปแบบของแพลตฟอร์มปลายทาง สำหรับการเข้าถึง ให้ตรวจทานเกินกว่าบทสนทนา เนื่องจากเสียงเอฟเฟกต์ที่สำคัญ การเปลี่ยนผู้พูด และสัญญาณที่มีความหมายอาจต้องแสดงในคำบรรยาย
เส้นทางที่มีประสิทธิภาพเหมือนกันทุกครั้ง: เริ่มด้วยวิดีโอที่สะอาดที่สุดที่คุณมี แยกคำพูดเมื่อเสียงยาก สร้างถอดความที่แก้ไขได้ ตรวจสอบชื่อและตัวเลข และส่งออกรูปแบบที่แพลตฟอร์มของคุณต้องการ สำหรับทีมที่ทำงานข้ามภาษา ถอดความนั้นยังเป็นจุดเริ่มต้นตามธรรมชาติสำหรับการแปลและการพากย์ในภายหลังด้วย
คำถามที่พบบ่อย
วิธีที่เร็วที่สุดในการถอดความวิดีโอเป็นข้อความคืออะไร?
ใช้เครื่องมือแปลงเสียงเป็นข้อความอัตโนมัติที่รองรับวิดีโอโดยตรงหรือรองรับลิงก์ YouTube อัปโหลดแหล่งที่มาที่ชัดเจนที่สุด เลือกภาษาที่ถูกต้อง สร้างถอดความ แล้วตรวจทานส่วนที่มีแนวโน้มผิดพลาดมากที่สุดก่อน
ฉันสามารถถอดความวิดีโอโดยไม่ต้องพิมพ์เองได้หรือไม่?
ได้ เครื่องมือแปลงเสียงเป็นข้อความด้วย AI แปลงเสียงพูดเป็นข้อความที่แก้ไขได้โดยอัตโนมัติ คุณยังควรตรวจทานผลลัพธ์ เพราะความแม่นยำสามารถแปรผันตามเสียงรบกวน สำเนียง การพูดซ้อนทับ และคำศัพท์เฉพาะทาง
DubSmart สามารถถอดความวิดีโอยาว ๆ ได้หรือไม่?
ได้ เครื่องมือ Speech to Text ของเรารองรับเสียงหรือวิดีโอที่อัปโหลดและลิงก์ YouTube รองรับการแก้ไข และให้คุณดาวน์โหลดโปรเจกต์ที่เสร็จสมบูรณ์ เราระบุการรองรับมากกว่า 60 ภาษาและขีดจำกัดไฟล์ 5 GB โดยไม่มีการระบุขีดจำกัดความยาวของวิดีโอ เวลาประมวลผลจริงแปรผันตามไฟล์และเสียง
ฉันควรทำอย่างไรหากถอดความมีข้อผิดพลาดมากมาย?
ปรับปรุงเสียงต้นฉบับก่อน ขจัดเสียงที่แข่งกันด้วยเครื่องมือแยกคำพูด ยืนยันภาษาที่เลือก แล้วสร้างใหม่หรือแก้ไขถอดความ โดยให้ความสนใจเป็นพิเศษกับชื่อเฉพาะ ตัวเลข สำเนียง และผู้พูดที่ซ้อนทับกัน
ฉันควรใช้รูปแบบซับไตเติลใด?
ใช้รูปแบบที่แพลตฟอร์มของคุณต้องการ SRT ได้รับการรองรับอย่างกว้างขวาง ในขณะที่ WebVTT เป็นรูปแบบข้อความที่มีเวลากำกับซึ่งเน้นเว็บ และ YouTube รองรับทั้งสองรูปแบบในบรรดารูปแบบซับไตเติล