หากคุณมาถึงหน้านี้เพราะ comfyui text to speech โดยคาดหวังปุ่มเดียวที่เปลี่ยนสคริปต์ให้กลายเป็นเสียง สิ่งแรกที่ควรรู้คือ ComfyUI ไม่ใช่เครื่องมือสร้างเสียงเลย มันคือพื้นที่ทำงานแบบใช้โหนด (node-based) ที่คุณเชื่อมต่อข้อความ เสียงพูด โมเดล ภาษา และเอาต์พุตเสียงเข้าด้วยกันเป็นกราฟที่นำกลับมาใช้ซ้ำได้ ตัวเสียงพูดเองมาจากโหนด TTS ที่คุณเชื่อมต่อ ไม่ว่าจะเป็นผู้ให้บริการแบบโฮสต์ การผสานรวมของพาร์ทเนอร์อย่างเป็นทางการ หรือโมเดลที่คุณติดตั้งเองในเครื่อง คำถามที่สำคัญจริงๆ จึงไม่ใช่ว่า ComfyUI พูดสคริปต์ของคุณได้หรือไม่ เพราะมันทำได้ แต่คือว่ากราฟแบบวิชวลเป็นที่ที่เหมาะสมสำหรับงานที่คุณต้องทำซ้ำหรือไม่
ความแตกต่างนั้นเป็นตัวกำหนดการตัดสินใจอื่นๆ ทุกอย่างในหน้านี้ ComfyUI ตอบแทนการทดลองและไปป์ไลน์แบบมัลติโมดัลที่เสียงบรรยายอยู่เคียงข้างการสร้างภาพ วิดีโอ และเสียง ส่วนเครื่องมือเสียงพูดเฉพาะทางตอบแทนการผลิตที่ทำซ้ำได้ซึ่งคุณเพียงต้องการเสียงบรรยายที่สะอาดครั้งแล้วครั้งเล่า ด้านล่างนี้ เราจะแยกย่อยว่าเวิร์กโฟลว์ทำงานอย่างไร มีตัวเลือกประเภทใดบ้าง จะประเมินมันอย่างไร และจุดไหนที่กราฟหยุดคุ้มค่าต่อการดูแลรักษา
สารบัญ
ComfyUI text to speech คืออะไรกันแน่
ComfyUI text to speech คือการใช้กราฟ ComfyUI แปลงข้อความที่เขียนไว้ให้เป็นเอาต์พุต AUDIO เอกสารประกอบอย่างเป็นทางการอธิบายว่า ComfyUI เป็นแอปพลิเคชันโอเพนซอร์สแบบใช้โหนดสำหรับการสร้างเวิร์กโฟลว์ข้ามการสร้างภาพ วิดีโอ เสียง และ 3D และโหนดเสียงของมันเชื่อมต่อบริการหรือโมเดลเสียงพูดภายนอกเข้ากับผืนผ้าใบวิชวลเดียวกันนั้น
กราฟเสียงพูดที่ใช้งานได้นั้นมีขนาดเล็ก มันต้องการอินพุตข้อความหรือพรอมต์ โหนด TTS อินพุตเสียงพูดหรือเสียงอ้างอิง การตั้งค่าภาษาและการนำเสนอแบบเสริม และโหนดแสดงตัวอย่างหรือบันทึกเสียง โหนด TTS จะส่งสคริปต์ของคุณผ่านโมเดลเสียงพูดและส่งคืนเสียงที่สร้างขึ้นซึ่งโหนดถัดไปสามารถนำไปใช้ได้
ผลลัพธ์ในทางปฏิบัติคือ ComfyUI เป็นชั้นเวิร์กโฟลว์ ไม่ใช่โมเดล เสียงจริงอาจถูกสร้างขึ้นโดยผู้ให้บริการแบบโฮสต์ โมเดลเสียงของพาร์ทเนอร์ โหนดกำหนดเองของบุคคลที่สาม หรือระบบที่ติดตั้งในเครื่อง การเข้าใจการแบ่งแยกนี้คือสิ่งที่ทำให้ความคาดหวังของคุณถูกต้อง คุณกำลังประกอบไปป์ไลน์ และคุณยังเป็นผู้เลือกเอนจินภายในนั้น
เวิร์กโฟลว์สี่ขั้นตอนทำงานอย่างไร
ถ้าตัดชื่อโหนดออกไป กราฟเสียงพูด ComfyUI ทุกอันก็ทำสิ่งเดียวกันสี่อย่างตามลำดับ
ขั้นแรก สคริปต์มาถึงในรูปแบบข้อความ โหนด TTS อาจรับข้อความธรรมดาโดยตรง หรือข้อความอาจไหลมาจากโหนดอื่นที่โหลด แปล หรือแบ่งส่วนสคริปต์ที่ยาวกว่า การแบ่งเสียงบรรยายยาวออกเป็นส่วนที่เป็นเหตุเป็นผลช่วยให้คุณสร้างย่อหน้าเดียวใหม่ได้โดยไม่ต้องสร้างเสียงบรรยายทั้งหมดใหม่ และยังช่วยให้คุณอยู่ภายใต้ขีดจำกัดอินพุตของผู้ให้บริการ
ขั้นที่สอง เวิร์กโฟลว์เลือกเสียงพูดและโมเดล ขึ้นอยู่กับผู้ให้บริการ นั่นอาจเป็นผู้พูดที่กำหนดไว้ล่วงหน้า เสียงที่โคลน รหัสเสียง หรือการบันทึกอ้างอิง การเลือกโมเดลยังกำหนดความเร็ว คุณภาพ ช่วงการแสดงออก และต้นทุน ยกตัวอย่างเช่น โหนด HeyGen ของ ComfyUI เปิดเผยทั้ง heygen-voice-1 และ heygen-voice-1-turbo ที่เร็วกว่าและต้นทุนต่ำกว่า ในขณะที่โหนด ElevenLabs แสดงการควบคุมเช่น ความเสถียร ความเร็ว และสไตล์
ขั้นที่สาม โมเดลเสียงพูดสังเคราะห์เสียง ระบบนิวรัลสมัยใหม่ประมาณการออกเสียง จังหวะ การหยุดชั่วคราว และการเคลื่อนไหวของระดับเสียงแทนที่จะเย็บคำที่บันทึกไว้ล่วงหน้าเข้าด้วยกัน และคืนรูปคลื่นที่คุณสามารถส่งต่อได้ บันทึกเป็นไฟล์ ผสมกับเพลง วางลงในกราฟวิดีโอ หรือจับคู่กับอวตาร
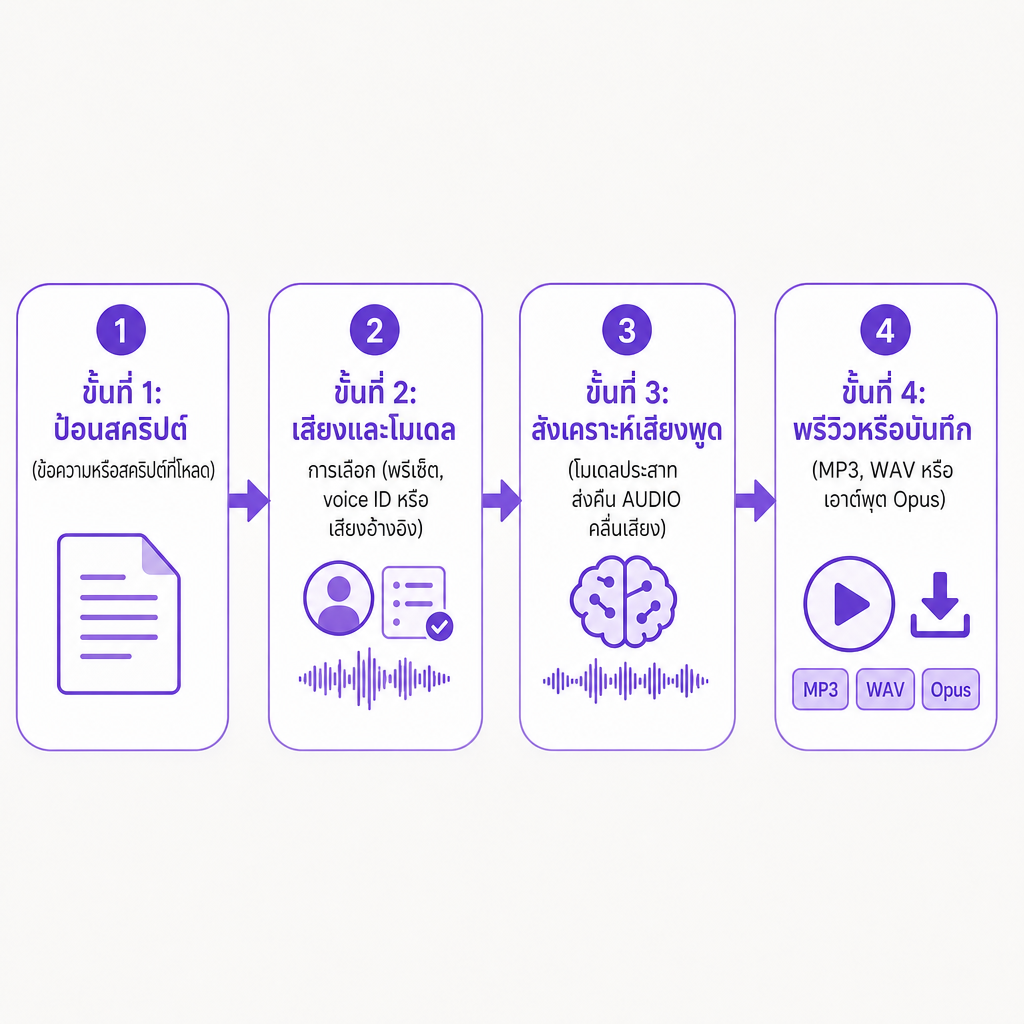
ขั้นที่สี่ เสียงจะถูกแสดงตัวอย่างหรือบันทึก โหนด TTS โดยทั่วไปส่งออกออบเจกต์ AUDIO ที่เชื่อมต่อกับโหนดแสดงตัวอย่างหรือบันทึก โดยรูปแบบไฟล์ถูกกำหนดโดยโหนดและผู้ให้บริการ ตัวอย่างเช่น เอกสารประกอบโหนด ElevenLabs แสดงรายการรูปแบบที่เลือกได้รวมถึง MP3 และ Opus ในหลายแบบ เนื่องจากกราฟเป็นแบบวิชวล การวนลูปจึงง่ายที่จะรันใหม่ เปลี่ยนสคริปต์ เสียง ภาษา หรือโมเดล แล้วเข้าคิวอีกครั้ง
สามวิธีในการรัน TTS ใน ComfyUI
ไม่มีวิธีเสียงพูด ComfyUI แบบเดียว และความแตกต่างมาจากการตั้งค่า การควบคุม ความเป็นส่วนตัว และปริมาณการดูแลรักษาที่คุณยินดีรับผิดชอบ
โหนดผู้ให้บริการแบบโฮสต์ส่งข้อความและการตั้งค่าเสียงของคุณไปยังบริการภายนอกและคืนเสียงที่เสร็จสมบูรณ์ นี่มักเป็นเส้นทางที่เร็วที่สุดสู่เสียงพูดคุณภาพสูงเพราะโมเดลรันบนโครงสร้างพื้นฐานของผู้ให้บริการ โหนด HeyGen Voice 1.0 แสดงรูปแบบนี้ มันต้องการรหัสเสียงที่โคลนมาที่ถูกต้อง ส่งข้อความและรหัสไปยัง HeyGen และคืนเสียงพูด ข้อแลกเปลี่ยนก็คาดเดาได้เช่นกัน เนื่องจากอาจต้องมีบัญชีหรือการเชื่อมต่อ API การใช้งานอาจบริโภคเครดิตของผู้ให้บริการ ข้อความและเสียงของคุณถูกประมวลผลโดยบุคคลที่สาม และขีดจำกัดหรือราคาของผู้ให้บริการอาจเปลี่ยนแปลงได้
โหนดเสียงของพาร์ทเนอร์อย่างเป็นทางการขยายแนวคิดเดียวกันไปทั่วพื้นที่เสียงมากขึ้น เอกสารประกอบเสียงของ ComfyUI แยกการสร้างเสียงจากข้อความออกจากกรณีการใช้งานเสียงและคำพูด รวมถึงเสียงพูดจากข้อความและจากเสียงอ้างอิง การผสานรวมเหล่านี้โดดเด่นเมื่อกราฟของคุณพึ่งพาโมเดลสื่อแบบโฮสต์อื่นๆ อยู่แล้ว เพราะมันลดการสับเปลี่ยนไฟล์ระหว่างแอปพลิเคชันที่แยกกัน
โหนด TTS ของชุมชนและในเครื่องเชื่อมต่อ ComfyUI กับระบบเช่น Edge TTS, Kokoro, Index-TTS และโมเดลอื่นๆ ที่สามารถรันในเครื่องได้ เวิร์กโฟลว์ในเครื่องสามารถให้คุณควบคุมข้อมูลและการเลือกโมเดลได้มากขึ้น แต่มันก็เรียกร้องมากขึ้นเป็นการตอบแทน การติดตั้ง ฮาร์ดแวร์ที่เข้ากันได้ การดาวน์โหลดโมเดล และการแก้ปัญหา โหนดในเครื่องไม่ได้ดีกว่าโหนดแบบโฮสต์โดยอัตโนมัติ ข้อได้เปรียบที่แท้จริงขึ้นอยู่กับว่าเครื่องของคุณสามารถรันโมเดลได้อย่างมีประสิทธิภาพหรือไม่ คุณภาพเสียงยังคงอยู่หรือไม่ ภาษาของคุณได้รับการรองรับหรือไม่ ใบอนุญาตอนุญาตให้ใช้เชิงพาณิชย์หรือไม่ และคุณสามารถรักษาเวิร์กโฟลว์ให้ใช้งานได้ตลอดเวลาหรือไม่
การโคลนเสียงและการควบคุมที่คุณคาดหวังได้
การโคลนเสียงเพิ่มตัวตนอ้างอิงให้กับกราฟแทนที่จะเป็นผู้พูดสำเร็จรูป โครงสร้างมักเป็นสองส่วนที่เชื่อมต่อกัน โหนดการโคลนที่สร้างหรือคืนตัวตนเสียง และโหนด TTS ที่ใช้ตัวตนนั้นเพื่อพูดข้อความใหม่ เอกสารประกอบ HeyGen อธิบายเรื่องนี้โดยตรง โดยที่โหนด Instant Clone สร้าง voice_id ที่ป้อนเข้าสู่โหนด Voice 1.0 Text to Speech เวิร์กโฟลว์การโคลนนั้นต้องการเสียงพูดที่ชัดเจนอย่างน้อย 10 วินาที และโหนด TTS รับได้สูงสุด 5,000 อักขระต่อคำขอ
โคลนเฉพาะเมื่อได้รับอนุญาตเท่านั้น อย่าทำซ้ำเสียงของบุคคลจริงเพียงเพราะคุณสามารถเข้าถึงการบันทึกได้ ขออนุญาต เก็บหลักฐานไว้ และเปิดเผยเสียงที่สังเคราะห์หรือโคลนในทุกบริบทที่อาจทำให้ผู้ชมเข้าใจผิด
นอกเหนือจากตัวเสียงเอง การควบคุมที่คุณจะพบแตกต่างกันไปตามโหนดและโมเดล แต่ชุดที่คุ้นเคยจะปรากฏซ้ำในส่วนใหญ่
- เสียง: ตัวตนผู้พูดหรือค่าที่ตั้งไว้ล่วงหน้า
- ภาษา: ภาษาที่ใช้ในการตีความสคริปต์
- ความเร็ว: ความเร็วในการนำเสนอเสียงบรรยาย
- ระดับเสียง: ความสูงหรือต่ำที่รับรู้ได้ของเสียง
- สไตล์และการแสดงออก: ลักษณะการนำเสนอและความเข้มข้นในการใช้อารมณ์
- ความเสถียร: ความสม่ำเสมอที่เสียงคงคุณลักษณะของมัน
- รูปแบบเอาต์พุต: เช่น MP3, WAV หรือ Opus
- เสียงอ้างอิง: การบันทึกที่ใช้สำหรับการโคลนหรือการแปลงเสียงพูด
บางโมเดลไปไกลกว่าด้วยคิวแบบอินไลน์ เอกสารประกอบโหนด Fish Audio รองรับคิวอารมณ์และแท็กบทสนทนาแบบหลายผู้พูดในโมเดลที่รองรับ มีข้อควรระวังหนึ่งที่ใช้กับทั้งหมด การควบคุมเหล่านี้ไม่สามารถใช้แทนกันระหว่างผู้ให้บริการได้ และการตั้งค่าที่เรียกว่าสไตล์ในโหนดหนึ่งอาจทำงานต่างจากสไตล์ในอีกโหนดหนึ่งอย่างสิ้นเชิง
ComfyUI เทียบกับแพลตฟอร์ม TTS เฉพาะทาง
ComfyUI คุ้มค่าเมื่อเสียงพูดเป็นส่วนหนึ่งของไปป์ไลน์สื่อที่ใหญ่กว่า แพลตฟอร์มเฉพาะทางมักชนะเมื่องานจริงเพียงอย่างเดียวคือการเปลี่ยนสคริปต์ให้เป็นเสียงบรรยายที่ขัดเกลาแล้วโดยไม่ต้องประกอบกราฟ
| ปัจจัยในการตัดสินใจ | ComfyUI | แพลตฟอร์ม TTS เฉพาะทาง |
|---|---|---|
| ความยืดหยุ่นของเวิร์กโฟลว์ | สูง เชื่อมต่อ TTS กับโหนดสื่ออื่นๆ | มักเน้นที่การผลิตเสียงพูด |
| การตั้งค่า | อาจต้องมีโหนด การเชื่อมต่อผู้ให้บริการ หรือการติดตั้งโมเดล | มักเร็วกว่าสำหรับการสร้างครั้งแรก |
| ตัวเลือกเสียง | ขึ้นอยู่กับโหนดที่ติดตั้งหรือเชื่อมต่อ | มักเป็นไลบรารีเสียงที่จัดระเบียบไว้หนึ่งชุด |
| การทำงานอัตโนมัติ | แข็งแกร่งสำหรับกราฟวิชวลที่นำกลับมาใช้ซ้ำได้ | มักผ่าน API หรือเครื่องมือแบบแบตช์ |
| การประมวลผลในเครื่อง | เป็นไปได้ด้วยโหนดและโมเดลในเครื่อง | มักเป็นแบบคลาวด์ |
| กรณีการใช้งานที่ดีที่สุด | ไปป์ไลน์เชิงทดลองหรือมัลติโมดัล | เสียงบรรยายและการผลิตที่ทำซ้ำได้ |
สำหรับครีเอเตอร์ที่สร้างไปป์ไลน์วิชวลที่ผสมผสานเสียงพูดเข้ากับภาพ วิดีโอ หรือการประมวลผลเสียง กราฟก็คุ้มค่ากับตัวมันเอง สำหรับเสียงบรรยาย YouTube เสียงบรรยาย e-learning พอดแคสต์ หรือทีมแปลภาษาที่ต้องการอินเทอร์เฟซที่คาดการณ์ได้ บริการเฉพาะทางมักขจัดภาระทางเทคนิค เวิร์กโฟลว์ Text to Speech ของเราสร้างขึ้นรอบการสร้างเสียงจากสคริปต์โดยตรง ด้วยเสียง AI มากกว่า 300 เสียง การโคลนเสียงใน 33 ภาษา อัตราความเร็วเสียงที่ปรับได้ คิวบทสนทนาทางอารมณ์ และโปรเจกต์ที่ดาวน์โหลดได้ เมื่อการสร้างต้องอยู่ภายในแอปพลิเคชันหรือไปป์ไลน์เนื้อหาอัตโนมัติ Text to Speech API ของเราจัดการด้านการผสานรวม และ AI Dubbing API ของเราขยายแนวคิดเดียวกันไปสู่วิดีโอที่แปลและจับคู่เสียงแล้ว
วิธีเลือกและแก้ปัญหาการตั้งค่าของคุณ
ก่อนตัดสินใจเลือกโหนดหรือโมเดล ให้ทำการตรวจสอบอย่างตั้งใจสองสามอย่างแทนที่จะเชื่อเดโมสั้นๆ
ตัดสินคุณภาพเสียงจากตัวอย่างที่ยาก ไม่ใช่ตัวอย่างที่ง่าย สร้างข้อความที่มีชื่อ ตัวเลข ตัวย่อ ประโยคยาว คำถาม ศัพท์แบรนด์ และอย่างน้อยหนึ่งประโยคที่มีอารมณ์ในภาษาและสำเนียงเป้าหมายของคุณ เสียงที่ทำให้คุณประทับใจในประโยคสั้นๆ อาจออกเสียงชื่อผลิตภัณฑ์ผิดหรือสูญเสียจังหวะตลอดทั้งย่อหน้าได้
ตรวจสอบการรองรับภาษาและสำเนียงเป็นรายภาษา ไม่ใช่โดยรวม บางระบบตรวจจับภาษาโดยอัตโนมัติในขณะที่บางระบบต้องการให้คุณตั้งค่า และเอกสารประกอบโหนด HeyGen แนะนำให้ตั้งค่าภาษาด้วยตนเองสำหรับภาษาที่ใกล้เคียงกันซึ่งการตรวจจับอัตโนมัติอาจไม่น่าเชื่อถือ จำไว้ว่าเสียงที่คล่องแคล่วไม่สามารถกอบกู้การแปลที่ไม่ถูกต้องได้ คุณภาพเสียงและคุณภาพการแปลเป็นปัญหาที่แยกจากกัน
วัดการควบคุมการออกเสียงสำหรับคำที่ทำให้เอนจินสะดุดจริงๆ ชื่อผลิตภัณฑ์ คำนามเฉพาะ ตัวย่อ วันที่ สกุลเงิน และคำศัพท์ทางเทคนิค หากโหนดไม่มีพจนานุกรมการออกเสียงหรือการควบคุมแบบ SSML ให้วางแผนเขียนข้อความใหม่ตามเสียงหรือสะกดตัวเลขออกมา สำหรับซีรีส์หรือช่องที่มีแบรนด์ ยังควรทดสอบความสม่ำเสมอโดยการรันเสียงเดียวกันในหลายการสร้าง โทน และส่วนที่สร้างใหม่ เนื่องจากการรัน ComfyUI แยกกันสำหรับฉากต่างๆ อาจเบี่ยงเบนได้
ชั่งน้ำหนักความหน่วง ต้นทุน ความเป็นส่วนตัว และสิทธิ์ไปพร้อมกัน โหนดแบบโฮสต์เริ่มได้เร็วแต่ขึ้นอยู่กับความเร็วเครือข่าย ความพร้อมของผู้ให้บริการ ขีดจำกัดบัญชี และราคาต่อการใช้งาน ในขณะที่โมเดลในเครื่องหลีกเลี่ยงค่าธรรมเนียมต่อคำขอแต่ต้องการฮาร์ดแวร์และการบำรุงรักษา เปรียบเทียบต้นทุนการผลิตทั้งหมด ไม่ใช่ราคาที่โฆษณา สำหรับความเป็นส่วนตัว ยืนยันว่าอินพุตถูกจัดเก็บอย่างไร เนื้อหาฝึกฝนโมเดลหรือไม่ ข้อมูลเสียงสามารถลบได้หรือไม่ อนุญาตการใช้เชิงพาณิชย์หรือไม่ ใครเป็นเจ้าของเอาต์พุต และเสียงที่โคลนต้องการความยินยอมอะไร
เมื่อกราฟทำงานผิดพลาด ความล้มเหลวจะรวมตัวเป็นรายการสั้นๆ โหนดเสียงที่โคลนแล้วที่คืนข้อผิดพลาดมักมี voice_id ว่างหรือไม่ถูกต้อง โหนด HeyGen หยุดด้วยเหตุผลนั้นพอดี สคริปต์ที่ยาวเกินไปชนขีดจำกัด และโหนด HeyGen Voice 1.0 ตามเอกสารรับได้สูงสุด 5,000 อักขระในขณะที่เตือนว่าเสียงพูดที่ยาวมากอาจล้มเหลว โดยเฉพาะข้อความภาษาจีนหรือญี่ปุ่นที่ยาว ดังนั้นแบ่งเสียงบรรยายออกเป็นส่วนที่เป็นเหตุเป็นผล การออกเสียงผิดมักตอบสนองต่อการเขียนตัวเลขเป็นคำ การเพิ่มเครื่องหมายวรรคตอน หรือการสะกดตัวย่อ เอาต์พุตที่แสดงออกมากเกินไปต้องการการแสดงออก สไตล์ หรือความแปรผันของระดับเสียงที่ต่ำลง และเมื่อเสียงไม่เชื่อมต่อปลายทาง ให้ตรวจสอบประเภท เนื่องจากเอาต์พุต AUDIO ไม่สามารถป้อนให้โหนดที่คาดหวังภาพ วิดีโอ หรือข้อความได้โดยไม่มีขั้นตอนการแปลง สุดท้าย บันทึกกราฟที่สะอาดด้วยโหนดที่มีชื่อและการตั้งค่าที่บันทึกไว้ เพราะผู้ให้บริการ รหัสเสียง ภาษา และรูปแบบเอาต์พุตที่คุณใช้คือรายละเอียดที่ตัวคุณในอนาคตจะต้องการ
คำถามที่พบบ่อย
ComfyUI เป็นเครื่องมือ text-to-speech หรือไม่
ComfyUI เป็นแอปพลิเคชันเวิร์กโฟลว์แบบใช้โหนดมากกว่าจะเป็นเอนจิน TTS เดี่ยวๆ มันสามารถสร้างเสียงพูดผ่านโหนดในตัว การผสานรวมของพาร์ทเนอร์ และโหนด TTS ของชุมชนหรือในเครื่อง
ComfyUI สามารถโคลนเสียงได้หรือไม่
ได้ หากการผสานรวมหรือโหนดกำหนดเองที่เลือกรองรับการโคลน ข้อกำหนดการบันทึกที่แน่นอน กระบวนการรหัสเสียง ขีดจำกัด และเงื่อนไขเชิงพาณิชย์ขึ้นอยู่กับผู้ให้บริการ
ComfyUI text to speech ทำงานแบบออฟไลน์ได้หรือไม่
ได้ เมื่อคุณใช้โมเดล TTS ในเครื่องที่เข้ากันได้และโหนดในเครื่อง โหนดผู้ให้บริการแบบโฮสต์ต้องการการเชื่อมต่ออินเทอร์เน็ตและอาจส่งข้อมูลข้อความหรือเสียงไปยังผู้ให้บริการ
โหนด TTS ของ ComfyUI ที่ดีที่สุดคืออะไร
ไม่มีโหนดที่ดีที่สุดสากล เลือกตามการรองรับภาษา คุณภาพเสียง ความต้องการในการโคลน ความเป็นส่วนตัว ต้นทุน ความหน่วง และความเข้ากันได้กับส่วนที่เหลือของเวิร์กโฟลว์ของคุณ
ฉันสามารถใช้ ComfyUI TTS สำหรับวิดีโอ YouTube ได้หรือไม่
ได้ สร้างเสียงบรรยาย ตรวจสอบการออกเสียงและสิทธิ์ ส่งออกเสียง และซิงค์กับวิดีโอของคุณ หากคุณใช้เสียงที่โคลนหรือสังเคราะห์ ปฏิบัติตามข้อกำหนดความยินยอม การเปิดเผย และแพลตฟอร์มที่เกี่ยวข้อง