Uma API de voz com IA é a conexão programável que permite que seu aplicativo crie, entenda, transforme ou localize áudio falado usando modelos de IA que você não precisa construir por conta própria. Você envia texto, áudio ou vídeo para um endpoint e recebe algo útil de volta: narração sintetizada, uma transcrição, uma voz personalizada ou um vídeo totalmente dublado. A verdadeira pergunta quando você começa não é se você precisa de "voz com IA" — é qual capacidade de voz seu produto realmente exige, porque geração de fala, reconhecimento de fala, clonagem de voz e dublagem são produtos distintos que por acaso compartilham o nome de uma categoria.
Este guia aborda o que o termo significa, os principais tipos de API e como eles diferem, como uma requisição percorre o pipeline, os critérios de decisão que separam uma boa escolha de um erro caro e os riscos que vale a pena gerenciar antes de colocar em produção. É o hub da nossa série para desenvolvedores e APIs, então você encontrará links para os guias de integração mais aprofundados onde forem úteis.
Índice
O que "API de voz com IA" realmente significa
A expressão agrupa três ideias. Voz com IA é a inteligência artificial que trabalha com a fala humana ou gera fala sintética. API é uma interface de programação de aplicações — uma maneira definida para dois sistemas de software trocarem requisições e respostas. A combinação significa que o processamento pesado do modelo acontece do lado do provedor, enquanto o seu aplicativo cuida da experiência do usuário, das suas regras de negócio e do conteúdo final.
Uma requisição pode ser tão simples quanto um pequeno payload JSON com o texto que você quer falado, um identificador de voz e um código de idioma. A resposta normalmente retorna um identificador de projeto, um status de processamento e uma URL para o áudio gerado assim que ele estiver pronto. Para localização de vídeo, a requisição em vez disso referencia um arquivo enviado e uma lista de idiomas de destino.
Essa estrutura é o que separa uma API de um gerador de voz baseado em navegador. Um app web é feito para uma pessoa operar manualmente, um trabalho por vez. Uma API é feita para o software chamar repetidamente, de forma automática e em escala. Se você está produzindo uma narração ocasional, a ferramenta web costuma ser mais rápida. Se você está localizando todos os vídeos que publica, a API é o caminho.
Os cinco principais tipos de API de voz com IA
"API de voz com IA" é uma categoria, não uma única tecnologia. Os cinco tipos comuns recebem entradas diferentes e retornam saídas diferentes, e escolher o errado desperdiça tempo de integração. A tabela abaixo os mapeia para que você possa casar seu material inicial com o resultado que deseja.
| Tipo de API | Entrada | Saída | Uso típico |
|---|---|---|---|
| Texto para fala | Texto escrito | Áudio de fala sintética | Narração, acessibilidade, prompts de app, treinamento |
| Fala para texto | Fala ou vídeo | Transcrição escrita | Legendas, busca, notas de reunião, reaproveitamento |
| Clonagem de voz | Amostra de voz autorizada | Voz sintética personalizada | Vozes de marca, apresentadores recorrentes, narração multilíngue |
| Dublagem com IA | Vídeo ou áudio | Mídia traduzida e dublada | Localização para YouTube, cursos, filmes, podcasts |
| Fala para fala | Fala gravada | Fala transformada ou traduzida | Conversão de voz, produção multilíngue |
A regra de seleção é direta. Se você já tem um roteiro, texto para fala costuma ser o caminho mais simples. Se você tem uma gravação que precisa de uma transcrição, você precisa de fala para texto. Se você quer a mesma identidade de apresentador em vários idiomas, a clonagem de voz ou a dublagem é mais apropriada. Para uma explicação focada apenas no lado do TTS, nosso guia complementar sobre o que é uma API de texto para fala aprofunda-se no pipeline de síntese.
Uma distinção que vale a pena: clonagem de voz não é um alterador de voz. Um alterador de voz transforma uma performance existente no local, enquanto a clonagem cria um modelo de voz reutilizável que gera nova fala a partir de texto ou de outra entrada controlada.
Como uma requisição percorre o pipeline
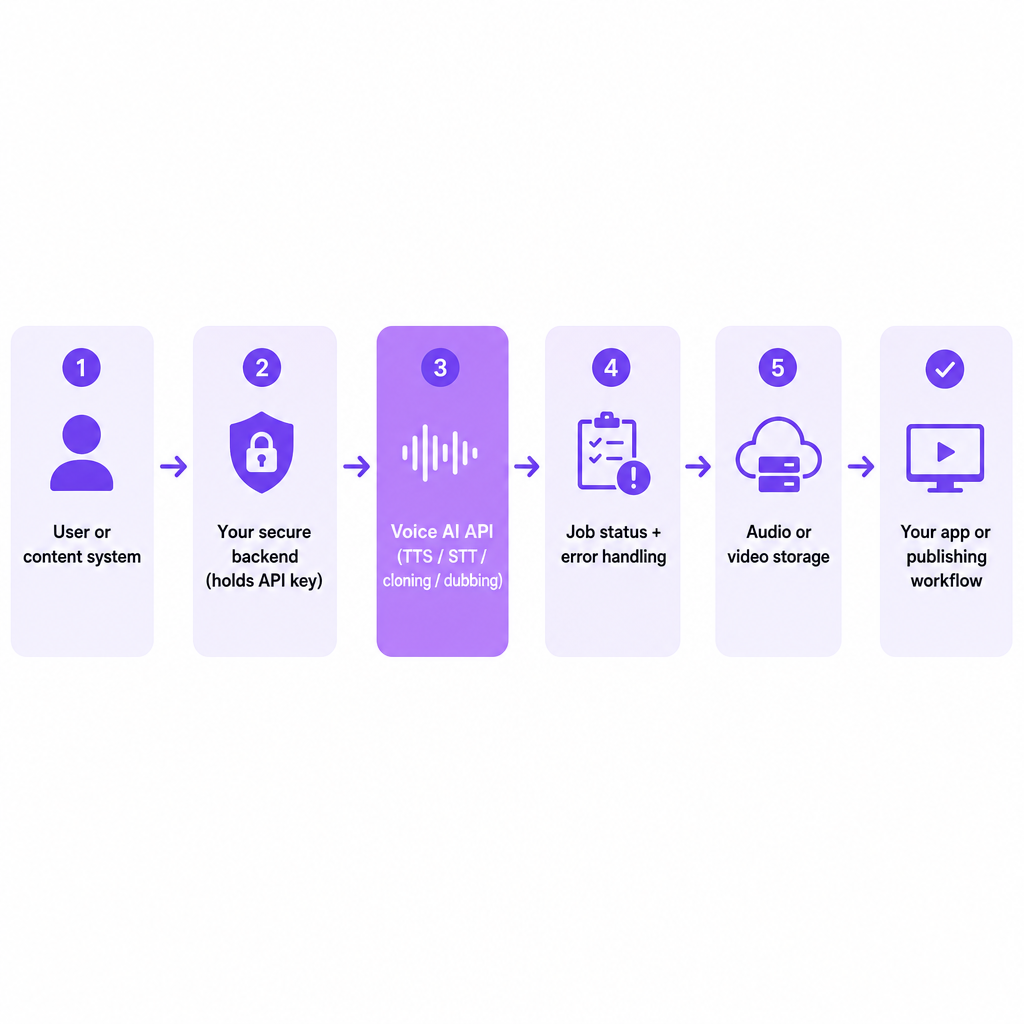
As implementações variam, mas a maioria das APIs de voz segue as mesmas quatro etapas. Entender o formato do fluxo economiza horas de adivinhação quando algo retorna um status inesperado.
Primeiro, seu aplicativo se autentica. Ele envia uma chave de API ou token bearer no cabeçalho da requisição. A API de TTS da DubSmart, por exemplo, usa um endpoint REST com autenticação por token bearer e requisições JSON contra a URL base https://dubsmart.ai/api/v1. Uma regra que importa mais do que parece: nunca coloque uma chave privada em JavaScript do lado do navegador ou em um app móvel distribuído. Armazene-a em um servidor seguro e faça seu cliente chamar esse servidor.
Segundo, seu aplicativo envia conteúdo e configurações. Uma requisição geralmente carrega alguma combinação de texto ou uma referência de arquivo, idioma de origem e destino, um ID de voz, velocidade ou tom, informações do locutor, preferências de saída e metadados do projeto. Para TTS simples, o conteúdo é texto. Para dublagem, a API frequentemente exige primeiro o envio de um vídeo, depois uma requisição separada para criar o projeto.
Terceiro, o serviço processa o conteúdo. Dependendo da tarefa, isso pode significar normalizar e interpretar o texto, prever pronúncia e prosódia, traduzir conteúdo falado, separar locutores ou isolar a fala do áudio de fundo, gerar áudio com uma voz padrão ou personalizada, e sincronizar o resultado com a linha do tempo de um vídeo. Trabalhos mais longos rodam de forma assíncrona: em vez de retornar um arquivo finalizado, a API retorna um ID de projeto.
Quarto, seu aplicativo recupera o resultado — uma URL de áudio ou vídeo, URLs de segmentos individuais, uma transcrição, texto traduzido, dados de temporização e campos de status ou erro. A API de TTS da DubSmart documenta estados de projeto como pending, processing, completed e failed, e projetos concluídos podem retornar URLs de MP3 no nível do projeto ou do segmento.
Síncrono versus assíncrono: a distinção que molda o seu desenvolvimento
A forma como uma API retorna resultados determina como você arquiteta tudo ao seu redor, então decida isso antes de escrever o código de integração.
Uma API síncrona mantém a requisição aberta até o processamento terminar, então retorna o resultado. Isso funciona bem para textos curtos, prompts de voz breves, pequenos trechos de áudio e recursos interativos de baixa latência. Sua fraqueza é que trabalhos longos podem exceder os timeouts da requisição.
Uma API assíncrona retorna um ID de projeto ou tarefa imediatamente. Seu aplicativo então consulta um endpoint de status ou recebe um webhook quando o trabalho termina. Esse modelo é adequado para narrações longas, dublagem de vídeo, múltiplos idiomas de destino, geração em lote e arquivos grandes. Os fluxos documentados de TTS e dublagem da DubSmart usam estados de projeto e recuperação de resultados, o que é um padrão assíncrono feito para trabalhos de mídia.
Quando você avaliar uma opção, verifique se ela suporta webhooks. Consultar a cada poucos segundos é trivial de implementar, mas os webhooks reduzem requisições desnecessárias e escalam melhor quando você está rodando muitos trabalhos de uma vez.
O que avaliar antes de se comprometer
A API certa depende do trabalho, mas um punhado de critérios se aplica a quase todos os projetos. Percorra-os de forma deliberada em vez de confiar em uma demonstração rápida.
Adequação de capacidade. Confirme se a API suporta a tarefa exata — texto para fala, fala para texto, clonagem de voz, dublagem, múltiplos locutores, saída apenas em áudio ou em vídeo, tempo real ou em lote. Não presuma que algo vendido como "voz com IA" inclua todos esses recursos.
Cobertura de idiomas. Verifique os idiomas de origem e de destino. "Suporta 30 idiomas" pode significar 30 vozes de TTS, 30 destinos de tradução ou uma mistura de idiomas e dialetos. Para um canal multilíngue, pese também a qualidade do sotaque, a pronúncia de nomes e lugares, o vocabulário regional, a disponibilidade de vozes por idioma e se uma única voz clonada se mantém em vários idiomas.
Suporte a saída e mídia. Verifique formatos de áudio, contêineres de vídeo, taxa de amostragem e bitrate, downloads em nível de segmento, vídeo renderizado completo, disponibilidade de transcrição ou legenda, e tamanho máximo de arquivo. Esses fatores moldam seu fluxo de trabalho de edição e os custos de armazenamento.
Qualidade e controlabilidade. Escute se há pausas naturais, pronúncia correta, volume estável, identidade consistente do locutor, ênfase apropriada e temporização precisa. Uma voz pode soar impecável numa amostra de dez segundos e tropeçar em termos técnicos, parágrafos longos, números ou nomes incomuns. Teste conteúdo representativo, não o clipe selecionado a dedo pelo fornecedor.
Latência e throughput. Meça o tempo em relação à sua carga de trabalho real. Uma narração curta e centenas de vídeos localizados são problemas diferentes. Pergunte se o processamento é em tempo real ou assíncrono, quais são os limites de taxa, se os trabalhos rodam em paralelo, se existe processamento prioritário e como as falhas são repetidas. A DubSmart afirma que um vídeo típico de cinco minutos leva cerca de um minuto para ser processado, observando que o tempo depende da duração e do tamanho do arquivo.
Modelo de preço. APIs de voz podem cobrar por caracteres, palavras, duração de áudio ou vídeo, créditos, requisições, armazenamento ou trabalhos simultâneos. Para dublagem, o número de idiomas de destino multiplica o custo efetivo. Calcule um fluxo de trabalho completo — repetições, segmentos regenerados, revisão de tradução, armazenamento — não apenas a primeira chamada. Nossa análise sobre preços de API de voz com IA detalha a matemática dos créditos.
Riscos que vale a pena gerenciar cedo
A voz com IA introduz modos de falha que não existem em ferramentas de mídia comuns. Lidar com eles durante o design é muito mais barato do que depois de um erro público.
Uso não autorizado de voz. Clonar a voz de uma pessoa sem permissão cria exposição legal, ética e reputacional. Use um processo de consentimento por escrito que nomeie quem é o dono da gravação, o que pode ser gerado, onde a voz pode ser usada, se o uso comercial é permitido, como a voz é excluída e o que acontece quando o acordo termina.
Tradução ou pronúncia incorreta. A fala gerada pode lidar mal com nomes, siglas, endereços e termos do setor. Mantenha a revisão humana no processo para conteúdo voltado ao público: uma leitura do roteiro traduzido, uma escuta por um falante nativo, verificações pontuais de pronúncia, uma passagem de temporização e movimento labial, e uma revisão final da mídia exportada.
Falsa identidade e fraude. Vozes sintéticas podem ser mal utilizadas para golpes ou endossos falsos. Evite gerar qualquer coisa que possa levar um ouvinte razoável a acreditar que uma pessoa real disse algo que não disse. Para comunicações sensíveis, adicione divulgação, controles de aprovação e registros de auditoria.
Privacidade de voz e dados. Amostras podem conter dados pessoais. Antes de enviar, resolva o consentimento, regras de retenção, restrições de acesso, procedimentos de exclusão, termos de processamento de dados do fornecedor e qualquer política de uso secundário. A DubSmart afirma que os arquivos de clonagem enviados são criptografados e que os usuários podem excluir vozes personalizadas e dados de áudio associados, embora as equipes ainda devam confirmar os termos e controles atuais do seu plano específico.
Mudanças no fornecedor e no modelo. IDs de voz, suporte a idiomas, formatos de saída e limites de taxa podem mudar. Trate a API como uma dependência externa: fixe a configuração onde puder, armazene os roteiros de origem, salve o áudio aprovado, monitore as taxas de erro, mantenha um fluxo de trabalho de fallback e refaça os testes após grandes atualizações do fornecedor. Para equipes que querem menos partes móveis, nosso resumo de ferramentas de vídeo com IA tudo-em-um explica os prós e contras de consolidar essas capacidades.
Quando uma API supera um fluxo de trabalho manual
Uma API de voz com IA justifica seu custo de integração quando você precisa de produção repetível e programática. É uma escolha forte quando um criador publica versões localizadas de todos os vídeos, uma pequena empresa gera narração de produtos em vários idiomas, uma empresa de e-learning atualiza centenas de lições, um podcast lança edições traduzidas, um produto de software adiciona acessibilidade falada ou uma agência integra a geração de voz ao seu sistema de gerenciamento de conteúdo.
Um fluxo de trabalho de estúdio manual ainda pode vencer em casos específicos: quando um projeto depende de uma performance humana altamente matizada, quando a aprovação legal exige um ator profissional, quando o conteúdo traz afirmações sensíveis, quando uma gravação única é mais rápida do que construir uma integração, ou quando o resultado precisa de muita direção artística. O objetivo não é substituir toda voz humana. É automatizar as partes em que consistência, velocidade, escala ou saída multilíngue importam mais.
Para um desenvolvimento pequeno, mantenha a arquitetura simples. Um backend seguro fica entre o seu usuário ou sistema de conteúdo e a API de voz. Esse backend mantém as credenciais privadas, valida a entrada, cria projetos, armazena IDs de tarefas, consulta o status ou recebe webhooks, repete falhas temporárias, salva URLs de resultado e metadados, aplica limites de uso e registra o consentimento para qualquer voz clonada. Uma versão voltada ao criador poderia aceitar um vídeo finalizado em inglês, enviá-lo para um endpoint de dublagem nos idiomas escolhidos, aguardar a conclusão, encaminhar os resultados para uma pasta de revisão e publicar apenas após aprovação.
Onde a DubSmart se encaixa
Nós integramos várias capacidades de API relacionadas à voz em uma única plataforma de mídia com IA, o que importa mais quando você quer conectar geração e localização a um fluxo de trabalho existente em vez de executar cada trabalho manualmente.
Nossa API de Texto para Fala oferece geração programática de fala com vozes neurais, clonagem de voz, suporte multilíngue, rastreamento de status de projeto e resultados em MP3 — sua requisição de exemplo usa segmentos de texto com um ID de voz, idioma, velocidade e tom. Nossa API de Clonagem de Voz segue um padrão de três etapas: solicitar uma URL de upload pré-assinada, enviar uma amostra de áudio e, em seguida, criar uma voz personalizada a partir da chave do arquivo enviado; ela aceita MP3, WAV, AAC, M4A e FLAC, e recomendamos pelo menos 20 segundos de áudio limpo para melhores resultados. Nossa API de Dublagem com IA lida com a localização de vídeo com criação de projeto em múltiplos idiomas, configurações de locutor, segmentos traduzidos e saída dublada para download, aceitando entradas como MP4, MOV, AVI, MKV e WebM de até 5GB.
Se você está avaliando por qual endpoint começar, case-o com o seu conteúdo: narração roteirizada aponta para TTS, uma voz recorrente autorizada aponta para clonagem, e vídeo multilíngue aponta para dublagem.
Perguntas frequentes
O que é uma API de voz com IA em termos simples?
É uma conexão que permite que o software gere, reconheça, clone, traduza ou transforme fala sem construir seu próprio sistema de voz com IA. Seu app envia uma requisição e recebe áudio, texto ou vídeo processado.
Uma API de voz com IA é a mesma coisa que texto para fala?
Não. Texto para fala é um tipo de API de voz com IA. A categoria também inclui reconhecimento de fala, clonagem de voz, dublagem e funções de fala para fala.
Preciso de experiência em programação para usar uma?
Normalmente alguma, porque APIs envolvem autenticação, requisições HTTP, JSON, uploads de arquivos e tratamento de status. Para trabalhos manuais ocasionais, um app web sem código costuma ser mais fácil.
Uma API de voz com IA pode traduzir um vídeo do YouTube?
Uma API de dublagem pode traduzir e gerar novo áudio para um vídeo quando ela suporta os idiomas de origem e destino necessários, o formato de arquivo e o fluxo de trabalho de saída. Revise o resultado antes de publicar.
Posso clonar a voz de qualquer pessoa?
Tecnicamente possível não é o mesmo que legal ou eticamente permitido. Clone uma voz apenas com a permissão apropriada e siga as regras do provedor, seus contratos e os requisitos aplicáveis de privacidade e imagem.