Se você chegou até comfyui text to speech esperando um único botão que transforma um roteiro em áudio, a primeira coisa que vale saber é que o ComfyUI não é um mecanismo de voz. Ele é um espaço de trabalho baseado em nós, onde você conecta texto, uma voz, um modelo, um idioma e uma saída de áudio em um grafo reutilizável. A fala em si vem de qualquer nó TTS que você conectar: um provedor hospedado, uma integração de parceiro oficial ou um modelo local que você mesmo instala. A pergunta que realmente importa, então, não é se o ComfyUI consegue falar o seu roteiro, porque consegue, mas se um grafo visual é o lugar certo para o trabalho que você precisa repetir.
Essa distinção molda todas as outras decisões desta página. O ComfyUI recompensa a experimentação e pipelines multimodais onde a narração fica ao lado da geração de imagem, vídeo e áudio. Uma ferramenta de fala dedicada recompensa a produção repetível, onde você simplesmente precisa de narrações limpas repetidamente. Abaixo, detalhamos como o fluxo de trabalho funciona, quais tipos de opções existem, como julgá-los e onde um grafo deixa de valer a manutenção.
Índice
O que é realmente o text to speech no ComfyUI
O text to speech no ComfyUI é a prática de usar um grafo do ComfyUI para converter texto escrito em uma saída AUDIO. A documentação oficial descreve o ComfyUI como uma aplicação de código aberto, baseada em nós, para construir fluxos de trabalho de geração de imagem, vídeo, áudio e 3D, e seus nós de áudio conectam serviços ou modelos de fala externos a essa mesma tela visual.
Um grafo de fala funcional é pequeno. Ele precisa de uma entrada de texto ou prompt, um nó TTS, uma entrada de voz ou áudio de referência, configurações opcionais de idioma e entrega, e um nó de pré-visualização ou salvamento de áudio. O nó TTS passa seu roteiro por um modelo de fala e retorna o áudio gerado que os nós seguintes podem usar.
A consequência prática é que o ComfyUI é a camada do fluxo de trabalho, não o modelo. A voz em si pode ser produzida por um provedor hospedado, um modelo de áudio parceiro, um nó personalizado de terceiros ou um sistema instalado localmente. Entender essa divisão é o que mantém suas expectativas precisas: você está montando um pipeline, e ainda escolhe o mecanismo dentro dele.
Como funciona o fluxo de trabalho de quatro etapas
Deixando de lado os nomes dos nós, todo grafo de fala do ComfyUI faz as mesmas quatro coisas em sequência.
Primeiro, o roteiro chega como texto. O nó TTS pode receber texto simples diretamente, ou o texto pode fluir de outro nó que carrega, traduz ou segmenta um roteiro mais longo. Dividir uma narração longa em seções lógicas permite regenerar um parágrafo sem reconstruir toda a narração, e ajuda você a ficar abaixo do limite de entrada de um provedor.
Segundo, o fluxo de trabalho seleciona uma voz e um modelo. Dependendo do provedor, isso pode ser um locutor predefinido, uma voz clonada, um ID de voz ou uma gravação de referência. A escolha do modelo também governa velocidade, qualidade, alcance expressivo e custo. O nó HeyGen do ComfyUI, por exemplo, expõe tanto o heygen-voice-1 quanto um heygen-voice-1-turbo mais rápido e de menor custo, enquanto o nó da ElevenLabs disponibiliza controles como estabilidade, velocidade e estilo.
Terceiro, o modelo de fala sintetiza o áudio. Sistemas neurais modernos estimam pronúncia, ritmo, pausas e movimento de tom em vez de juntar palavras pré-gravadas, e retornam uma forma de onda que você pode encaminhar adiante: salva em um arquivo, misturada com música, inserida em um grafo de vídeo ou combinada com um avatar.
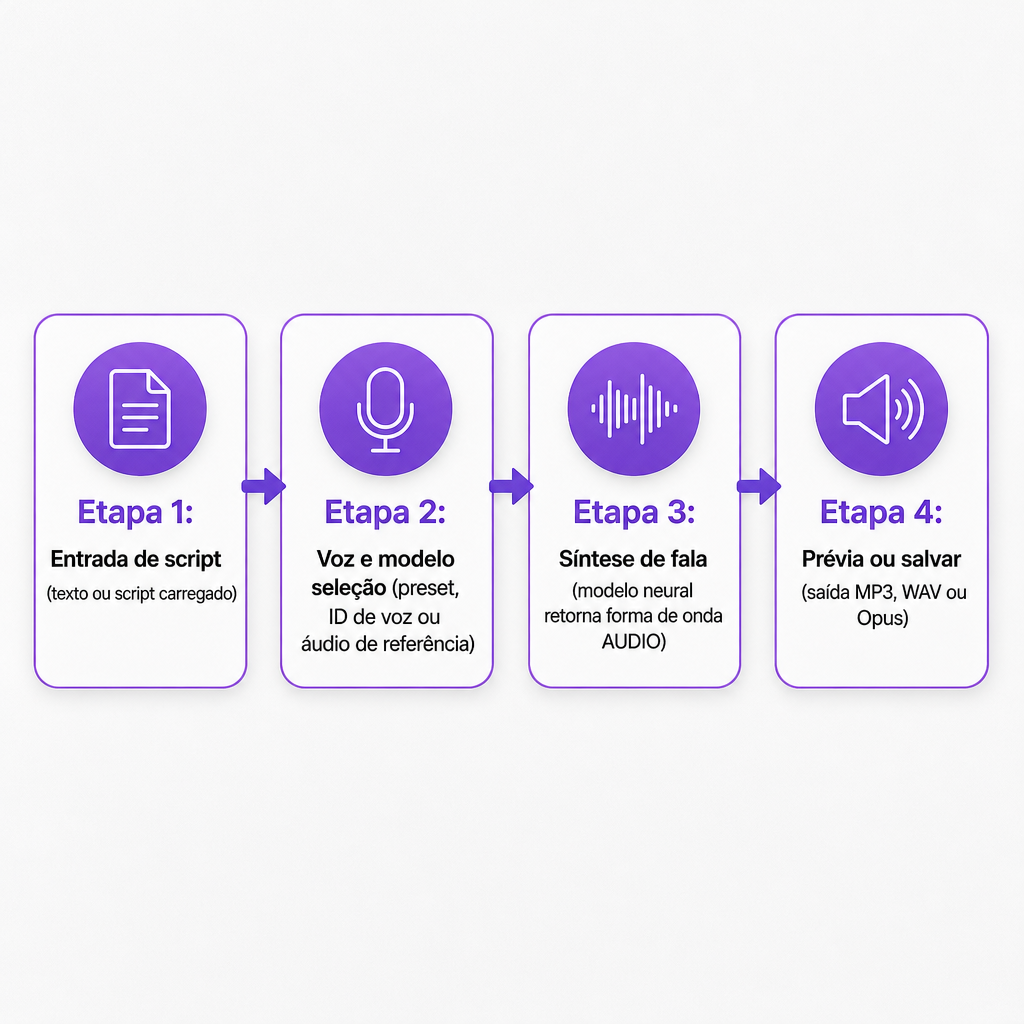
Quarto, o áudio é pré-visualizado ou salvo. Os nós TTS normalmente emitem um objeto AUDIO que se conecta a um nó de pré-visualização ou salvamento, com o formato de arquivo definido pelo nó e pelo provedor; a documentação do nó da ElevenLabs, por exemplo, lista formatos selecionáveis incluindo variantes de MP3 e Opus. Como o grafo é visual, o ciclo é fácil de executar novamente: altere o roteiro, a voz, o idioma ou o modelo e coloque-o na fila de novo.
As três formas de executar TTS no ComfyUI
Não existe um método único de fala no ComfyUI, e as diferenças se resumem à configuração, ao controle, à privacidade e à quantidade de manutenção que você está disposto a assumir.
Os nós de provedor hospedado enviam seu texto e configurações de voz para um serviço externo e retornam o áudio finalizado. Esse costuma ser o caminho mais rápido para uma fala de alta qualidade, porque o modelo roda na infraestrutura do provedor. O nó HeyGen Voice 1.0 ilustra o padrão: ele exige um ID de voz clonada válido, envia o texto e o ID para a HeyGen e retorna a fala. As contrapartidas também são previsíveis, já que uma conta ou conexão de API pode ser necessária, o uso pode consumir créditos do provedor, seu texto e áudio são processados por terceiros, e os limites ou preços do provedor podem mudar.
Os nós de áudio de parceiros oficiais estendem a mesma ideia por mais partes do espaço de áudio. A documentação de áudio do ComfyUI separa a geração de texto para áudio dos casos de uso de voz e fala, incluindo fala a partir de texto e a partir de áudio de referência. Essas integrações se destacam quando seu grafo já depende de outros modelos de mídia hospedados, porque reduzem o trabalho de transferir arquivos entre aplicações separadas.
Os nós de TTS comunitários e locais conectam o ComfyUI a sistemas como Edge TTS, Kokoro, Index-TTS e outros modelos que podem rodar localmente. Os fluxos de trabalho locais podem dar mais controle sobre seus dados e a escolha do modelo, mas exigem mais em troca: instalação, hardware compatível, downloads de modelos e solução de problemas. Um nó local não é automaticamente melhor que um hospedado. Sua real vantagem depende de se sua máquina consegue rodar o modelo com eficiência, se a qualidade da voz se sustenta, se seu idioma é suportado, se a licença permite uso comercial e se você consegue manter o fluxo de trabalho funcionando ao longo do tempo.
Clonagem de voz e os controles que você pode esperar
A clonagem de voz adiciona uma identidade de referência ao grafo em vez de um locutor padrão. A estrutura normalmente tem duas partes conectadas: um nó de clonagem que cria ou retorna uma identidade de voz, e um nó TTS que usa essa identidade para falar um novo texto. A documentação da HeyGen descreve isso diretamente, onde um nó Instant Clone produz um voice_id que alimenta o nó Voice 1.0 Text to Speech; esse fluxo de clonagem pede pelo menos 10 segundos de fala clara, e o nó TTS aceita até 5.000 caracteres por solicitação.
Clone apenas com autorização. Não replique a voz de uma pessoa real simplesmente porque você consegue acessar uma gravação. Obtenha permissão, guarde a prova dela e revele a fala sintética ou clonada sempre que o contexto puder enganar o público.
Além da voz em si, os controles que você vai encontrar variam por nó e modelo, mas um conjunto familiar se repete na maioria deles.
- Voz: a identidade do locutor ou predefinição
- Idioma: o idioma usado para interpretar o roteiro
- Velocidade: a rapidez com que a narração é entregue
- Tom: a altura percebida da voz (grave ou agudo)
- Estilo e expressividade: o caráter da entrega e a intensidade com que a emoção é aplicada
- Estabilidade: o quão consistentemente a voz mantém suas características
- Formato de saída: como MP3, WAV ou Opus
- Áudio de referência: uma gravação usada para clonagem ou transformação de fala
Alguns modelos vão além com marcações embutidas. A documentação do nó Fish Audio suporta marcações de emoção e tags de diálogo com múltiplos locutores em modelos compatíveis. Uma ressalva vale para todos eles: esses controles não são intercambiáveis entre provedores, e uma configuração chamada estilo em um nó pode se comportar de forma totalmente diferente do estilo em outro.
ComfyUI versus uma plataforma TTS dedicada
O ComfyUI justifica seu lugar quando a fala é uma parte de um pipeline de mídia maior. Uma plataforma dedicada tende a vencer quando o único trabalho real é transformar roteiros em narração polida sem montar um grafo.
| Fator de decisão | ComfyUI | Plataforma TTS dedicada |
|---|---|---|
| Flexibilidade do fluxo de trabalho | Alta; conecta o TTS a outros nós de mídia | Normalmente focada na produção de fala |
| Configuração | Pode precisar de nós, links de provedor ou instalações de modelos | Frequentemente mais rápida para a primeira geração |
| Opções de voz | Depende dos nós instalados ou conectados | Normalmente uma biblioteca de vozes organizada |
| Automação | Forte para grafos visuais reutilizáveis | Frequentemente via API ou ferramentas em lote |
| Processamento local | Possível com nós e modelos locais | Normalmente baseada na nuvem |
| Melhor caso de uso | Pipelines experimentais ou multimodais | Narração e produção repetíveis |
Para criadores que constroem um pipeline visual que combina fala com imagens, vídeo ou processamento de áudio, o grafo se paga. Para narração no YouTube, narrações de e-learning, podcasts ou equipes de localização que precisam de uma interface previsível, um serviço especializado normalmente elimina o trabalho técnico. Nosso fluxo de trabalho de Text to Speech é construído em torno da geração direta de roteiro para áudio, com mais de 300 vozes de IA, clonagem de voz em 33 idiomas, taxa de fala ajustável, marcações de diálogo emocional e projetos para download. Quando a geração precisa viver dentro de uma aplicação ou de um pipeline de conteúdo automatizado, nossa API de Text to Speech cuida do lado da integração, e nossa API de Dublagem com IA estende a mesma ideia para vídeo traduzido e com voz correspondente.
Como escolher e solucionar problemas da sua configuração
Antes de se comprometer com um nó ou modelo, faça algumas verificações deliberadas em vez de confiar em uma demonstração curta.
Julgue a qualidade da voz com uma amostra difícil, não com uma fácil. Gere um trecho que inclua nomes, números, siglas, frases longas, perguntas, termos de marca e pelo menos uma linha emocional no seu idioma e sotaque de destino. Uma voz que te encanta em uma frase curta pode estragar o nome de um produto ou perder o ritmo ao longo de um parágrafo.
Verifique o suporte a idioma e sotaque por idioma, não no agregado. Alguns sistemas detectam o idioma automaticamente enquanto outros exigem que você o defina, e a documentação do nó HeyGen recomenda definir o idioma manualmente para idiomas muito próximos, onde a detecção automática pode ser pouco confiável. Lembre-se de que uma voz fluente não pode salvar uma tradução imprecisa; qualidade de voz e qualidade de tradução são problemas separados.
Avalie o controle de pronúncia para as palavras que realmente travam os mecanismos: nomes de produtos, nomes próprios, abreviações, datas, moeda e vocabulário técnico. Se um nó não oferece dicionário de pronúncia ou controles no estilo SSML, planeje reescrever o texto foneticamente ou escrever os números por extenso. Para uma série ou canal de marca, teste também a consistência executando a mesma voz em várias gerações, tons e seções regeradas, já que execuções separadas do ComfyUI para cenas diferentes podem desviar.
Pese latência, custo, privacidade e direitos em conjunto. Os nós hospedados começam rápido, mas dependem da velocidade da rede, da disponibilidade do provedor, dos limites da conta e do preço por uso, enquanto os modelos locais evitam cobranças por solicitação, mas exigem hardware e manutenção; compare o custo total de produção, não a taxa anunciada. Em relação à privacidade, confirme como a entrada é armazenada, se o conteúdo treina o modelo, se os dados de voz podem ser excluídos, se o uso comercial é permitido, quem detém a saída e qual consentimento as vozes clonadas exigem.
Quando um grafo se comporta mal, as falhas se agrupam em uma lista curta. Um nó de voz clonada que retorna um erro frequentemente tem um voice_id vazio ou inválido; o nó HeyGen para exatamente por esse motivo. Roteiros excessivamente longos atingem limites, e o nó HeyGen Voice 1.0 documentado aceita até 5.000 caracteres enquanto alerta que falas muito longas podem falhar, particularmente para texto extenso em chinês ou japonês, então divida a narração em seções lógicas. Pronúncia errada normalmente responde a reescrever números por extenso, adicionar pontuação ou soletrar siglas. Uma saída excessivamente expressiva pede menos expressividade, estilo ou variação de tom. E quando o áudio não se conecta às etapas seguintes, verifique o tipo, já que uma saída AUDIO não pode alimentar um nó que espera uma imagem, vídeo ou texto sem uma etapa de conversão. Por fim, salve um grafo limpo com nós nomeados e configurações registradas, porque o provedor, o ID de voz, o idioma e o formato de saída que você usou são os detalhes de que o seu eu do futuro vai precisar.
Perguntas frequentes
O ComfyUI é uma ferramenta de text to speech?
O ComfyUI é uma aplicação de fluxo de trabalho baseada em nós, em vez de um único mecanismo de TTS. Ele pode gerar fala por meio de nós integrados, integrações de parceiros e nós de TTS comunitários ou locais.
O ComfyUI pode clonar uma voz?
Sim, se a integração selecionada ou o nó personalizado suportar clonagem. Os requisitos exatos de gravação, o processo de ID de voz, os limites e os termos comerciais dependem do provedor.
O text to speech do ComfyUI funciona offline?
Pode funcionar quando você usa um modelo de TTS local compatível e nós locais. Os nós de provedor hospedado exigem conexão com a internet e podem enviar dados de texto ou voz para o provedor.
Qual é o melhor nó de TTS do ComfyUI?
Não existe um nó melhor universal. Escolha com base no suporte a idiomas, na qualidade da voz, nas necessidades de clonagem, na privacidade, no custo, na latência e na compatibilidade com o restante do seu fluxo de trabalho.
Posso usar o TTS do ComfyUI para vídeos do YouTube?
Sim. Gere a narração, revise a pronúncia e os direitos, exporte o áudio e sincronize-o com o seu vídeo. Se você usar uma voz clonada ou sintética, siga os requisitos aplicáveis de consentimento, divulgação e da plataforma.