Głos wiseguy w syntezie mowy to mowa generowana przez AI, zaprojektowana tak, by brzmieć jak dowcipny, pewny siebie, lekko żartobliwy narrator, którego możesz wykorzystywać w filmach, reklamach i materiałach szkoleniowych. To nie jest osobna technologia. To styl lektorski, który budujesz na bazie zwykłej syntezy mowy (TTS) i klonowania głosu: piszesz scenariusz, wybierasz lub tworzysz głos o tej cwaniackiej, obrotnej postawie i generujesz dźwięk, który zachowuje tę samą osobowość w kolejnych materiałach. Dzięki DubSmart AI ta postać wiseguy może pochodzić z gotowego głosu z naszej biblioteki lub z niestandardowego głosu, który sklonujesz z własnych nagrań.
To rozróżnienie ma większe znaczenie niż sama etykieta. Słowo „wiseguy” opisuje ton, a nie przycisk. Wszystko, co sprawia, że głos jest rozpoznawalny, wynika z trzech dźwigni, które kontrolujesz: głosu, który wybierasz, sposobu, w jaki piszesz scenariusz, oraz sposobu, w jaki dostrajasz sposób wypowiedzi. Ten przewodnik wyjaśnia, czym naprawdę jest ten styl, jak nasza synteza mowy go tworzy, jakie są trzy praktyczne sposoby jego zastosowania oraz kiedy żartobliwy narrator pomaga, a kiedy po cichu kosztuje cię zaufanie.
Spis treści
Czy głos wiseguy jest odpowiedni do twojego projektu?
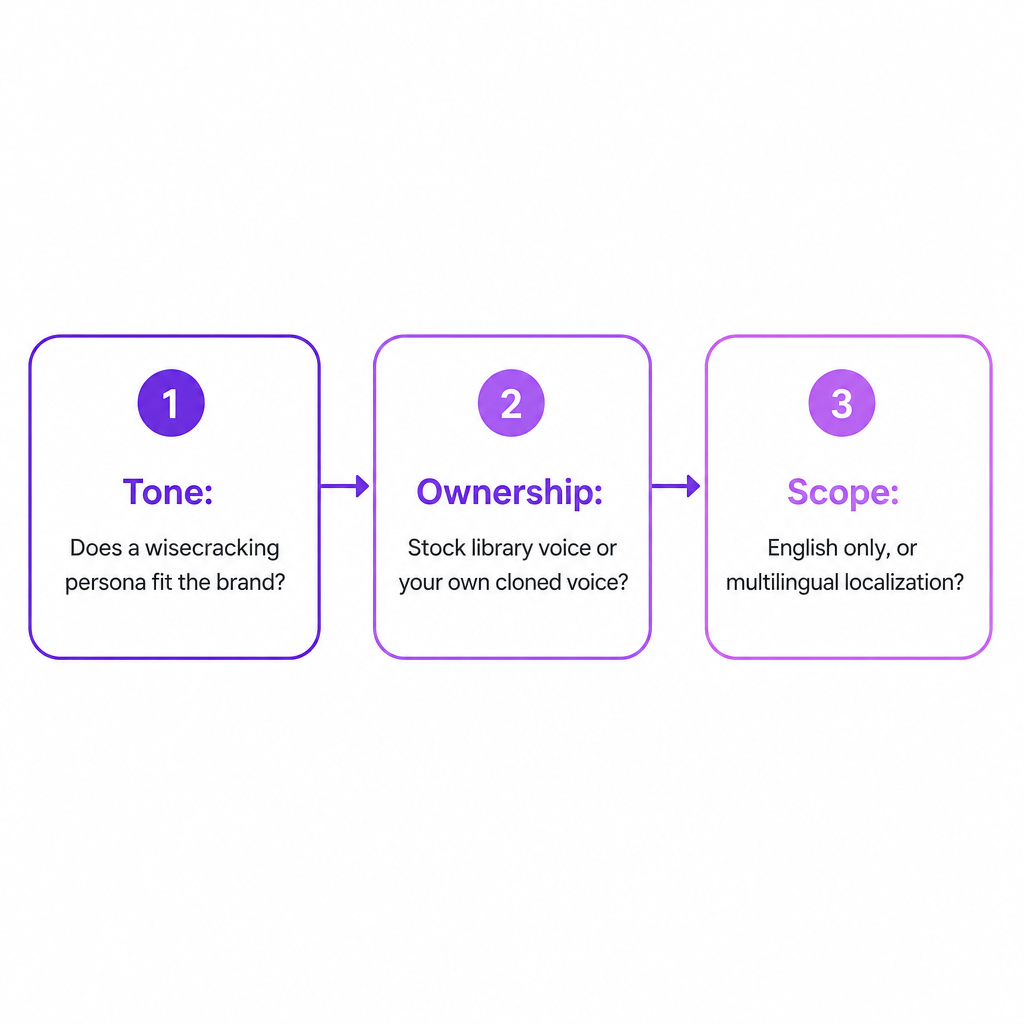
Zanim zaczniesz szukać głosu, rozstrzygnij trzy kwestie, ponieważ decydują one o wszystkim na dalszych etapach.
Pierwsza to ton. Dowcipna, żartobliwa postać może uczynić rozrywkę, treści twórców i nieformalne materiały wyjaśniające bardziej angażującymi. Może też podważyć wiarygodność w przypadku poważnych materiałów. Jeśli twoje treści dotyczą zdrowia, finansów, HR, spraw prawnych lub zgodności z przepisami, przemądrzały narrator działa na twoją niekorzyść.
Druga to własność. Czy chcesz generycznej postaci AI, którą każdy inny również mógłby wybrać, czy głosu, który jest niewątpliwie twój? Głos ze standardowej biblioteki wdraża się szybciej; sklonowany głos daje ci tożsamość wokalną, której żaden konkurent nie może zdjąć z tej samej półki.
Trzecia to zakres. Jeśli dziś potrzebujesz jedynie lektora w języku angielskim, wystarczy pojedynczy wybór głosu. Jeśli planujesz rozwój na inne języki, potrzebujesz postaci, która może podróżować, co skłania cię ku platformie obsługującej wielojęzyczne wyjście bez zmuszania do zmiany narzędzia.
Gdy szczere odpowiedzi brzmią „nasza marka jest żartobliwa”, „chcemy charakterystycznego brzmienia” oraz „będziemy się skalować na wiele języków”, strategia syntezy mowy wiseguy jest rozsądnym długoterminowym zakładem. Jeśli którakolwiek z tych odpowiedzi się zmieni, zawęź plan, zanim zainwestujesz w głos.
Jak nasza synteza mowy tworzy głos w stylu wiseguy
W sercu naszego narzędzia synteza mowy zamieniasz napisany tekst na naturalną, przypominającą ludzką mowę i wybierasz spośród biblioteki ponad 300 głosów obejmujących ponad 33 języki. Ten katalog obejmuje szeroki wachlarz akcentów, płci i tonów, co jest właśnie powodem, dla którego efekt „wiseguy” jest możliwy bez żadnego specjalnego trybu: po prostu wybierasz głos, który już niesie w sobie rozluźnione, pewne siebie odczucie kojarzone z tego rodzaju narratorem.
Praktyczny przebieg jest krótki. Wybierasz głos o odpowiedniej postawie, wprowadzasz tekst w potrzebnym języku i generujesz dźwięk. Stamtąd możesz dostosować tempo, pauzy, a czasem wysokość dźwięku, aby wypowiedź brzmiała nieformalnie i konwersacyjnie, a nie płasko. Wynikiem jest plik audio, który wstawiasz bezpośrednio do swojego montażu, niezależnie od tego, czy jest to publikacja na YouTube, moduł e-learningowy, czy spot marketingowy.
To, co czyni to czymś więcej niż jednorazowym trikiem, to fakt, że DubSmart jest zbudowany jako platforma typu all-in-one. Synteza mowy, klonowanie głosu, dubbing AI, zamiana mowy na tekst, separator mowy, tekst na obraz i obraz na wideo — wszystko to znajduje się w jednym przepływie pracy. Dzięki temu ten sam głos wiseguy może przejść z narracji do dubbingowanej wersji tego samego filmu bez opuszczania narzędzia czy odtwarzania postaci gdzieś indziej.
Trzy sposoby na uruchomienie syntezy mowy wiseguy
Istnieją trzy drogi do tego samego stylu, a różnią się głównie szybkością, własnością i automatyzacją.
Opcja 1: Standardowy głos z biblioteki. Najszybszą drogą jest wybór istniejącego głosu z naszego katalogu ponad 300 głosów. Dla postaci wiseguy szukaj lekko swobodnego lub miejskiego akcentu, średniej wysokości dźwięku, który brzmi pewnie, oraz tempa skłaniającego się ku konwersacji. Ponieważ narzędzie obsługuje treści w ponad 33 językach, możesz teraz uruchomić ten głos po angielsku, a inne języki wdrażać w miarę rozwoju swojego kanału. Ta droga pasuje ci wtedy, gdy potrzebujesz czegoś natychmiast, nie masz nic przeciwko temu, że inni użytkownicy mogliby wybrać ten sam głos, i bardziej zależy ci na tonie i pokryciu językowym niż na unikalnej tożsamości wokalnej.
Opcja 2: Sklonuj własną postać. Jeśli chcesz, aby głos był naprawdę twój, nasze klonowanie głosu buduje syntetyczny model konkretnego mówcy, dzięki czemu nowa mowa może być generowana z tekstu w tym głosie. Nagrywasz około 20 sekund czystej mowy, najlepiej wolnej od szumów tła, i wgrywasz ją do narzędzia klonowania głosu, które przetwarza ją w nazwany niestandardowy profil głosu. Po zakończeniu klonowania ten głos pojawia się obok podstawowej biblioteki zarówno w syntezie mowy, jak i w dubbingu AI, gotowy do przyszłych projektów. Oznacza to, że jedna postać może prowadzić twój angielski komentarz, jego dubbingowane wersje i narrację postaci w modułach szkoleniowych. Wybierz to, gdy twoja marka koncentruje się na rozpoznawalnym prowadzącym, chcesz głosu, do którego nikt inny nie ma dostępu, i możesz nagrać materiał źródłowy oraz zarządzać zgodą mówcy.
Opcja 3: Automatyzacja przez API. Deweloperzy i agencje mogą wpleść ten styl w aplikacje i pipeline'y za pomocą naszego API syntezy mowy, usługi RESTful, w której wysyłasz żądanie POST zawierające twój tekst i preferencje głosu i otrzymujesz naturalnie brzmiącą mowę jako plik audio. Te preferencje mogą odwoływać się do konkretnego ID głosu z biblioteki lub sklonowanego profilu głosu, który utworzyłeś wcześniej. Pozwala to charakterystycznemu narratorowi zasilać automatyczne podsumowania wideo, lektorów samouczków w aplikacji lub dynamiczne teksty marketingowe pobierane z twojego CMS-a. Twój backend po prostu przekazuje tekst i identyfikator głosu do punktu końcowego, a odpowiedź jest strumieniowana lub przechowywana tam, gdzie potrzebuje tego twój produkt. Jeśli lokalizujesz również na dużą skalę, API dubbingu AI i API klonowania głosu rozszerzają tę samą tożsamość na dubbingowane wideo i programistyczne tworzenie niestandardowych głosów.
Co dzieje się pod maską
Niezależnie od tego, czy używasz głosu standardowego, czy sklonowanego, pipeline podąża za tym samym podstawowym wzorcem AI, a jego znajomość pomaga ci osiągać lepsze rezultaty.
Najpierw następuje analiza tekstu. System pobiera twój scenariusz, normalizuje liczby i skróty oraz przewiduje, gdzie powinny padać akcenty i pauzy. Dlatego interpunkcja i długość zdań tak bardzo kształtują sposób wypowiedzi: krótkie, dosadne wersy naturalnie tworzą urwany, pewny siebie rytm, na którym opiera się głos wiseguy.
Następnie jest modelowanie akustyczne. Sieć neuronowa wykorzystuje wybrany profil głosu, aby przewidzieć, jak powinien brzmieć dźwięk w każdej chwili, w tym wysokość, głośność i timing. W przypadku sklonowanego głosu ten model został dostrojony tak, aby odtworzyć charakterystykę konkretnego mówcy; w przypadku głosu standardowego korzystasz z wstępnie wytrenowanego profilu, który już pasuje do określonego stylu.
Na koniec generowanie fali dźwiękowej. Model wokodera zamienia te przewidywania w wysokiej jakości falę dźwiękową, która brzmi jak naturalna ludzka mowa.
Jakość „wiseguy” nie jest ukryta w tej maszynerii. Sterujesz nią za pomocą trzech widocznych dźwigni: wyboru głosu (biblioteka kontra klon), pisania scenariusza (potoczny język i zwięzłe zdania) oraz ustawień wypowiedzi (tempo, pauzy, a czasem wysokość dźwięku). Zmień je, a zmienisz postać.
Kryteria decyzji: kiedy się na to zdecydować, a kiedy wstrzymać
Użyj tych testów, aby zdecydować, jak daleko posunąć postać.
| Czynnik | Postaw na głos wiseguy | Wybierz neutralny głos |
|---|---|---|
| Dopasowanie do marki | Rozrywka, treści twórców, nieformalne materiały wyjaśniające | Zgodność z przepisami, medycyna, prawo, HR |
| Odbiorcy | Młodsi widzowie zżyci z mediami społecznościowymi | Nabywcy korporacyjni, formalne szkolenia |
| Plan językowy | Postać starannie lokalizowana dla każdego rynku | Slang, który nie przetłumaczy się czysto |
| Przepływ pracy | Jedna platforma utrzymuje głos we wszystkich zasobach | Wiele niepowiązanych narzędzi |
| Etap budżetu | Małe eksperymenty przed skalowaniem | Treści o wysokiej stawce bez miejsca na testy |
Rozsądną kolejnością jest najpierw przetestowanie standardowego głosu w stylu wiseguy na małym segmencie twoich odbiorców. Jeśli zaangażowanie się poprawi, a ton pasuje do twojej marki, rozważ sklonowanie własnej postaci dla długoterminowego wyróżnienia. Następnie wykorzystaj wielojęzyczne TTS i dubbing AI, aby powielić tę postać w zlokalizowanych kanałach, utrzymując każdy scenariusz dostrojony kulturowo, a nie tłumaczony słowo po słowie. Ponieważ DubSmart konsoliduje te narzędzia w jednym miejscu, utrzymanie spójnego głosu postaci w narracji i dubbingu nie zmusza cię do żonglowania osobnymi aplikacjami. Model oparty na kredytach z darmowym poziomem daje ci również przestrzeń do eksperymentowania na małą skalę, zanim zwiększysz wykorzystanie.
Ryzyka i zabezpieczenia warte wdrożenia
Ekspresyjny styl głosu niesie ze sobą realne minusy, jeśli wdrażasz go nieostrożnie.
Niedopasowanie do marki jest najczęstszą porażką: nadmiernie sarkastyczna wypowiedź podważa zaufanie w drażliwych tematach. Kolejnym są potknięcia kulturowe, ponieważ humor i postawa „wiseguy” rzadko tłumaczą się dosłownie; to, co w jednym rynku brzmi żartobliwie, w innym może brzmieć niegrzecznie. Prawa do głosu mają największe znaczenie przy klonowaniu. Modeluj głos prawdziwej osoby tylko za wyraźną, udokumentowaną zgodą, co jest kluczowe dla projektów komercyjnych. A syntetyczne głosy mogą być nadużywane do podszywania się lub wprowadzania w błąd, gdy żadna wewnętrzna polityka nimi nie zarządza.
Zabezpieczenia są proste. Napisz wytyczne dotyczące tonu marki, aby postać miała granice. Używaj sklonowanych głosów tylko na podstawie wyraźnych umów z mówcą. Sprawdzaj scenariusze pod kątem wrażliwości kulturowej przed każdym wielojęzycznym wdrożeniem. I trzymaj głosy wiseguy z dala od treści, w których neutralność i autorytet są całym sensem.
Jak różni twórcy wykorzystują to w praktyce
Dla twórców YouTube głos wiseguy dobrze sprawdza się jako powracający narrator kanału do intro, komentarzy i odczytów sponsorskich, podczas gdy twoja obecność przed kamerą pozostaje zarezerwowana dla kluczowych segmentów. Ten sam głos można następnie zdubbingować na inne języki za pomocą zintegrowanych narzędzi. Jeśli planujesz taką ekspansję, nasz materiał wyjaśniający o budowaniu wielojęzycznego kanału na YouTube przeprowadza przez szerszy przepływ pracy.
Dla małych firm i zespołów marketingowych postać nadaje materiałom o produktach i reklamom społecznościowym zapadający w pamięć akcent. Generuj angielskie lektory za pomocą TTS, a następnie lokalizuj kampanie, wykorzystując ponownie ten sam głos lub jego dostrojony kulturowo odpowiednik w innych językach.
Dla producentów e-learningu i szkoleń korporacyjnych zarezerwuj ten styl dla nieformalnych modułów, szybkich wskazówek i elementów zwiększających zaangażowanie, a neutralne głosy zachowaj dla treści dotyczących zgodności i polityki. Ten podział utrzymuje uwagę bez naruszania powagi tam, gdzie ma to znaczenie. Nasz przegląd tego, na czym polega lokalizacja mediów, jest przydatnym wprowadzeniem, jeśli tworzysz wielojęzyczną bibliotekę szkoleniową.
Dla twórców filmów i podcastów sklonowanie głosu konkretnej postaci pozwala mu stać się charakterystyczną obecnością w zwiastunach, teaserach i klipach zza kulis. Dla deweloperów i agencji wpięcie API syntezy mowy w twój pipeline pozwala pojedynczemu narratorowi odczytywać dynamiczne teksty pobierane z baz danych lub treści generowanych przez użytkowników, za każdym razem ze spójną tożsamością.
Najczęściej zadawane pytania
Czym jest synteza mowy wiseguy w DubSmart?
To mowa generowana przez AI, w której wybierasz lub klonujesz głos brzmiący jak dowcipny, pewny siebie narrator, a następnie używasz naszej syntezy mowy, aby zamienić scenariusze na dźwięk w tej postaci. Opiera się na standardowym TTS i klonowaniu głosu, a nie na jakiejkolwiek osobnej technologii.
Czy DubSmart obsługuje głosy wiseguy w wielu językach?
Tak. Nasza synteza mowy i powiązane narzędzia obsługują treści w ponad 33 językach, więc głos w stylu wiseguy może działać w międzynarodowych kanałach. Lokalizuj slang i humor dla każdego rynku, zamiast tłumaczyć je dosłownie.
Czy potrzebuję dużo materiału audio, aby sklonować głos wiseguy?
Nie. Klonowanie głosu jest zaprojektowane tak, aby działać na krótkich nagraniach. Około 20 sekund czystej mowy wystarczy, aby stworzyć niestandardowy profil głosu, którego możesz ponownie użyć zarówno w syntezie mowy, jak i w dubbingu AI.
Czy deweloperzy mogą uruchamiać narrację wiseguy programistycznie?
Tak. Nasze API syntezy mowy przyjmuje żądania POST z tekstem i preferencjami głosu oraz zwraca naturalnie brzmiącą mowę. Możesz odwołać się do głosu standardowego lub sklonowanej postaci po jej ID.
Czy jest niskoryzykowny sposób, by najpierw tego spróbować?
Model oparty na kredytach z darmowym poziomem pozwala przetestować ten styl na przykładowych filmach lub kampaniach przed zaangażowaniem większych budżetów, co odpowiada twórcom, małym firmom i agencjom eksperymentującym z postaciami głosowymi.