Nieruchomy obraz zatrzymuje chwilę, ale nie potrafi pokazać, jak ta chwila się poruszała. To właśnie tę lukę wypełnia AI do zamiany obrazu na wideo. Jeśli zadajesz sobie pytanie, czym jest AI do zamiany obrazu na wideo, krótka odpowiedź brzmi: to technologia generatywnych mediów, która bierze pojedynczy statyczny obraz — zdjęcie, ilustrację, ujęcie produktu lub grafikę wygenerowaną przez AI — i animuje go w krótki klip wideo, wymyślając nowe klatki tworzące pozorny ruch, ruch kamery, a czasem dźwięk. Dostarczasz obraz, opisujesz, co ma się wydarzyć, a model przewiduje i renderuje klatki pośrednie.
Brzmi to prosto, ale decyzja stojąca za tym to nie tylko „czy to narzędzie potrafi stworzyć fajny klip”. Chodzi o to, czy wygenerowany ruch pozostaje wierny źródłu, pasuje do Twojej platformy i przetrwa weryfikację marki lub poprawności. Ten przewodnik wyjaśnia mechanizm, co możesz kontrolować, gdzie to się wpisuje w rzeczywistą produkcję oraz jak obsługujemy Image to Video w ramach DubSmart AI jako jeden etap szerszego procesu medialnego.
Spis treści
Czym AI do zamiany obrazu na wideo różni się od podobnych narzędzi
Zamieszanie zwykle zaczyna się tutaj, ponieważ kilka narzędzi brzmi podobnie, ale wykonuje różne zadania. AI do zamiany obrazu na wideo generuje sekwencję nowych klatek, aby statyczny obraz wyglądał, jakby poruszał się w czasie. Ta jedna różnica odróżnia je od wszystkiego, z czym bywa mylone.
- Tekst na wideo buduje klip wyłącznie z opisu tekstowego, bez obrazu wyjściowego.
- Animacja obrazu stosuje prostsze efekty — zoom, przesunięcie, paralaksę — bez syntezowania naprawdę nowego ruchu obiektu.
- Tworzenie pokazów slajdów przełącza wiele nieruchomych obrazów, ale nigdy nie generuje ciągłego ruchu wewnątrz klatki.
- Wideo na wideo zmienia styl lub edytuje istniejący już materiał, zamiast zaczynać od jednego obrazu.
Zatem pokaz slajdów przechodzący ze zdjęcia A na zdjęcie B nie jest zamianą obrazu na wideo. Nie jest nim też przesunięcie w stylu Kena Burnsa po pojedynczym obrazie. Cechą definiującą jest synteza klatek: model tworzy ruch, który nigdy nie został uchwycony, zakotwiczony w jednej klatce, którą mu dałeś.
Jeśli dubbing, transkrypcja i lokalizacja znajdują się gdzie indziej w Twoim zestawie narzędzi, nasz przewodnik po narzędziach AI do wideo all-in-one według zastosowania pokazuje, gdzie zamiana obrazu na wideo wpisuje się obok tych zadań.
Jak faktycznie działa generowanie
Dostawcy używają różnych modeli, ale proces sprowadza się do czterech połączonych funkcji. Ich zrozumienie tłumaczy, dlaczego niektóre klipy wyglądają płynnie, a inne się zniekształcają.
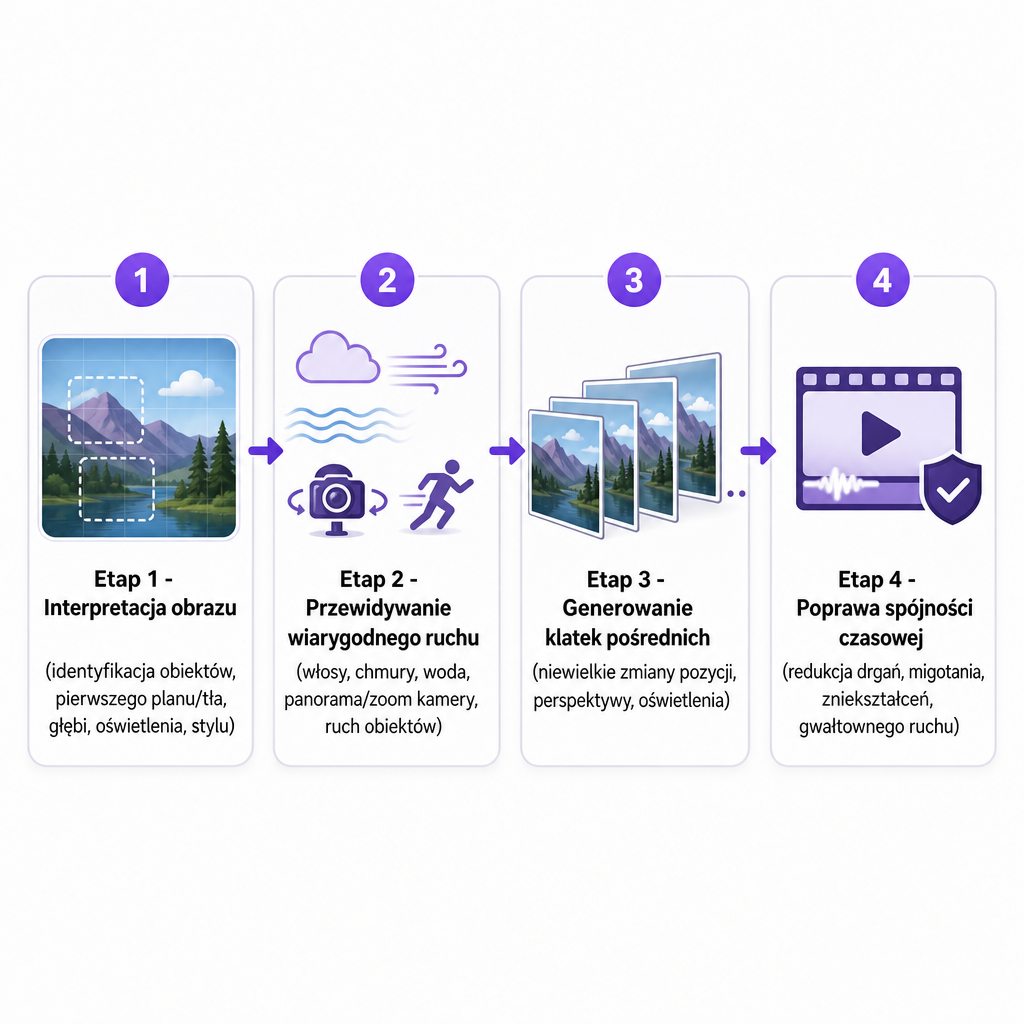
Najpierw interpretuje obraz. Model analizuje przesłany obraz, aby rozpoznać ludzi, zwierzęta, produkty i obiekty, następnie oddziela pierwszy plan od tła i szacuje względne położenie, głębię, oświetlenie i styl wizualny. Obraz staje się roboczą reprezentacją sceny, a nie płaską powierzchnią.
Następnie przewiduje prawdopodobny ruch. Na podstawie tej reprezentacji model szacuje, jak scena mogłaby się zmieniać: jak mogą poruszać się włosy lub tkanina, jak mogą przemieszczać się chmury, dym, woda czy liście, jak światło mogłoby wędrować po obiekcie oraz jak kamera mogłaby przesuwać się, pochylać, przybliżać lub najeżdżać. Te przewidywania nie są nagraniem czegoś, co się wydarzyło. Są wygenerowanymi możliwościami, wynikającymi z obrazu, Twojego polecenia i wzorców wyuczonych podczas treningu.
Potem generuje klatki pośrednie. System renderuje serię klatek z drobnymi zmianami położenia, perspektywy, oświetlenia lub kształtu. Odtwarzane kolejno, klatki te odczytywane są jako ciągły ruch. To właśnie sedno: narzędzie nie ujawnia ukrytego materiału, lecz syntezuje to, co mogłoby pojawić się między chwilami, których nigdy nie nakręcono.
Na koniec udoskonala spójność czasową. W końcu model wygładza przejścia, aby ograniczyć drgania, migotanie, nagłe zmiany oświetlenia, zniekształcone obiekty, niespójne twarze i gwałtowne ruchy kamery. To, jak dobrze mu się to uda, zależy od modelu, obrazu źródłowego, polecenia i złożoności żądanej akcji. Im więcej każesz modelowi wymyślać, tym trudniejszy jest ten etap.
Co możesz kontrolować, a co decyduje obraz źródłowy
Najlepsze wyniki pochodzą z kierowania ruchem, a nie z przepisywania całego obrazu prozą. Niezawodne polecenie nazywa cztery rzeczy: temat, akcję, ruch kamery i styl wizualny.
Ceramiczny kubek do kawy na drewnianym stole, delikatnie unosząca się para, powolny najazd kamery, ciepłe poranne światło, realistyczne wideo produktowe.
Stamtąd możesz zwykle określić ruch obiektu (chodzi, obraca się, rotuje, unosi się), ruch otoczenia (wiatr, deszcz, dym, spadające liście), ruch kamery (przesunięcie, pochylenie, najazd lub oddalenie, z ręki, statyczny), tempo (od łagodnego po szybkie), nastrój (kinowy, dokumentalny, uspokajający) oraz format wyjściowy (poziomy, kwadratowy, pionowy). Zalecamy, aby pierwsze polecenie było proste i skupione na ruchu, którego faktycznie chcesz.
Haczyk polega na tym, że Twoje polecenie musi pasować do tego, co obraz może udźwignąć. Portret zwykle wygląda naturalnie przy subtelnym ruchu twarzy lub kamery, a nienaturalnie, jeśli każesz postaci biec sprintem. Krajobraz często lepiej wypada przy powolnym przesunięciu lub ruchu otoczenia niż przy szybkiej akcji obiektu. Ujęcie produktu zwykle sprzyja kontrolowanej rotacji, muśnięciu światłem lub stopniowemu odsłanianiu. Każdy stopień dramatycznego ruchu zmusza model do wymyślania większej ilości informacji wizualnej — a wymyślanie to miejsce, w którym pojawiają się artefakty.
Dlatego obraz źródłowy niesie tak dużą wagę. Ustala temat, kompozycję, oświetlenie i styl, z których model musi korzystać. Aby uzyskać lepszy efekt, zacznij od wyraźnego, rozpoznawalnego tematu, dobrego oświetlenia, ostrych detali, minimalnej liczby artefaktów, przemyślanej kompozycji, wystarczającej ilości pustej przestrzeni dla pożądanego ruchu oraz wyraźnych warstw pierwszego planu i tła. Zatłoczony, rozmyty lub mocno przycięty obraz daje modelowi mniej do przetworzenia — obraz skadrowany ciasno na twarzy rzadko zostawia miejsce na szeroki ruch kamery. Mocne źródło nie gwarantuje idealnego klipu, ale daje modelowi znacznie lepszy punkt wyjścia. Jeśli tworzysz te nieruchome obrazy od podstaw, nasz generator obrazów AI może je wyprodukować, zanim je zanimujesz.
Gdzie twórcy i zespoły faktycznie z tego korzystają
Zamiana obrazu na wideo zasługuje na swoje miejsce, gdy ruch służy przekazowi, a nie gdy jest ozdobą dla samej ozdoby.
- Media społecznościowe. Zamień zdjęcia, miniatury, ilustracje lub wygenerowane grafiki w krótkie klipy do Shorts, Reels i TikTok. Format pionowy ma największe znaczenie, gdy oryginalny obraz był tworzony z myślą o urządzeniach mobilnych.
- Marketing produktowy. Zanimuj obraz produktu subtelnym zoomem, rotacją, zmianą oświetlenia lub ruchem tła, aby statyczny element wyróżniał się w reklamie.
- YouTube i produkcja wideo. Wykorzystaj klipy jako intra, outra, materiał B-roll, ujęcia ustanawiające, przejścia lub sekwencje tła za narracją — a następnie nałóż na nie lektora, muzykę, napisy lub dubbing.
- E-learning i szkolenia. Dodaj ruch do diagramów, obrazów historycznych i wizualizacji prezentacji, ale tylko tam, gdzie ruch wyjaśnia ideę.
- Storyboarding i prace koncepcyjne. Zanimuj nieruchome obrazy, aby zbadać nastrój, kadrowanie i kierunek kamery, zanim zdecydujesz się na pełną sesję zdjęciową.
- Nieruchomości i podróże. Przekształć dobrze dobrany obraz nieruchomości lub miejsca docelowego w krótki, atmosferyczny klip — bez sugerowania cech, których rzeczywista lokalizacja nie posiada.
W każdym przypadku klip jest składnikiem. Twórca na YouTube może zanimować kilka ilustracji, złożyć je w edytorze, wygenerować narrację i zlokalizować gotowe wideo na inne rynki.
Nasze opcje Image to Video w DubSmart AI
Nasz generator Image to Video wykorzystuje przesłany obraz jako pierwszą klatkę, co utrwala początkową kompozycję i styl wizualny. Dodajesz polecenie tekstowe opisujące ruch obiektu, kąty kamery lub dynamikę sceny, wybierasz czas trwania i jakość oraz pobierasz klip.
| Opcja | Nasza oferta |
|---|---|
| Czas trwania klipu | 4, 6 lub 8 sekund |
| Poziomy jakości | Standard, Wysoka, Bardzo Wysoka |
| Dźwięk | Wysoka i Bardzo Wysoka zawierają dźwięk |
| Formaty poziome | 1280×720 i 1920×1080 |
| Format kwadratowy | 1024×1024 |
| Format pionowy | 720×1280 |
| Dane wejściowe | Obraz wysokiej jakości plus polecenie ruchu |
Zbudowaliśmy to narzędzie z myślą o mediach społecznościowych, reklamie, projektach artystycznych i większych produkcjach wideo. W sprawie konkretnych cen lub zużycia kredytów sprawdź aktualne dane na swoim koncie DubSmart lub w informacjach o planie, zanim zaplanujesz zakres produkcji, ponieważ te szczegóły są powiązane z Twoim planem, a nie z publiczną stroną narzędzia.
Jak wybrać narzędzie do zadania
Właściwe narzędzie zależy od treści, które musisz wyprodukować, a nie od tego, czy potrafi stworzyć jedno imponujące demo. Kilka kryteriów oddziela nowinkę od czegoś, co możesz wykorzystać w powtarzalnym procesie.
Kontrola obrazu źródłowego. Sprawdź, czy narzędzie traktuje Twój obraz jako ścisłą pierwszą klatkę, luźne odniesienie czy jedynie wskazówkę stylistyczną. Podejście z pierwszą klatką utrzymuje początkową kompozycję powiązaną z Twoim źródłem — przydatne, gdy ujęcie początkowe ma znaczenie.
Kontrola ruchu. Szukaj wyraźnego wsparcia dla ruchu obiektu, ruchu kamery, efektów otoczenia, prędkości i stylu. Atrakcyjny, ale nieprzewidywalny ruch jest trudny do odtworzenia, gdy potrzebujesz spójności w kilku klipach.
Czas trwania i formaty. Dopasuj dostępne długości i proporcje do miejsca docelowego. Krótkie klipy pasują do postów w mediach społecznościowych, reklam, przejść i wstawek; upewnij się, że opcje pionowe, kwadratowe i poziome odpowiadają miejscu, w którym klip będzie emitowany.
Dźwięk. Zdecyduj, czy potrzebujesz cichego materiału wizualnego do późniejszej edycji, dźwięku otoczenia, muzyki, efektów czy w pełni wygenerowanej ścieżki. Wygenerowany dźwięk nadal powinien zostać sprawdzony pod kątem synchronizacji i trafności przed emisją.
Spójność. Jeśli twarz, produkt, logo lub postać musi pozostać identyczna przez cały czas, najpierw przetestuj kilka generacji. Modele mogą po cichu zmieniać drobne szczegóły — dłonie, tekst wewnątrz obrazu, loga, linie architektoniczne — podczas syntezowania klatek.
Kompatybilność z edycją. Upewnij się, że możesz pobrać praktyczny format w odpowiedniej rozdzielczości, połączyć go z materiałem aktorskim oraz dodać napisy, narrację lub dubbing bez utraty kadru, którego potrzebuje Twój montażysta. Dla zespołów, które już produkują z nami media głosowe i zlokalizowane, Image to Video wpisuje się w jeden proces, zamiast dodawać kolejne samodzielne narzędzie.
Ograniczenia, ryzyka i prawa, których nie możesz pominąć
AI do zamiany obrazu na wideo nie rekonstruuje prawdziwego materiału z nieruchomego obrazu. Generuje prawdopodobną interpretację ruchu, a ta różnica napędza każde ograniczenie, które warto uwzględnić w planowaniu.
Twarze, palce, tekst, loga i detale produktów mogą zmieniać się między klatkami, więc przejrzyj cały klip, zamiast oceniać po pierwszym podglądzie. Model może też błędnie odczytać głębię, granice obiektów lub związek przyczynowo-skutkowy — tworząc nienaturalny ruch, wyginające się obiekty lub ruch kamery, który ujawnia wymyślony detal. Niejasne polecenia w stylu „spraw, żeby się ruszało” dają niemal żadnego kierunku; konkretne opisy tematu, ruchu, kamery i nastroju prowadzą model znacznie lepiej. A ponieważ technologia jest najmocniejsza przy krótkich klipach, wygenerowana sekwencja dobrze sprawdza się jako wstawka lub materiał do mediów społecznościowych, ale nie zastąpi kompletnej nakręconej sceny.
Ryzyka, które mają największe znaczenie, są etyczne i prawne. Wygenerowany klip nigdy nie powinien sugerować, że dana osoba wykonała jakąś czynność, że produkt ma jakąś funkcję lub że prawdziwe miejsce się zmieniło, gdy nic takiego się nie wydarzyło — to granica, która ma szczególne znaczenie w reklamie, wiadomościach, edukacji i komunikacji z klientami. Jeśli chodzi o prawa, używaj wyłącznie obrazów, które masz pozwolenie przetwarzać i publikować, oraz zachowaj ostrożność w przypadku zdjęć rozpoznawalnych osób, zasobów marki, dzieł objętych prawami autorskimi, materiałów należących do klientów, informacji prywatnych, wizerunków celebrytów oraz obrazów wygenerowanych przez AI o niepewnych warunkach użytkowania. Przekształcenie danych wejściowych nie nadaje Ci praw do tych danych ani do powstałego wideo.
Najczęściej zadawane pytania
Czym jest AI do zamiany obrazu na wideo w prostych słowach?
To oprogramowanie AI, które zamienia nieruchomy obraz w krótkie ruchome wideo, generując nowe klatki na podstawie obrazu i podanej przez Ciebie instrukcji ruchu.
Czy AI do zamiany obrazu na wideo może dodać dźwięk?
Niektóre narzędzia generują dźwięk, podczas gdy inne tworzą ciche wideo do późniejszej edycji. Nasze opcje jakości Wysoka i Bardzo Wysoka zawierają dźwięk; przed publikacją sprawdź wygenerowany dźwięk pod kątem synchronizacji i trafności.
Które obrazy sprawdzają się najlepiej?
Wyraźne, dobrze oświetlone obrazy z rozpoznawalnym tematem, wyraźnymi obszarami pierwszego planu i tła, ostrymi detalami i minimalną liczbą artefaktów dają modelowi lepszy punkt wyjścia niż zatłoczone lub rozmyte źródła.
Jak długie są klipy image-to-video w DubSmart AI?
Oferujemy czasy trwania 4, 6 i 8 sekund, w formatach poziomym, kwadratowym i pionowym.
Czy mogę tworzyć pionowe wideo na TikTok lub YouTube Shorts?
Tak. Oferujemy format pionowy 720×1280 obok rozdzielczości kwadratowych i poziomych, dzięki czemu klipy pasują do platform mobilnych.
Czy AI do zamiany obrazu na wideo nadaje się do treści biznesowych?
Może sprawdzić się w reklamach, wizualizacjach produktów, szkoleniach, treściach społecznościowych i rozwoju koncepcji, pod warunkiem że przed publikacją sprawdzisz efekt pod kątem poprawności, spójności marki, praw, zgody i wszelkich wprowadzających w błąd twierdzeń wizualnych.