API klonowania głosu to interfejs dla programistów, który zamienia dozwoloną próbkę dźwięku w wielokrotnego użytku syntetyczny głos, dzięki czemu aplikacja może przesłać tekst — lub uruchomić automatyczne zadanie dubbingu — i otrzymać w zamian nową mowę przypominającą oryginalnego mówcę. Zamiast wybierać stały głos z katalogu, Twój kod tworzy tożsamość głosu powiązaną z unikalnym identyfikatorem, a następnie wykorzystuje ją ponownie w różnych skryptach, produktach i językach. Ta jedna zmiana — od wybierania głosu do programowego posiadania go — sprawia, że ta technologia jest interesująca dla twórców, marek i programistów budujących rozwiązania na dużą skalę.
Krótka odpowiedź na pytanie czym jest API klonowania głosu brzmi tak: udostępnia ono trzy połączone funkcje — przesyłanie dźwięku, tworzenie głosu i generowanie głosu — jako punkty końcowe, które może wywoływać Twoje oprogramowanie. Zrozumienie, jak te elementy pasują do siebie, odróżnia płynny potok produkcyjny od frustrującego, dlatego reszta tego wyjaśnienia omawia mechanizm, kompromisy oraz kwestie praw, które musisz rozstrzygnąć, zanim choć jeden plik trafi do użytku.
Spis treści
Co faktycznie robi API klonowania głosu
API klonowania głosu udostępnia klonowanie jako usługę programowalną, a nie jako ręczną funkcję ukrytą w edytorze dźwięku lub panelu internetowym. Twoja aplikacja przesyła próbkę, dostawca przekształca ją w niestandardowy głos z własnym identyfikatorem, i od tej chwili ten identyfikator staje się uchwytem, który przekazujesz do żądań zamiany tekstu na mowę lub dubbingu.
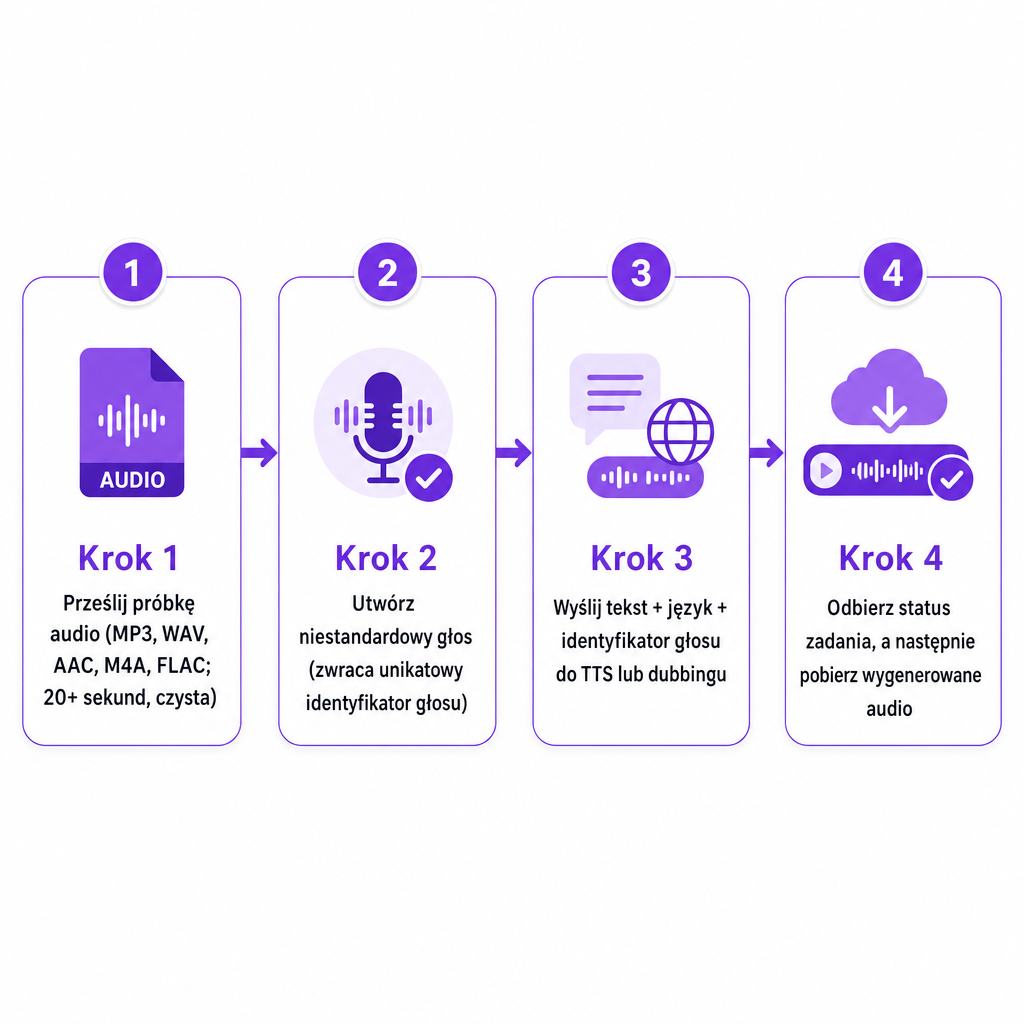
Schemat jest spójny u różnych dostawców: próbka dźwięku staje się niestandardowym identyfikatorem głosu, który staje się nową mową z tekstu lub przetłumaczonego skryptu, który staje się gotowym plikiem dźwiękowym. Praca uczenia maszynowego — analiza tonu, wzorców wymowy, zakresu wysokości dźwięku, rytmu i barwy — odbywa się za punktem końcowym, a powstały model głosu może wypowiadać zupełnie nowy skrypt, zachowując rozpoznawalne cechy mówcy referencyjnego.
Jedno rozróżnienie jest ważniejsze niż wszystkie inne. API nie odtwarza oryginalnego nagrania; syntezuje świeżą mowę. Sklonowany głos może wypowiadać słowa, których nigdy nie było w źródłowej próbce, co jest dokładnie powodem, dla którego jest potężny i dlaczego niesie ze sobą odpowiedzialność.
Jak działa klonowanie głosu za kulisami API
Dostawcy wdrażają model w różny sposób, ale większość systemów dzieli te same szerokie etapy, a ich znajomość pomaga zaprojektować niezawodną integrację.
Po pierwsze, system otrzymuje próbkę głosu. Programiści zazwyczaj przesyłają ją za pomocą podpisanego adresu URL przesyłania, który pozwala aplikacji wysłać plik bezpośrednio do magazynu zamiast upychania dużego ładunku dźwiękowego wewnątrz żądania tworzenia głosu. Czysty dźwięk źródłowy jest tutaj ważny, ponieważ model może nauczyć się niechcianych dźwięków wraz z mówcą: muzyka, echo pomieszczenia, wielu nakładających się mówców, zniekształcenia i agresywna redukcja szumów — wszystko to zmniejsza spójność klona. Nasze API klonowania głosu dokumentuje obsługę formatów MP3, WAV, AAC, M4A i FLAC oraz zaleca co najmniej 20 sekund dźwięku bez szumów tła dla najlepszego rezultatu.
Po drugie, dostawca tworzy niestandardowy głos. Po przesłaniu aplikacja przekazuje lokalizację zapisanego pliku i nazwę, a usługa zwraca obiekt głosu z identyfikatorem. Ten identyfikator jest kluczem do wszystkiego, co następuje później — Twoja aplikacja przechowuje go obok rekordu użytkownika, projektu, postaci lub marki we własnej bazie danych. Nasza dokumentacja stosuje ten schemat z punktem końcowym tworzenia, a także punktami końcowymi do wyświetlania listy niestandardowych głosów z paginacją oraz do usuwania niestandardowego głosu według identyfikatora.
Po trzecie, aplikacja generuje nową mowę. Gdy niestandardowy głos już istnieje, Twój kod wysyła tekst, język i identyfikator niestandardowego głosu do punktu końcowego zamiany tekstu na mowę. Usługa zwraca identyfikator projektu lub zadania; aplikacja następnie odpytuje status zadania, aż przetwarzanie zostanie zakończone, i pobiera powstały adres URL dźwięku. Nasze API TTS dokumentuje generowanie oparte na projektach ze statusami oczekujący, przetwarzanie, zakończony i nieudany oraz udostępnia wartości głosu, języka, prędkości i wysokości dźwięku na poziomie poszczególnych segmentów.
Jeśli chcesz poznać głębszą mechanikę strony generowania, nasze wyjaśnienie dotyczące czym jest API zamiany tekstu na mowę i jak działa rozkłada na części potok syntezy, który ostatecznie napędza sklonowany głos.
API klonowania głosu a API zamiany tekstu na mowę i API dubbingu
Te trzy API są powiązane, ale rozwiązują różne problemy, a mylenie ich prowadzi do niewłaściwej architektury.
| Typ API | Główne dane wejściowe | Główne dane wyjściowe | Najlepiej dopasowane do |
|---|---|---|---|
| API zamiany tekstu na mowę | Tekst plus wybrany głos | Syntetyczna mowa | Narracja, powiadomienia, asystenci, dźwięk ze skryptu |
| API klonowania głosu | Próbka dźwięku | Niestandardowy identyfikator głosu | Tworzenie wielokrotnego użytku tożsamości głosu |
| API dubbingu AI | Wideo lub dźwięk plus ustawienia języka | Przetłumaczone, dubbingowane media | Wielojęzyczna lokalizacja wideo i dźwięku |
W praktyce API klonowania głosu rzadko działa samodzielnie. Punkt końcowy klonowania tworzy głos; punkt końcowy zamiany tekstu na mowę używa tego identyfikatora głosu do wypowiadania nowego tekstu. Ten sam identyfikator głosu może również przepływać do przepływu pracy dubbingu, gdzie system tłumaczy oryginalny dialog i generuje przetłumaczone wykonanie w wybranym niestandardowym głosie. Opisujemy nasze niestandardowe głosy jako możliwe do użycia zarówno w projektach TTS, jak i AI Dubbing, co pozwala jednej 20-sekundowej próbce służyć narracji i lokalizacji z tej samej tożsamości. Aby poznać architekturę specyficzną dla dubbingu, zobacz nasze towarzyszące wyjaśnienie dotyczące czym jest API dubbingu AI, a dla szerszej rodziny punktów końcowych głosu — nasz przewodnik dotyczący czym jest API głosowe AI.
Co możesz z nim zbudować
API klonowania głosu zyskuje na znaczeniu, gdy ten sam głos musi być generowany wielokrotnie, w wielu skryptach, produktach lub językach. Kilka konkretnych wzorców pokazuje, gdzie pasuje.
Twórca na YouTube może nagrać jedną próbkę głosu i wykorzystać powstały głos do zlokalizowanych wersji filmów, generując narrację dla różnych rynków językowych bez ponownego nagrywania każdego skryptu. Klon nie eliminuje potrzeby weryfikacji tłumaczenia — nazwy, idiomy, żarty i odniesienia kulturowe nadal wymagają sprawdzenia przez człowieka — ale eliminuje wąskie gardło nagrywania.
Firma może stworzyć spójnego narratora do objaśnień produktów, filmów wprowadzających, reklam i treści pomocy, zamiast przypisywać inny głos do każdej kampanii. Praktycznym krokiem przed produkcją jest polityka użycia głosu: które działy mogą używać głosu, które treści wymagają zatwierdzenia i czy syntetyczna narracja musi być ujawniana.
Zespoły szkoleniowe zyskują możliwość szybkiego aktualizowania lekcji, gdy zmieni się polityka, szczegół produktu lub procedura, zachowując ciągłość w dużej bibliotece kursów. W przypadku wrażliwych tematów weryfikacja przez człowieka pozostaje niezbędna, ponieważ wygenerowany głos brzmi pewnie nawet wtedy, gdy skrypt jest błędny. Producenci podcastów mogą utrzymać spójny głos prowadzącego lub postaci dla intro, poprawek, podsumowań lub edycji w innych językach, co jest przydatne, gdy drobna edycja w przeciwnym razie wymagałaby zupełnie nowej sesji. A programiści budujący gry, aplikacje edukacyjne, narzędzia dostępności lub doświadczenia z przewodnikiem mogą uczynić głos częścią istniejącego przepływu pracy zamiast ręcznego eksportowania dźwięku dla każdej odpowiedzi.
Jak oceniać API klonowania głosu
Właściwy dostawca zależy od Twoich wymagań produkcyjnych, a nie od tego, jak dopracowane brzmi pojedyncze demo. Przepracuj poniższe wymiary, zanim się zdecydujesz.
Wymagania dotyczące danych wejściowych dźwięku. Potwierdź obsługiwane formaty plików, minimalną lub zalecaną długość próbki, czy wielu mówców jest odrzucanych, jak obsługiwany jest szum tła, czy przesyłanie jest akceptowane bezpośrednio oraz czy pliki referencyjne można usunąć po klonowaniu. Jako obsługiwane formaty wymieniamy MP3, WAV, AAC, M4A i FLAC oraz zalecamy czystą próbkę o długości co najmniej 20 sekund.
Jakość i spójność głosu. Przetestuj głos więcej niż jednym zdaniem. Uwzględnij krótkie i długie zdania, liczby i daty, nazwy własne, pytania i wykrzyknienia, słownictwo techniczne oraz słowa trudne do wymówienia. Klon, który czaruje w krótkim demo, może błądzić w długiej narracji lub nieznanym języku.
Obsługa języków i lokalizacji. Jeśli celem jest wyjście wielojęzyczne, zweryfikuj obsługiwane języki źródłowe i docelowe, czy niestandardowy głos może mówić każdym z nich, zachowanie akcentu i wymowy oraz czy głos pozostaje rozpoznawalny w różnych językach. Nasze API TTS publicznie podaje ponad 300 głosów AI w ponad 33 językach i dialektach, w tym angielskim, portugalskim, hiszpańskim, francuskim, niemieckim, chińskim i japońskim. Nie publikujemy pełnego katalogu języków na tej stronie, więc potwierdź dokładną kombinację głosu i języka przed zablokowaniem przepływu pracy produkcyjnej.
Architektura API. Gotowe do produkcji API powinno zapewniać przewidywalną obsługę uwierzytelniania, przesyłania, tworzenia głosu, wyświetlania listy, usuwania, statusu projektu, ponownych prób, błędów walidacji, paginacji, pobierania dźwięku i monitorowania użycia. W naszych przykładach pokazujemy uwierzytelnianie za pomocą tokena Bearer i dokumentujemy zarówno punkty końcowe zarządzania głosem, jak i przetwarzanie TTS oparte na projektach.
Generowanie synchroniczne a asynchroniczne. Krótkie żądania mogą być zwracane szybko, ale dłuższe treści lepiej obsługiwać jako zadanie: wyślij żądanie, otrzymaj identyfikator zadania, odpytaj lub otrzymaj status, a następnie pobierz dźwięk. Projekt asynchroniczny zapobiega przekroczeniu limitu czasu żądania internetowego podczas renderowania długiej narracji lub dużej partii segmentów. Nasza dokumentacja TTS używa statusów projektu i wartości postępu, a ukończony projekt zwraca adres URL dźwięku wraz z adresami URL dźwięku dla poszczególnych segmentów.
Kontrola danych wyjściowych i edycji. Sprawdź format i jakość danych wyjściowych, czy częstotliwość próbkowania jest konfigurowalna, czy prędkość i wysokość dźwięku można dostosować, czy poszczególne segmenty można pobierać, czy nieudany segment można ponownie wygenerować bez ponownego uruchamiania całego projektu oraz czy adresy URL dźwięku są tymczasowe czy stałe. Dokumentujemy wyjście MP3 w 22 kHz dla API TTS i udostępniamy kontrolę prędkości i wysokości dźwięku na poziomie segmentów.
Kontrola usuwania i danych. Dostawca powinien umożliwiać usunięcie przesłanego dźwięku referencyjnego, wygenerowanego niestandardowego głosu, wygenerowanych plików dźwiękowych oraz powiązanych danych projektu. Nasze API klonowania głosu zawiera punkt końcowy usuwania dla niestandardowych głosów i stwierdza, że użytkownicy mogą usuwać niestandardowe głosy i powiązany dźwięk. Zapoznaj się z aktualnymi warunkami prywatności i zobowiązaniami dotyczącymi przechowywania przed przesłaniem poufnych lub wrażliwych handlowo nagrań.
Prawa, podszywanie się i odpowiedzialne użytkowanie
Klonowanie głosu jest decyzją dotyczącą praw, prywatności i podszywania się w takim samym stopniu, jak techniczną, a traktowanie go wyłącznie jako kodu to sposób, w jaki zespoły wpadają w kłopoty.
Zacznij od zgody. Używaj nagrania tylko wtedy, gdy masz prawo do sklonowania i wykorzystania głosu tego mówcy. W przypadku przepływu pracy biznesowej pisemna zgoda powinna obejmować tworzenie syntetycznego głosu, użycie komercyjne, języki i terytoria, czas trwania licencji, treści reklamowe i polityczne, zastosowania szkoleniowe i obsługi klienta, czy głos może być sublicencjonowany oraz sposób jego usunięcia lub wycofania. Znalezienie nagrania online nie daje Ci prawa do jego sklonowania.
Chroń się przed podszywaniem, ponieważ syntetyczny głos może sprawić, że oszukańcze żądanie zabrzmi wiarygodnie. FTC ostrzegła, że oszuści mogą sklonować głos krewnego lub członka kierownictwa, aby wywrzeć presję na ludziach, by wysłali pieniądze lub udostępnili informacje. Rozsądne zabezpieczenia obejmują ograniczanie tego, kto może tworzyć niestandardowy głos lub mieć do niego dostęp, wymaganie zatwierdzenia przed opublikowaniem wygenerowanego dźwięku, rejestrowanie aktywności generowania, oddzielanie poświadczeń deweloperskich i produkcyjnych, stosowanie limitów szybkości, blokowanie kategorii treści wysokiego ryzyka oraz wymaganie drugiego kanału weryfikacji dla żądań finansowych.
Dla odbiorców w USA połączenia wychodzące dodają znaczenia prawnego. FCC stwierdza, że głosy generowane przez AI podlegają ograniczeniom ustawy o ochronie konsumentów telefonicznych (Telephone Consumer Protection Act) dotyczącym głosów sztucznych lub wcześniej nagranych, a takie połączenia zazwyczaj wymagają uprzedniej wyraźnej zgody, chyba że zastosowanie ma wyjątek. API klonowania głosu nie jest licencją na automatyzację telemarketingu, windykacji, połączeń politycznych ani komunikacji wrażliwej na tożsamość. Możesz bezpośrednio zapoznać się z orzeczeniem FCC w sprawie głosów robocall generowanych przez AI oraz alertem konsumenckim FTC dotyczącym klonowania głosu.
Wreszcie, klonowanie zmienia dostarczanie, a nie prawdę. Realistyczny głos sprawia, że niedokładne stwierdzenie brzmi autorytatywnie, więc sprawdź nazwy i liczby, tłumaczenia, wszelkie twierdzenia medyczne, finansowe lub prawne, instrukcje dotyczące produktu, wymowę, czas i tekst na ekranie przed publikacją. W przypadku wideo wielojęzycznego sprawdź zarówno przetłumaczony skrypt, jak i końcowy dźwięk — dobry klon nie uratuje błędnego tłumaczenia.
Czy API klonowania głosu jest odpowiednie dla Twojego projektu?
API klonowania głosu dobrze pasuje, gdy potrzebujesz tego samego głosu w wielu plikach, masz już niezawodny potok tekstu, tłumaczenia lub mediów, chcesz programowego generowania zamiast okazjonalnych ręcznych eksportów, posiadasz udokumentowaną zgodę na użycie głosu referencyjnego, produkujesz zlokalizowane lub spersonalizowane treści na dużą skalę oraz możesz testować i weryfikować wygenerowany dźwięk przed publikacją.
Gotowy głos TTS może Ci lepiej służyć, gdy szybkość, prostota i niskie ryzyko prawne przeważają nad ciągłością marki. Profesjonalny aktor głosowy jest często właściwym wyborem dla flagowych kampanii, niuansowych wykonań, wrażliwych tematów lub pracy, która wymaga pełnej reżyserii ludzkiej. Dla zespołów potrzebujących zarówno niestandardowych głosów, jak i lokalizacji w jednym miejscu, przedstawiamy klonowanie, TTS i dubbing AI jako połączone funkcje API: nasze API klonowania głosu buduje niestandardowy głos z próbki, a nasze API TTS używa identyfikatorów głosu do generowania mowy wewnątrz przepływu pracy projektu. Gdy będziesz gotowy to połączyć, nasz przewodnik dotyczący jak zintegrować API klonowania głosu szczegółowo omawia kroki przesyłania-tworzenia-generowania.
Najbardziej przydatną oceną jest kontrolowany test: użyj czystej, dozwolonej próbki, wygeneruj ten sam skrypt w zamierzonych językach, sprawdź jakość i opóźnienie, zweryfikuj cykl życia API i kontrolę usuwania oraz wymagaj zatwierdzenia przez człowieka przed jakąkolwiek publikacją.
Najczęściej zadawane pytania
Czy API klonowania głosu to to samo co generator głosu AI?
Nie. Generator głosu AI zazwyczaj pozwala wybrać istniejący syntetyczny głos i generować mowę z tekstu. API klonowania głosu tworzy niestandardowy głos z próbki dźwięku, który następnie można wykorzystać ponownie do generowania.
Ile dźwięku jest potrzebne do sklonowania głosu?
Wymagania różnią się w zależności od dostawcy i modelu. Zalecamy co najmniej 20 sekund czystego dźwięku i obsługujemy formaty wejściowe MP3, WAV, AAC, M4A i FLAC.
Czy sklonowany głos może mówić w innym języku?
Czasami. Zależy to od modelu dostawcy, jego obsługiwanych języków oraz zdolności głosu do przenoszenia się między językami. Zweryfikuj dokładną kombinację głosu i języka, zamiast zakładać, że każdy klon działa równie dobrze wszędzie.
Czy mogę używać sklonowanego głosu do dubbingu AI?
Tak, gdy dostawca łączy klonowanie z dubbingiem. Pozwalamy używać niestandardowych głosów w projektach AI Dubbing poprzez odwołanie się do identyfikatora głosu.
Czy klonowanie głosu jest legalne?
Sama technologia nie jest automatycznie nielegalna, ale używanie czyjegoś głosu bez autoryzacji może powodować problemy związane z prywatnością, prawami do wizerunku, umowami, oszustwami i ochroną konsumentów. Uzyskaj zgodę, przestrzegaj obowiązujących przepisów i unikaj zwodniczego podszywania się.