Wybór między tts a klonowaniem głosu do narracji sprowadza się do jednego szczerego pytania: potrzebujesz niezawodnego głosu do treści, czy tożsamości konkretnego mówcy w nich? Standardowa zamiana tekstu na mowę daje szybką, elastyczną narrację z gotowej biblioteki. Klonowanie głosu odtwarza rozpoznawalny głos, dzięki czemu ta sama osoba zdaje się mówić w nowych skryptach, filmach i językach. Dla wielu twórców i zespołów rozsądnym wyborem jest jedno i drugie: prototypuj z głosem stockowym dla szybkości, a następnie przenieś zatwierdzoną pracę na klona za zgodą, gdy tożsamość marki lub ciągłość mówcy zaczyna mieć znaczenie. Reszta tego przewodnika pokazuje dokładnie, gdzie każde z nich wygrywa.
Spis treści
Najszybszym sposobem, aby przestać kręcić się w kółko przy tym wyborze, jest rozdzielenie dwóch rzeczy, które ludzie nieustannie mylą: stylu głosu i tożsamości stojącej za nim. Standardowy głos TTS daje ci gotowy do produkcji styl. Może czytać ciepło, autorytatywnie, energicznie, konwersacyjnie lub neutralnie, a ty wybierasz go, bo pasuje do skryptu. Sklonowany głos daje ci ciągłość z konkretną osobą. Słuchacze rozpoznają go jako twórcę, instruktora, założyciela lub narratora, a ty wybierasz go, bo ta tożsamość jest częścią produktu.
Ta różnica zmienia coś więcej niż to, jak brzmi klip. Zmienia twoje obciążenie operacyjne. Styl to coś, co swobodnie zmieniasz; tożsamość to coś, co chronisz, dokumentujesz i utrzymujesz spójnie w każdym nowym pliku. Miej ten podział na uwadze, a większość poniższych decyzji odpowie sama na siebie.
Jak naprawdę działa narracja z zamiany tekstu na mowę
Zamiana tekstu na mowę przekształca tekst pisany w zsyntetyzowaną mowę. System czyta twój skrypt, interpretuje wymowę i strukturę zdania oraz renderuje ścieżkę audio w głosie, który wybierzesz z katalogu. Nie przechwytujesz konkretnej osoby czytającej słowa; generujesz świeżą mowę w stylu gotowego głosu.
W praktyce kontrolujesz kilka dźwigni: język, akcent, profil wokalny, ton, tempo mówienia i styl wypowiedzi. Ta elastyczność to cały sens. Gdy zmienia się cena, nazwa produktu, statystyka lub lekcja, edytujesz tekst i regenerujesz tylko dotkniętą sekcję, zamiast ponownie rezerwować studio. Nasze narzędzie Text to Speech przeprowadza tę pętlę od początku do końca: wprowadź tekst, wybierz mówcę spośród ponad 300 głosów AI, wygeneruj, edytuj projekt i pobierz, z kontrolą tempa mowy i wskazówkami tekstowymi dla akcentowania.
Sięgaj po standardowe TTS, gdy sam głos nie musi być rozpoznawalny. Pasuje do pierwszych wersji roboczych i wersji testowych, kanałów publikujących często i wymagających szybkich aktualizacji, procesów, w których kilka osób pisze lub zarządza skryptami, oraz treści wymagających różnych głosów dla różnych postaci lub sekcji. To także naturalny wybór, gdy chcesz badać wiele języków, akcentów lub stylów wypowiedzi, lub gdy tworzysz materiały instruktażowe, informacyjne i skoncentrowane na dostępności. Mała firma wypuszczająca cotygodniowe samouczki produktowe może na przykład utrzymać jeden spójny głos stockowy i aktualizować funkcje oraz wezwania do działania bez konieczności koordynowania nagrania.
Jak naprawdę działa narracja z klonowaniem głosu
Klonowanie głosu buduje syntetyczną mowę przypominającą konkretną osobę. System analizuje próbkę pod kątem wymowy, wysokości, rytmu, tonu i stylu mówienia, a następnie wykorzystuje te cechy do generowania nowej mowy z tekstu. To nie jest przycinanie gotowego lektoratu na osi czasu. Powstaje ponownie używalny model głosu, który może czytać skrypty, których mówca nigdy nie nagrał.
Próbka wykonuje większość ciężkiej pracy. Nasza strona Voice Cloning zaznacza, że możesz stworzyć niestandardowy głos z pliku audio o długości co najmniej 20 sekund, a czyste nagranie wolne od szumu tła daje lepsze rezultaty. Styl mówienia z tego przesłanego pliku przenosi się dalej: monotonna referencja zwykle daje bardziej płaską narrację, podczas gdy próbka z energią i emocjami, których faktycznie chcesz, daje modelowi silniejszy cel. Po utworzeniu głos można ponownie wykorzystać zarówno w projektach Text to Speech, jak i AI Dubbing.
Wybierz klonowanie, gdy tożsamość mówcy jest częścią marki lub produktu. Pasuje do prowadzącego YouTube, który musi publikować częściej bez nagrywania każdej linijki, podcastera poprawiającego małe sekcje zamiast ponownego nagrywania odcinka, firmy, która chce jednego spójnego głosu założyciela lub instruktora, oraz kursu, który musi zachować tego samego instruktora w wielu językach. Nauczyciel online może raz nagrać czystą próbkę, a następnie użyć klona za zgodą, aby odświeżyć lekcje, poprawić nieaktualne fakty lub budować wersje dla uczniów międzynarodowych. Aby głębiej przyjrzeć się ponownemu wykorzystaniu tożsamości w różnych formatach, zobacz nasz przewodnik na temat dubbingu AI a klonowania głosu do przerabiania treści.
Kluczowy podział: styl głosu czy tożsamość głosu
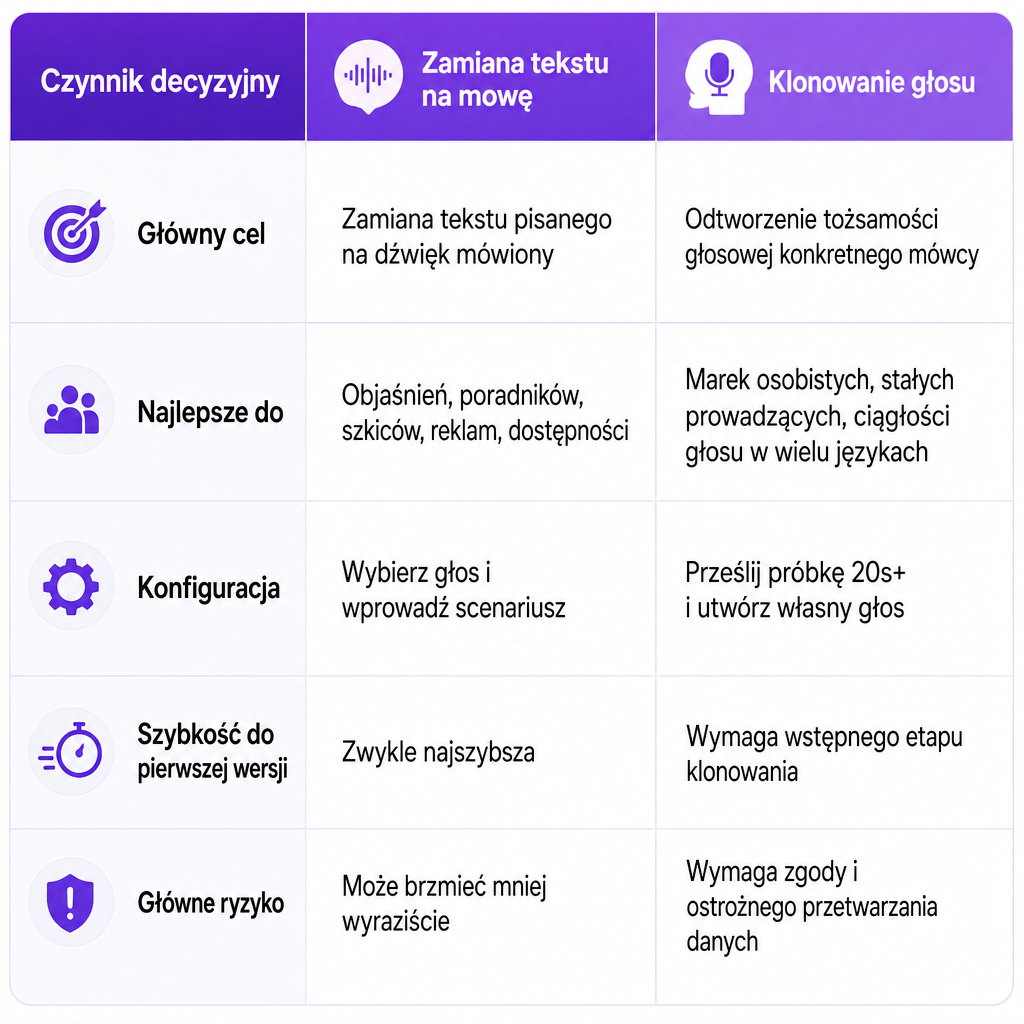
Jeśli nie zapamiętasz nic więcej, zapamiętaj ten schemat, ponieważ rozwiązuje większość przypadków granicznych szybciej niż jakakolwiek tabela funkcji. Standardowe TTS to problem wyboru: wybierasz styl z półki i możesz zmienić zdanie w przyszłym tygodniu bez żadnych kosztów. Klonowanie to zobowiązanie do ciągłości: wiążesz się z jedną tożsamością i zgadzasz się ją utrzymywać, zarządzać nią i bronić jej w czasie.
Dlatego marka prowadzona przez założyciela zachowuje się inaczej niż bezimienny kanał z objaśnieniami, nawet gdy skrypty wyglądają identycznie. Kanał z objaśnieniami potrzebuje tylko kompetentnego głosu, więc TTS go unosi. Marka założyciela opiera się na rozpoznawalności, więc sklonowany głos staje się aktywem wartym dodatkowej konfiguracji i formalności. Gdy czujesz się zablokowany, zapytaj, czy zmiana głosu w przyszłym miesiącu zaszkodziłaby relacji odbiorców z treścią. Jeśli tak, jesteś na terytorium klonowania. Aby dokładniej porównać te dwie ścieżki bezpośrednio, nasz artykuł na temat wyboru między sklonowanym głosem a stockowym głosem TTS bardziej szczegółowo rozkłada kryteria.
Czego używać, w zależności od celu produkcji
Właściwa odpowiedź zmienia się w zależności od tego, co faktycznie tworzysz. Oto jak ten wybór wypada w najczęstszych zadaniach narracyjnych.
Twórcy YouTube. TTS pasuje do kanałów bezimiennych, objaśnień, filmów typu lista i treści w stylu newsowym, gdzie nie chodzi o tożsamość prowadzącego. Klonowanie pasuje do kanałów, które widzowie wiążą z konkretnym prezenterem, pozwalając zachować rozpoznawalne brzmienie, pomijając ponowne nagrywanie przy poprawkach, intro i krótkich wariacjach. Przy wielojęzycznej ekspansji połącz niestandardowy głos z AI Dubbing zamiast wymyślać osobną tożsamość narracji dla każdego języka.
Małe firmy i zespoły marketingowe. Opieraj się na TTS przy wariacjach kampanii, objaśnieniach produktów, reklamach społecznościowych i częstych zmianach tekstu. Wprowadź klonowanie, gdy założyciel, ambasador lub rzecznik jest kluczowy dla zaufania. Klon może udźwiękowić zatwierdzone wariacje skryptu, ale nigdy nie zastępuje przeglądu twierdzeń, wymowy i tonu marki.
E-learning i szkolenia korporacyjne. TTS błyszczy, gdy kursy obejmują wiele modułów, tematów lub częste aktualizacje, ponieważ głosy stockowe ułatwiają przypisywanie różnych głosów do różnych kursów lub ról. Klonowanie pasuje do programów, w których uczniowie oczekują jednego instruktora przez cały czas, lub gdy odświeżasz istniejący kurs bez utraty znajomej tożsamości wokalnej. Tak czy inaczej, ludzki przegląd nazw, terminów technicznych, skrótów i liczb pozostaje niezbędny.
Podcasty i filmy niezależne. Używaj TTS do ścieżek roboczych, testów narracji i pracy zastępczej, zanim zostanie ustalony finalny mówca. Używaj klonowania do spójnych dogrywek, alternatywnych wersji lub zatwierdzonej lokalizacji prowadzącego lub wykonawcy, z udokumentowanymi prawami i zamierzonym użyciem przed rozpoczęciem produkcji.
Deweloperzy i agencje. TTS jest zwykle prostszym punktem wejścia API: wyślij tekst, wybierz głos, odbierz mowę. Klonowanie pasuje do aplikacji, które potrzebują trwałych niestandardowych głosów dla każdego klienta, marki lub postaci. Nasze Voice Cloning API akceptuje przesyłanie w formatach MP3, WAV, AAC, M4A i FLAC, zwraca niestandardowy głos, do którego możesz się odwołać w TTS lub AI Dubbing, i udostępnia operacje do wyświetlania i usuwania niestandardowych głosów.
Które brzmi bardziej naturalnie
Żadna z opcji nie jest automatycznie tą naturalną. Wysokiej jakości głos stockowy może łatwo pobić klona zbudowanego z zaszumionego audio, a zła próbka odtwarza własne wady: szum tła, nierówną wypowiedź, ton emocjonalny, który nie pasuje do skryptu. Naturalność to wynik, który testujesz, a nie etykieta, którą zakładasz.
Oceniaj rezultat według konkretnych kryteriów, a nie pierwszego wrażenia:
- Wymowa: czy poprawnie wymawia nazwy, akronimy, liczby i terminy techniczne?
- Prozodia: czy rytm pasuje do skryptu?
- Spójność: czy głos pozostaje stabilny w różnych klipach i językach?
- Emocja: czy wypowiedź pasuje do celu narracji?
- Klarowność: czy jest zrozumiały na telefonach, laptopach i słuchawkach?
- Edytowalność: czy możesz zregenerować jedno zdanie bez odchylenia całej ścieżki?
- Lokalizacja: czy nadal pasuje, gdy zostanie zaadaptowany na inny rynek?
W przypadku TTS uruchom kilka głosów stockowych na tym samym akapicie i porównaj. W przypadku klonowania przetestuj reprezentatywny skrypt z trudnymi słowami, zakresem emocjonalnym i tempem gotowego projektu, nie tylko krótkie powitanie. Powitanie prawie zawsze brzmi dobrze; prawdziwa praca tkwi tam, gdzie klony ujawniają swoje słabości.
Prawa, zgoda i ujawnienie, których nie możesz pominąć
Klonowanie niesie odpowiedzialność, której zwykłe TTS nie ma, ponieważ może odtworzyć głos możliwej do zidentyfikowania osoby. Klonuj głos tylko wtedy, gdy posiadasz pozwolenie i prawa do zamierzonego użycia, i uczyń to pozwolenie konkretnym. Dobra zgoda obejmuje to, kto jest właścicielem źródłowego nagrania, gdzie syntetyczny głos może się pojawić, czy dozwolone jest użycie komercyjne, które języki i terytoria są uwzględnione, czy dozwolona jest reklama lub dubbing, jak długo trwa pozwolenie, jak przechowywane są model i pliki źródłowe oraz co dzieje się, gdy licencja wygasa.
Traktujemy zgodę i etyczne użycie jako część naszego podejścia do klonowania głosu, a nasze API obsługuje usuwanie niestandardowych głosów i powiązanych z nimi danych audio. Potwierdź aktualne warunki, które mają zastosowanie do twojego konta i projektu, zanim prześlesz próbkę. Tło prawne również wciąż się zmienia: Urząd ds. Praw Autorskich USA zidentyfikował realistyczne repliki głosu jako repliki cyfrowe i zalecił dodatkową ochronę federalną przed nieautoryzowanymi, jak przedstawiono w jego raporcie na temat praw autorskich i replik cyfrowych.
Istnieje też warstwa ujawnienia. Wytyczne YouTube dotyczące ujawniania treści generowanych przez AI nazywają syntetyczne generowanie głosu osoby do narracji filmu realistyczną zmienioną lub syntetyczną treścią, którą twórcy muszą ujawnić. Nie przedstawiaj więc sklonowanego głosu jako niezmienionego nagrania, jeśli mogłoby to wprowadzić widzów w błąd. FTC osobno ostrzegła, że klonowanie głosu czyni oszustwa z podszywaniem się bardziej wiarygodnymi, co jest właśnie powodem, dla którego autoryzacja i przejrzyste użycie nie są opcjonalnymi grzecznościami.
Zasada decyzyjna, którą możesz zastosować już dziś
Jeśli odbiorcy potrzebują dobrego głosu, wybierz TTS. Jeśli odbiorcy potrzebują tego konkretnego mówcy, wybierz klonowanie głosu.
Zacznij od TTS, gdy dominują szybkość, różnorodność, eksperymentowanie i częste zmiany skryptu. Jest szybsze w testowaniu, łatwiejsze w rewizji i otwiera szeroki zakres głosów bez wymaganej próbki. Przejdź do klonowania, gdy chodzi o rozpoznawalność, ciągłość i tożsamość mówcy, takie jak kanał prowadzony przez twórcę, kurs prowadzony przez instruktora, marka prowadzona przez założyciela, prowadzący podcast lub wielojęzyczny rzecznik. Używaj tylko autoryzowanej próbki, dokładnie przeglądaj wygenerowane audio i przestrzegaj zasad ujawniania tam, gdzie mają zastosowanie.
Wiele zespołów decyduje się na jedno i drugie, i to celowo: prototypuj z głosem stockowym, a następnie przenoś zatwierdzone, powtarzające się treści na niestandardowy głos, gdy produkcja uzasadnia konfigurację. Ta hybryda jest szczególnie skuteczna dla kanałów YouTube, kursów online, kampanii markowych i wielojęzycznych bibliotek. Łączymy oba w jeden proces, dzięki czemu możesz zacząć od elastycznej narracji z ponad 300 głosów, tworzyć niestandardowe głosy z próbek audio i ponownie wykorzystywać je w TTS lub AI Dubbing w miarę dojrzewania projektu.
Najczęściej zadawane pytania
Czy klonowanie głosu to to samo co TTS?
Nie. TTS przekształca tekst pisany w mowę za pomocą wybranego syntetycznego głosu. Klonowanie głosu tworzy niestandardowy model głosu, który ma przypominać konkretnego mówcę, a który następnie może generować narrację TTS.
Czy TTS jest lepsze niż klonowanie głosu?
Nie uniwersalnie. TTS zwykle wygrywa pod względem szybkości, różnorodności głosów, testowania i częstych aktualizacji. Klonowanie wygrywa, gdy tożsamość konkretnego mówcy musi pozostać spójna w nowych treściach.
Ile audio jest potrzebne, aby sklonować głos za pomocą DubSmart?
Nasza strona Voice Cloning mówi, że przesłany plik powinien zawierać co najmniej 20 sekund audio. Dla lepszych rezultatów zalecane jest czyste nagranie bez szumu tła.
Czy mogę użyć sklonowanego głosu do wielojęzycznej narracji?
Tak. Sklonowane głosy można ponownie wykorzystać w AI Dubbing w naszych obsługiwanych językach. Przetestuj wymowę i dopasowanie kulturowe na każdym rynku docelowym przed publikacją.
Czy twórcy YouTube powinni ujawniać narrację AI?
Sprawdź aktualne kontrolki ujawniania YouTube. YouTube identyfikuje syntetyczne generowanie głosu osoby do narracji jako realistyczną zmienioną lub syntetyczną treść, która może wymagać ujawnienia.