Szczera odpowiedź na pytanie, ile nagrania potrzeba do sklonowania głosu, jest krótsza, niż większość ludzi się spodziewa: przy DubSmart AI potrzebujesz co najmniej 20 sekund czystego nagrania jednej osoby. To minimum pozwala uruchomić użyteczny klon, ale rzadko oddaje całą historię. Długość, którą faktycznie powinieneś nagrać, zależy od tego, gdzie głos będzie funkcjonował — pojedynczy klip w mediach społecznościowych, stały narrator kanału, wielojęzyczna biblioteka kursów czy rzecznik marki, który musi brzmieć identycznie w kilkudziesięciu filmach. Poniżej oddzielamy twarde minimum od praktycznego celu, wyjaśniamy, czego model naprawdę nasłuchuje, i dajemy ci zasadę decyzyjną, którą możesz zastosować, zanim naciśniesz nagrywanie.
Spis treści
Minimum a praktyczny cel
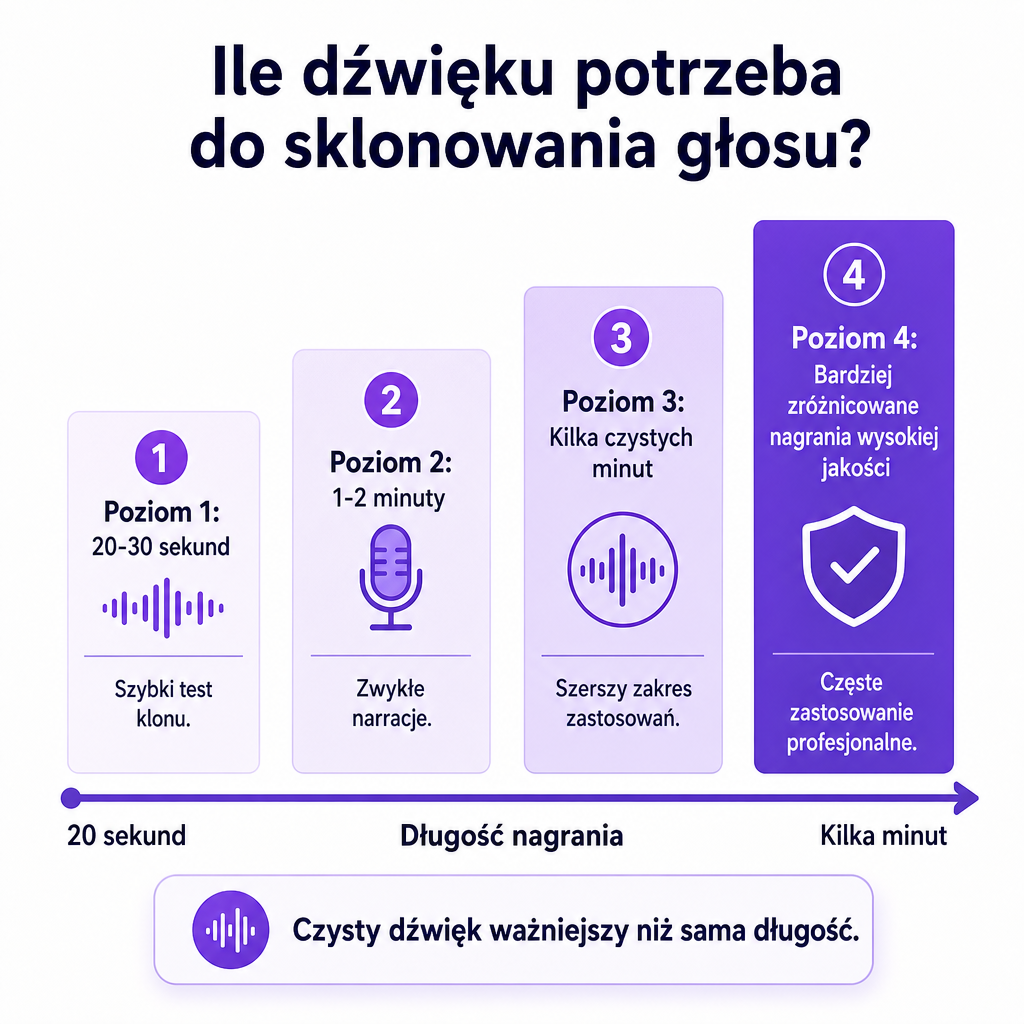
Dwadzieścia sekund to podłoga, a nie meta. Próbka o minimalnej długości uchwyci podstawową tożsamość mówcy, co często wystarcza do szybkiego testu lub jednorazowego klipu. Ale ilość materiału, który dostarczasz modelowi, bezpośrednio kształtuje to, jak dobrze klon radzi sobie z różnorodnymi scenariuszami. Właściwy cel skaluje się wraz z tym, jak wymagające i powtarzalne będą efekty.
| Twój cel | Praktyczny cel nagrania |
|---|---|
| Szybko przetestować klon | 20–30 sekund |
| Tworzyć regularne podkłady głosowe | 1–2 minuty |
| Uchwycić szerszy zakres sposobu mówienia | Kilka czystych minut |
| Zbudować głos do częstego profesjonalnego użytku | Bardziej zróżnicowane, wysokiej jakości nagrania |
Zasada leżąca u podstaw całej tabeli jest bezpośrednia: czyste, spójne nagranie jest zwykle warte więcej niż dłuższe nagranie pełne szumu, echa, muzyki lub wielu mówców. Schludny 30-sekundowy klip może przewyższyć bałaganiarski 10-minutowy. Jeśli chcesz poznać szerszą mechanikę tego, jak próbka staje się głosem wielokrotnego użytku, nasze wyjaśnienie na temat jak klonowanie głosu odtwarza głos obejmuje cały proces.
Co naprawdę oznacza „wystarczająco dużo nagrania”
„Wystarczająco” nie jest tak naprawdę liczbą na stoperze — to kwestia tego, czy model ma wystarczająco dużo użytecznej mowy, by odtworzyć głos, którego chcesz. Gdy klonujesz głos, AI analizuje nagranie, aby zidentyfikować zestaw cech, a następnie wykorzystuje je do generowania nowej mowy z tekstu lub przetłumaczonych dialogów.
Do tych cech należą:
- Barwa i ton głosu
- Wysokość i rytm mówienia
- Wymowa i akcent
- Pauzy i kadencja
- Energia, akcentowanie i emocjonalny sposób wypowiedzi
Krótka próbka ustala podstawową tożsamość mówcy. Dłuższa, bardziej zróżnicowana dodaje informacji o tym, jak ta osoba brzmi, gdy wyjaśnia, pyta, podkreśla, robi pauzy lub zmienia ton emocjonalny. Prawdziwym celem jest więc reprezentatywne nagranie: materiał, który pokazuje modelowi głos robiący te rzeczy, o które zostanie później poproszony.
Kiedy nagrywać więcej niż 20 sekund
Wyjdź poza minimum zawsze, gdy sklonowany głos będzie pojawiał się wielokrotnie, reprezentował markę lub niósł dłuższe treści. W takich przypadkach praktycznym punktem wyjścia jest jedna do dwóch minut czystej mowy, z dodaniem większej ilości, jeśli potrzebujesz, by głos odtwarzał szerszy zakres stylów wypowiedzi.
Dłuższe próbki opłacają się przy pracy opartej na narracji: filmach na YouTube, podcastach, kursach online, szkoleniach korporacyjnych, treściach w stylu audiobooków, prezentacjach produktów, wielojęzycznym dubbingu, dialogach postaci i powtarzalnych kampaniach marketingowych. Twórca, który nagra jedynie spokojne wprowadzenie, zwykle otrzymuje klon, który działa najlepiej w tym jednym spokojnym rejestrze. Twórca, który nagra wyjaśnienia, pytania, akcentowanie i naturalne pauzy, dostarcza modelowi znacznie więcej przykładów głosu w działaniu. Celem nigdy nie jest zrzucenie maksymalnej liczby minut — chodzi o dostarczenie nagrania, które reprezentuje, jak głos naprawdę się zachowuje.
Dlaczego czyste nagranie jest ważniejsze niż długie
Większa ilość nagrania pomaga tylko wtedy, gdy dodatkowy materiał jest wysokiej jakości i istotny. 10-minutowe nagranie z echem pomieszczenia, stukaniem klawiatury, muzyką w tle, zmieniającymi się mikrofonami lub kilkoma mówcami może być mniej przydatne niż krótki, czysty klip. Głośniejszy szum to nadal szum, więc zwiększanie wzmocnienia nigdy nie ratuje złej próbki.
Dodatkowe nagranie zasługuje na swoje miejsce, gdy jest:
- Wyraźnie wypowiedziane przez jedną osobę
- Spójne pod względem głośności i odległości od mikrofonu
- Wolne od muzyki, efektów dźwiękowych i nakładających się głosów
- Nagrane w cichym otoczeniu o niskim poziomie echa
- Wygłoszone w naturalnym tempie
- Reprezentatywne dla stylu, który chcesz wygenerować
Kilka nawyków nagraniowych chroni jakość bardziej niż jakikolwiek cel długości. Zachowaj jednego mówcę w klipie; inne głosy mylą analizę. Preferuj mały umeblowany pokój zamiast dużego pustego, aby ograniczyć odbicia, i utrzymuj stałą odległość od mikrofonu przez cały czas. Nie nagrywaj jednej sekcji z bliska, a innej z drugiego końca pokoju, i unikaj wypełniania pliku długimi ciszami lub niezwiązanym dźwiękiem. Jeśli twoim jedynym źródłem jest zaszumiony film, najpierw go oczyść, zamiast liczyć na to, że długość to zrekompensuje — nasz przewodnik po usuwaniu muzyki w tle z dźwięku przeprowadza przez to czyszczenie.
Co powinna faktycznie zawierać twoja próbka
Treść ma takie samo znaczenie jak jakość. Nagranie powinno zawierać wyraźną, naturalną mowę, a nie izolowane dźwięki lub mocno pocięte frazy. Dobra próbka miesza krótkie i długie zdania, zakres dźwięków samogłoskowych i spółgłoskowych, liczby i daty, nazwy i powszechne terminy, pytania, zdania z naciskiem oraz naturalne pauzy — najlepiej w tym samym rodzaju języka, jakiego użyje finalna treść.
To, jak wygląda w praktyce, różni się w zależności od twórcy. YouTuber może nagrać krótkie wprowadzenie, wyjaśnienie, wezwanie do działania i kilka wersów na różnych poziomach akcentowania. Producent e-learningu może uwzględnić frazowanie instruktażowe, definicje, listy i przejścia. Rzecznik biznesowy zyskuje, wplatając terminologię marki i konwersacyjny styl używany w treściach skierowanych do klientów. Rozstrzygnięcie, czy w ogóle potrzebujesz tutaj klona, to uzasadnione pytanie; nasze zestawienie sklonowanego głosu a gotowego głosu TTS pomaga, gdy głos z biblioteki wykona zadanie szybciej.
Klonowanie wielojęzyczne i zaszumione nagranie źródłowe
W projektach wielojęzycznych wymaganiem wyjściowym nadal jest jakość oryginalnej próbki głosu. Tłumaczenie wygenerowanej mowy na inne języki nie znosi potrzeby wyraźnego nagrania źródłowego — mętny angielski klip tworzy mętny klon w każdym języku docelowym.
Gdy planujesz lokalizację, zwróć uwagę na wyrazistość oryginalnego głosu, wymowę nazw i terminów marki, zamierzony ton w każdym języku, to, czy styl mówcy powinien pozostać formalny, przyjazny, energiczny czy konwersacyjny, oraz czy przetłumaczone scenariusze zostały sprawdzone przed dubbingiem. W większym projekcie lokalizacyjnym przetestuj krótką sekcję w każdym języku docelowym przed przetworzeniem całego filmu; to ujawnia problemy z wymową, tempem i adaptacją kulturową na wczesnym etapie. Proces AI Dubbing w DubSmart może wykorzystać sklonowany głos do przetłumaczonych treści, a sklonowane głosy mogą być używane zarówno w Text to Speech, jak i AI Dubbing.
Jakość źródła to druga połowa tego problemu. Często można wydobyć mowę z filmu, ale muzyka w tle, efekty dźwiękowe, pogłos pomieszczenia, wiatr, hałas publiczności, nakładająca się mowa i artefakty kompresji sprawiają, że klip jest słabym punktem wyjścia. Jeśli źródło jest cenne, ale zaszumione, najpierw wyizoluj mowę. Nasz Speech Separator oddziela ścieżkę głosową od innych elementów dźwiękowych, a im czystsza ta ścieżka, tym bardziej wiarygodny klon.
Zgoda i prawo do klonowania głosu
Głos innej osoby możesz sklonować tylko wtedy, gdy masz odpowiednie pozwolenie i prawa. Klonowanie głosu niesie realne ryzyko prawne, etyczne, dotyczące prywatności i podszywania się, więc przed wgraniem cudzego nagrania uzyskaj świadomą zgodę i potwierdź, jak głos może być używany, dystrybuowany i przechowywany. Zasady Voice Cloning Challenge amerykańskiej Federalnej Komisji Handlu wymagały, aby uczestnicy klonowali głosy wyłącznie za zgodą osoby, której głos był klonowany.
W przypadku pracy komercyjnej udokumentuj, kto jest właścicielem lub kontroluje głos, które nagrania mogą być użyte, które typy treści i języki są dozwolone, czy dozwolone jest użycie komercyjne, jak długo trwa pozwolenie, czy dana osoba może je wycofać oraz jak w odpowiednich przypadkach ujawniane będą treści syntetyczne. Nie klonuj osoby publicznej, pracownika, klienta, aktora lub członka rodziny tylko dlatego, że masz dostęp do jej nagrania. Dostęp to nie pozwolenie.
Ile nagrywać według typu twórcy
To samo minimum dotyczy każdego, ale praktyczny cel zmienia się wraz z ryzykiem produkcyjnym. Używaj minimum, gdy liczy się szybkość — wczesne testowanie kreatywne, krótkie klipy, wewnętrzne prototypy, proste ogłoszenia — i nagrywaj więcej, gdy głos musi pozostać spójny w wielu filmach lub językach.
| Twórca | Zalecana próbka |
|---|---|
| Twórcy YouTube | 20s do testu; 1–2 czyste, ekspresyjne minuty dla stałego narratora |
| Małe firmy / marketing | Spójny klip rzecznika z terminologią i energią kampanii; najpierw przetestuj krótki podkład głosowy |
| E-learning / szkolenia | Dłuższa, zróżnicowana próbka obejmująca definicje, instrukcje, pytania, przejścia |
| Podcasterzy | Próbka odzwierciedlająca normalne tempo prowadzącego; sprawdź wymowę nazw i sponsorów |
| Filmowcy | Próbka pasująca do kierunku postaci, obejmująca szept, intensywność lub inne dramatyczne cechy |
| Deweloperzy / agencje | Powtarzalny standard audio stosowany przed przyjęciem próbek klienta |
Za tą tabelą stoją dwie praktyczne uwagi. Neutralna próbka nie odtworzy wypowiedzi, która zależy od szeptu, ironii lub strachu, więc filmowcy powinni uchwycić postać, a nie tylko głos. A w przypadku pipelineów opartych na API stały standard przyjmowania zapobiega niespójnym wynikom u różnych klientów; nasze Voice Cloning API tworzy niestandardowe głosy z próbek audio i udostępnia je w Text to Speech oraz AI Dubbing.
Krótka kontrola przed wgraniem utrzymuje przewidywalność wyników. Potwierdź, że próbka trwa co najmniej 20 sekund, zawiera jednego mówcę, nie ma muzyki ani nakładających się głosów, ma minimalne echo i szum tła, utrzymuje stałą pozycję i poziom mikrofonu, zawiera naturalną mowę zamiast długiej ciszy, pasuje do zamierzonego stylu i pochodzi od mówcy, który wyraził zgodę na zamierzone użycie.
Użyj 20 sekund, aby przetestować koncepcję, jednej do dwóch minut dla niezawodnej codziennej narracji i więcej zróżnicowanego czystego nagrania, gdy głos musi działać spójnie w treściach długich lub wielojęzycznych.
Minimum pozwala ci zacząć. Jakość nagrania, spójność mówcy, zakres ekspresji i pozwolenie decydują o tym, czy wynik jest gotowy do publikacji.
Najczęściej zadawane pytania
Ile nagrania potrzeba, aby sklonować głos?
W DubSmart potrzebujesz co najmniej 20 sekund nagrania. Dla lepszego pokrycia sposobu wypowiedzi mówcy celuj w jedną do dwóch minut czystej, naturalnej mowy.
Czy 10 sekund wystarczy do sklonowania głosu?
Może wystarczyć dla niektórych systemów, ale jest poniżej podanego minimum DubSmart. Wgraj co najmniej 20 sekund dla klona DubSmart.
Czy jedna minuta wystarczy do klonowania głosu?
Często tak, dla codziennej narracji, pod warunkiem że jest czysta, spójna i wypowiedziana naturalnie. Większa, bardziej zróżnicowana próbka pomaga przy zastosowaniach ekspresyjnych lub profesjonalnych.
Czy dłuższe nagranie sprawia, że klon jest dokładniejszy?
Nie automatycznie. Dodatkowa długość pomaga tylko wtedy, gdy dodaje czyste, istotne przykłady głosu. Szum, echo, muzyka i wielu mówców zmniejszają wartość dodanego nagrania.
Czy potrzebuję pozwolenia na sklonowanie głosu?
Tak. Uzyskaj zgodę i potwierdź obowiązujące prawa przed sklonowaniem głosu innej osoby, obejmując zamierzone użycie, dystrybucję i działalność komercyjną. Zasady wyzwania klonowania głosu FTC również wymagały zgody osoby, której głos był klonowany.
Czy mogę użyć klona głosu do dubbingu AI?
Tak. Utworzone głosy mogą być używane zarówno w Text to Speech, jak i AI Dubbing.