Jeśli trafiłeś na hasło comfyui text to speech w nadziei na pojedynczy przycisk, który zamienia scenariusz w dźwięk, pierwszą rzeczą, którą warto wiedzieć, jest to, że ComfyUI wcale nie jest silnikiem głosowym. To oparte na węzłach środowisko pracy, w którym łączysz tekst, głos, model, język i wyjście audio w jeden graf wielokrotnego użytku. Sama mowa pochodzi z dowolnego węzła TTS, który podłączysz: hostowanego dostawcy, oficjalnej integracji partnerskiej lub lokalnego modelu, który instalujesz samodzielnie. Pytanie, które naprawdę ma znaczenie, nie brzmi więc, czy ComfyUI może wypowiedzieć twój scenariusz, bo może, lecz czy graf wizualny jest właściwym miejscem na pracę, którą musisz powtarzać.
To rozróżnienie kształtuje każdą inną decyzję na tej stronie. ComfyUI nagradza eksperymentowanie i multimodalne potoki, w których narracja sąsiaduje z generowaniem obrazu, wideo i dźwięku. Dedykowane narzędzie do mowy nagradza powtarzalną produkcję, gdzie po prostu potrzebujesz czystych lektorów raz za razem. Poniżej rozkładamy na czynniki pierwsze, jak działa przepływ pracy, jakie typy opcji istnieją, jak je oceniać i gdzie graf przestaje być wart utrzymywania.
Spis treści
Czym właściwie jest ComfyUI text to speech
ComfyUI text to speech to praktyka wykorzystywania grafu ComfyUI do zamiany pisanego tekstu na wyjście AUDIO. Oficjalna dokumentacja opisuje ComfyUI jako open-source'ową, opartą na węzłach aplikację do budowania przepływów pracy w zakresie generowania obrazu, wideo, dźwięku i grafiki 3D, a jej węzły audio podłączają zewnętrzne usługi lub modele mowy do tego samego wizualnego płótna.
Działający graf mowy jest niewielki. Potrzebuje wejścia tekstowego lub promptu, węzła TTS, wejścia głosu lub referencyjnego audio, opcjonalnych ustawień języka i sposobu wypowiedzi oraz węzła podglądu lub zapisu audio. Węzeł TTS przepuszcza twój scenariusz przez model mowy i zwraca wygenerowany dźwięk, który mogą wykorzystać kolejne węzły.
Praktyczna konsekwencja jest taka, że ComfyUI to warstwa przepływu pracy, a nie model. Właściwy głos może być tworzony przez hostowanego dostawcę, partnerski model audio, zewnętrzny węzeł niestandardowy lub lokalnie zainstalowany system. Zrozumienie tego podziału utrzymuje twoje oczekiwania w ryzach: składasz potok, a silnik w jego wnętrzu wciąż wybierasz ty.
Jak działa czteroetapowy przepływ pracy
Odrzuć nazwy węzłów, a każdy graf mowy ComfyUI robi po kolei te same cztery rzeczy.
Po pierwsze, scenariusz pojawia się jako tekst. Węzeł TTS może przyjmować zwykły tekst bezpośrednio albo tekst może napływać z innego węzła, który wczytuje, tłumaczy lub segmentuje dłuższy scenariusz. Podzielenie długiej narracji na logiczne sekcje pozwala ci regenerować jeden akapit bez odbudowywania całego lektora i pomaga nie przekroczyć limitu wejściowego dostawcy.
Po drugie, przepływ pracy wybiera głos i model. W zależności od dostawcy może to być predefiniowany mówca, sklonowany głos, identyfikator głosu lub nagranie referencyjne. Wybór modelu rządzi również szybkością, jakością, zakresem ekspresji i kosztem. Na przykład węzeł HeyGen w ComfyUI udostępnia zarówno heygen-voice-1, jak i szybszy, tańszy heygen-voice-1-turbo, podczas gdy węzeł ElevenLabs oferuje elementy sterujące takie jak stabilność, szybkość i styl.
Po trzecie, model mowy syntetyzuje dźwięk. Nowoczesne systemy neuronowe szacują wymowę, rytm, pauzy i ruch wysokości tonu, zamiast sklejać wcześniej nagrane słowa, i zwracają przebieg fali, który możesz skierować dalej: zapisać do pliku, zmiksować z muzyką, wrzucić do grafu wideo lub połączyć z awatarem.
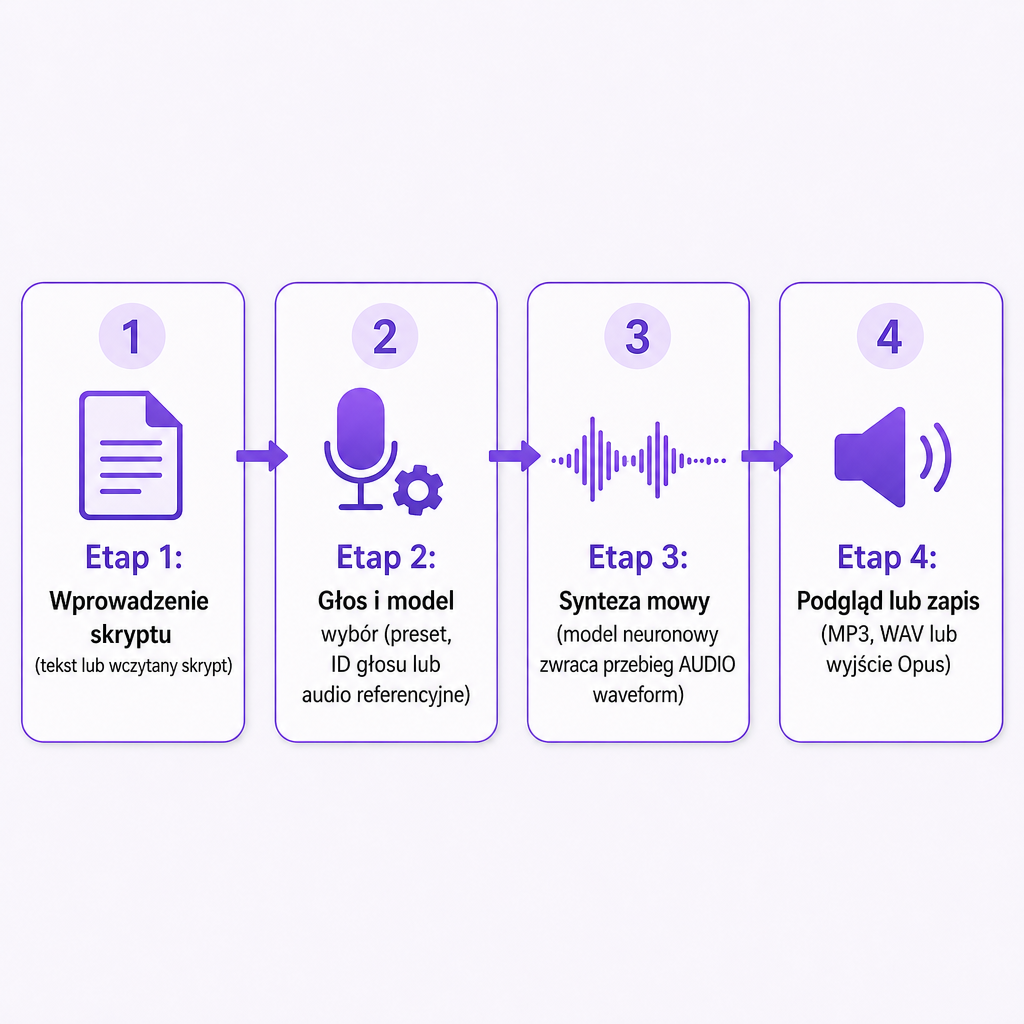
Po czwarte, dźwięk jest wyświetlany w podglądzie lub zapisywany. Węzły TTS zazwyczaj emitują obiekt AUDIO, który łączy się z węzłem podglądu lub zapisu, a format pliku ustala węzeł i dostawca; dokumentacja węzła ElevenLabs wymienia na przykład wybieralne formaty, w tym warianty MP3 i Opus. Ponieważ graf jest wizualny, pętlę łatwo powtórzyć: zmień scenariusz, głos, język lub model, a potem ponownie dodaj do kolejki.
Trzy sposoby uruchamiania TTS w ComfyUI
Nie istnieje jedna metoda mowy w ComfyUI, a różnice sprowadzają się do konfiguracji, kontroli, prywatności i tego, ile utrzymania jesteś gotów wziąć na siebie.
Węzły hostowanego dostawcy wysyłają twój tekst i ustawienia głosu do zewnętrznej usługi i zwracają gotowy dźwięk. Zwykle to najszybsza droga do wysokiej jakości mowy, ponieważ model działa na infrastrukturze dostawcy. Węzeł HeyGen Voice 1.0 ilustruje ten schemat: wymaga prawidłowego identyfikatora sklonowanego głosu, wysyła tekst i identyfikator do HeyGen i zwraca mowę. Kompromisy również są przewidywalne, ponieważ może być wymagane konto lub połączenie API, użycie może zużywać kredyty dostawcy, twój tekst i dźwięk są przetwarzane przez stronę trzecią, a limity lub cennik dostawcy mogą się zmieniać.
Oficjalne partnerskie węzły audio rozszerzają tę samą ideę na większą część przestrzeni dźwiękowej. Dokumentacja audio ComfyUI oddziela generowanie tekstu na dźwięk od przypadków użycia związanych z głosem i mową, w tym mowę z tekstu oraz z audio referencyjnego. Te integracje błyszczą, gdy twój graf już opiera się na innych hostowanych modelach mediów, bo ograniczają przerzucanie plików między osobnymi aplikacjami.
Społecznościowe i lokalne węzły TTS łączą ComfyUI z systemami takimi jak Edge TTS, Kokoro, Index-TTS i innymi modelami, które mogą działać lokalnie. Lokalne przepływy pracy mogą dać ci większą kontrolę nad danymi i wyborem modelu, ale w zamian wymagają więcej: instalacji, zgodnego sprzętu, pobrań modeli i rozwiązywania problemów. Lokalny węzeł nie jest automatycznie lepszy od hostowanego. Jego prawdziwa przewaga zależy od tego, czy twoja maszyna potrafi wydajnie uruchomić model, czy jakość głosu się utrzymuje, czy twój język jest obsługiwany, czy licencja zezwala na użytek komercyjny i czy potrafisz utrzymać przepływ pracy przy życiu na przestrzeni czasu.
Klonowanie głosu i elementy sterujące, których możesz się spodziewać
Klonowanie głosu dodaje do grafu referencyjną tożsamość zamiast gotowego mówcy. Struktura zwykle składa się z dwóch połączonych części: węzła klonującego, który tworzy lub zwraca tożsamość głosową, oraz węzła TTS, który używa tej tożsamości do wypowiadania nowego tekstu. Dokumentacja HeyGen opisuje to wprost, gdzie węzeł Instant Clone tworzy voice_id, który zasila węzeł Voice 1.0 Text to Speech; ten przepływ klonowania wymaga co najmniej 10 sekund czystej mowy, a węzeł TTS akceptuje do 5000 znaków na żądanie.
Klonuj tylko za zgodą. Nie odtwarzaj głosu prawdziwej osoby tylko dlatego, że masz dostęp do nagrania. Uzyskaj pozwolenie, zachowaj jego dowód i ujawniaj syntetyczną lub sklonowaną mowę wszędzie tam, gdzie kontekst mógłby wprowadzić odbiorcę w błąd.
Poza samym głosem, elementy sterujące, które napotkasz, różnią się w zależności od węzła i modelu, ale w większości z nich powtarza się znajomy zestaw.
- Głos: tożsamość mówcy lub preset
- Język: język używany do interpretacji scenariusza
- Szybkość: jak szybko wygłaszana jest narracja
- Wysokość tonu: odczuwana wysokość lub niskość głosu
- Styl i ekspresyjność: charakter wypowiedzi i to, jak mocno stosowana jest emocja
- Stabilność: jak konsekwentnie głos utrzymuje swoje cechy
- Format wyjściowy: taki jak MP3, WAV lub Opus
- Audio referencyjne: nagranie używane do klonowania lub transformacji mowy
Niektóre modele idą dalej dzięki wskazówkom w tekście. Dokumentacja węzła Fish Audio obsługuje wskazówki emocji i znaczniki dialogu wielu mówców w obsługiwanych modelach. Jedna uwaga dotyczy ich wszystkich: te elementy sterujące nie są wymienne między dostawcami, a ustawienie zwane stylem w jednym węźle może zachowywać się zupełnie inaczej niż styl w innym.
ComfyUI kontra dedykowana platforma TTS
ComfyUI zarabia na swoje miejsce, gdy mowa jest jedną z części większego potoku medialnego. Dedykowana platforma zwykle wygrywa, gdy jedynym prawdziwym zadaniem jest zamiana scenariuszy w dopracowaną narrację bez składania grafu.
| Czynnik decyzyjny | ComfyUI | Dedykowana platforma TTS |
|---|---|---|
| Elastyczność przepływu pracy | Wysoka; połącz TTS z innymi węzłami medialnymi | Zwykle skupiona na produkcji mowy |
| Konfiguracja | Może wymagać węzłów, powiązań z dostawcami lub instalacji modeli | Często szybsza przy pierwszym generowaniu |
| Opcje głosu | Zależą od zainstalowanych lub podłączonych węzłów | Zwykle jedna uporządkowana biblioteka głosów |
| Automatyzacja | Silna dla wielokrotnie używanych grafów wizualnych | Często poprzez API lub narzędzia wsadowe |
| Przetwarzanie lokalne | Możliwe z lokalnymi węzłami i modelami | Zwykle oparte na chmurze |
| Najlepsze zastosowanie | Eksperymentalne lub multimodalne potoki | Powtarzalna narracja i produkcja |
Dla twórców budujących wizualny potok, który łączy mowę z obrazami, wideo lub przetwarzaniem dźwięku, graf zwraca się z nawiązką. Dla narracji na YouTube, lektorów do e-learningu, podcastów lub zespołów lokalizacyjnych, które potrzebują przewidywalnego interfejsu, wyspecjalizowana usługa zwykle eliminuje narzut techniczny. Nasz przepływ pracy Text to Speech jest zbudowany wokół bezpośredniego generowania dźwięku ze scenariusza, z ponad 300 głosami AI, klonowaniem głosu w 33 językach, regulowaną szybkością mowy, emocjonalnymi wskazówkami dialogowymi i projektami do pobrania. Gdy generowanie musi mieścić się wewnątrz aplikacji lub zautomatyzowanego potoku treści, nasze Text to Speech API obsługuje stronę integracji, a nasze AI Dubbing API rozszerza tę samą ideę na przetłumaczone, dopasowane głosowo wideo.
Jak wybrać i rozwiązywać problemy z konfiguracją
Zanim zdecydujesz się na węzeł lub model, przeprowadź kilka świadomych kontroli, zamiast ufać krótkiemu demu.
Oceniaj jakość głosu na trudnej próbce, a nie na łatwej. Wygeneruj fragment, który zawiera imiona, liczby, akronimy, długie zdania, pytania, terminy marki i co najmniej jedną emocjonalną linię w docelowym języku i akcencie. Głos, który oczaruje cię w jednym zdaniu, może pokaleczyć nazwę produktu lub zgubić rytm w całym akapicie.
Sprawdzaj obsługę języka i akcentu osobno dla każdego języka, a nie zbiorczo. Niektóre systemy wykrywają język automatycznie, podczas gdy inne wymagają jego ustawienia, a dokumentacja węzła HeyGen zaleca ręczne ustawienie języka dla blisko spokrewnionych języków, gdzie automatyczne wykrywanie bywa zawodne. Pamiętaj, że płynny głos nie uratuje niedokładnego tłumaczenia; jakość głosu i jakość tłumaczenia to osobne problemy.
Zmierz kontrolę wymowy dla słów, które faktycznie podkładają silnikom nogę: nazw produktów, nazw własnych, skrótów, dat, waluty i słownictwa technicznego. Jeśli węzeł nie oferuje słownika wymowy ani elementów sterujących w stylu SSML, zaplanuj przepisanie tekstu fonetycznie lub zapisanie liczb słowami. W przypadku serii lub kanału z marką przetestuj także spójność, uruchamiając ten sam głos w wielu generacjach, tonach i regenerowanych sekcjach, ponieważ osobne przebiegi ComfyUI dla różnych scen mogą dryfować.
Waż opóźnienie, koszt, prywatność i prawa razem. Hostowane węzły startują szybko, ale zależą od szybkości sieci, dostępności dostawcy, limitów konta i cennika za użycie, podczas gdy modele lokalne unikają opłat za żądanie, ale wymagają sprzętu i utrzymania; porównuj całkowity koszt produkcji, a nie reklamowaną stawkę. W kwestii prywatności potwierdź, jak przechowywane jest wejście, czy treść trenuje model, czy dane głosowe można usunąć, czy dozwolone jest użycie komercyjne, kto jest właścicielem wyjścia i jakiej zgody wymagają sklonowane głosy.
Gdy graf się buntuje, awarie skupiają się w krótkiej liście. Węzeł sklonowanego głosu, który zwraca błąd, często ma pusty lub nieprawidłowy voice_id; węzeł HeyGen zatrzymuje się dokładnie z tego powodu. Zbyt długie scenariusze uderzają w limity, a udokumentowany węzeł HeyGen Voice 1.0 akceptuje do 5000 znaków, ostrzegając, że bardzo długa mowa może zawieść, zwłaszcza w przypadku rozbudowanego tekstu chińskiego lub japońskiego, więc dziel narrację na logiczne sekcje. Błędna wymowa zwykle reaguje na przepisanie liczb słowami, dodanie interpunkcji lub rozpisanie akronimów. Przesadnie ekspresyjny efekt wymaga obniżenia ekspresyjności, stylu lub wahań wysokości tonu. A gdy dźwięk nie chce połączyć się dalej, sprawdź typ, ponieważ wyjście AUDIO nie może zasilić węzła oczekującego obrazu, wideo lub tekstu bez etapu konwersji. Na koniec zapisz czysty graf z nazwanymi węzłami i zapisanymi ustawieniami, bo dostawca, identyfikator głosu, język i format wyjściowy, których użyłeś, to szczegóły, których będzie potrzebować twoje przyszłe ja.
Często zadawane pytania
Czy ComfyUI jest narzędziem text-to-speech?
ComfyUI to aplikacja do przepływów pracy oparta na węzłach, a nie jeden pojedynczy silnik TTS. Może generować mowę za pomocą wbudowanych węzłów, integracji partnerskich oraz społecznościowych lub lokalnych węzłów TTS.
Czy ComfyUI może sklonować głos?
Tak, jeśli wybrana integracja lub węzeł niestandardowy obsługuje klonowanie. Dokładne wymagania dotyczące nagrania, proces identyfikatora głosu, limity i warunki komercyjne zależą od dostawcy.
Czy ComfyUI text to speech działa offline?
Może, gdy używasz zgodnego lokalnego modelu TTS i lokalnych węzłów. Węzły hostowanego dostawcy wymagają połączenia internetowego i mogą wysyłać dane tekstowe lub głosowe do dostawcy.
Jaki jest najlepszy węzeł TTS w ComfyUI?
Nie ma uniwersalnie najlepszego węzła. Wybieraj na podstawie obsługi języków, jakości głosu, potrzeb klonowania, prywatności, kosztu, opóźnienia i zgodności z resztą twojego przepływu pracy.
Czy mogę używać ComfyUI TTS do filmów na YouTube?
Tak. Wygeneruj narrację, sprawdź wymowę i prawa, wyeksportuj dźwięk i zsynchronizuj go z wideo. Jeśli używasz sklonowanego lub syntetycznego głosu, przestrzegaj obowiązujących wymagań dotyczących zgody, ujawnienia i platformy.