Een voice AI API is de programmeerbare verbinding waarmee je applicatie gesproken audio kan creëren, begrijpen, transformeren of lokaliseren met behulp van AI-modellen die je niet zelf hoeft te bouwen. Je stuurt tekst, audio of video naar een endpoint en krijgt iets bruikbaars terug: gesynthetiseerde narratie, een transcript, een aangepaste stem of een volledig nagesynchroniseerde video. De echte vraag wanneer je begint is niet of je "AI-stem" nodig hebt—maar welke stemfunctie je product daadwerkelijk vereist, want spraakgeneratie, spraakherkenning, stemklonen en nasynchronisatie zijn afzonderlijke producten die toevallig een categorienaam delen.
Deze gids behandelt wat de term betekent, de belangrijkste API-types en hoe ze verschillen, hoe een verzoek door de pijplijn beweegt, de beslissingscriteria die een goede match onderscheiden van een dure vergissing, en de risico's die het waard zijn om te beheren voordat je live gaat. Het is de hub voor onze serie voor ontwikkelaars en API's, dus je vindt links naar de diepgaandere integratiegidsen waar ze nuttig zijn.
Inhoudsopgave
Wat "voice AI API" eigenlijk betekent
De uitdrukking bundelt drie ideeën. Voice AI is kunstmatige intelligentie die werkt met menselijke spraak of synthetische spraak genereert. API is een application programming interface—een gedefinieerde manier voor twee softwaresystemen om verzoeken en antwoorden uit te wisselen. De combinatie betekent dat de zware modelverwerking aan de kant van de provider gebeurt, terwijl je applicatie de gebruikerservaring, je bedrijfsregels en de uiteindelijke content afhandelt.
Een verzoek kan zo eenvoudig zijn als een korte JSON-payload met de tekst die je wilt laten uitspreken, een stem-identificatie en een taalcode. Het antwoord retourneert doorgaans een project-identificatie, een verwerkingsstatus en een URL naar de gegenereerde audio zodra deze gereed is. Voor videolokalisatie verwijst het verzoek in plaats daarvan naar een geüpload bestand en een lijst met doeltalen.
Die structuur is wat een API onderscheidt van een browsergebaseerde stemgenerator. Een webapp is gebouwd om door een persoon handmatig bediend te worden, één taak tegelijk. Een API is gebouwd om door software herhaaldelijk, automatisch en op schaal aangeroepen te worden. Als je af en toe één voice-over produceert, is de webtool vaak sneller. Als je elke video die je publiceert lokaliseert, is de API het punt.
De vijf belangrijkste voice AI API-types
"Voice AI API" is een categorie, geen enkele technologie. De vijf gangbare types nemen verschillende invoer en retourneren verschillende uitvoer, en het kiezen van het verkeerde verspilt integratietijd. De onderstaande tabel brengt ze in kaart zodat je je uitgangsmateriaal kunt matchen met het resultaat dat je wilt.
| API-type | Invoer | Uitvoer | Typisch gebruik |
|---|---|---|---|
| Tekst-naar-spraak | Geschreven tekst | Synthetische spraakaudio | Narratie, toegankelijkheid, app-prompts, training |
| Spraak-naar-tekst | Spraak of video | Geschreven transcript | Ondertitels, zoeken, vergadernotities, hergebruik |
| Stemklonen | Geautoriseerd stemmonster | Aangepaste synthetische stem | Merkstemmen, terugkerende presentatoren, meertalige narratie |
| AI-nasynchronisatie | Video of audio | Vertaalde en ingesproken media | YouTube-lokalisatie, cursussen, films, podcasts |
| Spraak-naar-spraak | Opgenomen spraak | Getransformeerde of vertaalde spraak | Stemconversie, meertalige productie |
De selectieregel is eenvoudig. Als je al een script hebt, is tekst naar spraak meestal het eenvoudigste pad. Als je een opname hebt die een transcript nodig heeft, heb je spraak naar tekst nodig. Als je dezelfde presentatoridentiteit over meerdere talen wilt, is stemklonen of nasynchronisatie geschikter. Voor een gerichte uitleg over alleen de TTS-kant gaat onze begeleidende gids over wat een tekst-naar-spraak-API is dieper in op de synthesepijplijn.
Een belangrijk onderscheid: stemklonen is geen stemveranderaar. Een stemveranderaar transformeert een bestaande uitvoering ter plekke, terwijl klonen een herbruikbaar stemmodel creëert dat nieuwe spraak genereert uit tekst of een andere gecontroleerde invoer.
Hoe een verzoek door de pijplijn beweegt
Implementaties variëren, maar de meeste voice-API's volgen dezelfde vier stadia. Het begrijpen van de vorm van de flow bespaart uren giswerk wanneer iets een onverwachte status retourneert.
Ten eerste authenticeert je applicatie. Het stuurt een API-sleutel of bearer-token in de request-header. DubSmart's TTS API gebruikt bijvoorbeeld een REST-endpoint met bearer-token-authenticatie en JSON-verzoeken tegen de basis-URL https://dubsmart.ai/api/v1. Een regel die belangrijker is dan het klinkt: plaats nooit een privésleutel in browser-side JavaScript of een gedistribueerde mobiele app. Sla deze op op een beveiligde server en laat je client die server aanroepen.
Ten tweede stuurt je applicatie content en instellingen. Een verzoek bevat meestal een mix van tekst of een bestandsverwijzing, bron- en doeltaal, een stem-ID, snelheid of toonhoogte, sprekerinformatie, uitvoervoorkeuren en projectmetadata. Voor eenvoudige TTS is de content tekst. Voor nasynchronisatie vereist de API vaak eerst een video-upload, dan een apart verzoek om het project aan te maken.
Ten derde verwerkt de service de content. Afhankelijk van de taak kan dat betekenen: het normaliseren en interpreteren van tekst, het voorspellen van uitspraak en prosodie, het vertalen van gesproken content, het scheiden van sprekers of het isoleren van spraak uit achtergrondaudio, het genereren van audio met een standaard of aangepaste stem, en het synchroniseren van het resultaat met een videotijdlijn. Langere jobs lopen asynchroon: in plaats van een voltooid bestand te retourneren, retourneert de API een project-ID.
Ten vierde haalt je applicatie het resultaat op—een audio- of video-URL, individuele segment-URL's, een transcript, vertaalde tekst, timinggegevens en status- of foutvelden. DubSmart's TTS API documenteert projectstatussen zoals pending, processing, completed en failed, en voltooide projecten kunnen MP3-URL's retourneren op project- of segmentniveau.
Synchroon versus asynchroon: het onderscheid dat je build vormgeeft
Hoe een API resultaten retourneert bepaalt hoe je eromheen architecteert, dus beslis dit voordat je integratiecode schrijft.
Een synchrone API houdt het verzoek open totdat de verwerking klaar is, en retourneert dan het resultaat. Dat werkt goed voor korte tekst, beknopte stem-prompts, kleine audiofragmenten en interactieve functies met lage latentie. De zwakte is dat lange jobs request-timeouts kunnen overschrijden.
Een asynchrone API retourneert direct een project- of job-ID. Je applicatie peilt dan een status-endpoint of ontvangt een webhook wanneer de job klaar is. Dit model past bij lange narratie, videonasynchronisatie, meerdere doeltalen, batchgeneratie en grote bestanden. DubSmart's gedocumenteerde TTS- en nasynchronisatie-workflows gebruiken projectstatussen en resultaatophaling, wat een asynchroon patroon is dat gebouwd is voor mediajobs.
Wanneer je een optie evalueert, controleer of deze webhooks ondersteunt. Elke paar seconden peilen is triviaal te implementeren, maar webhooks verminderen onnodige verzoeken en schalen beter zodra je veel jobs tegelijk uitvoert.
Wat je moet evalueren voordat je je vastlegt
De juiste API hangt af van de taak, maar een handvol criteria is van toepassing op bijna elk project. Loop ze bewust door in plaats van te vertrouwen op een korte demo.
Functionaliteitsmatch. Bevestig dat de API de exacte taak ondersteunt—tekst naar spraak, spraak naar tekst, stemklonen, nasynchronisatie, meerdere sprekers, alleen-audio of video-uitvoer, realtime of batch. Ga er niet van uit dat alles dat als "voice AI" op de markt wordt gebracht dit allemaal bevat.
Taaldekking. Controleer bron- en doeltalen. "Ondersteunt 30 talen" kan 30 TTS-stemmen betekenen, 30 vertaaldoelen, of een mix van talen en dialecten. Voor een meertalig kanaal weeg ook accentkwaliteit, uitspraak van namen en plaatsen, regionale woordenschat, beschikbaarheid van stemmen per taal, en of één gekloonde stem over talen heen draagt.
Uitvoer- en media-ondersteuning. Verifieer audioformaten, videocontainers, samplefrequentie en bitrate, downloads op segmentniveau, volledig gerenderde video, beschikbaarheid van transcript of ondertitels, en maximale bestandsgrootte. Deze bepalen je bewerkingsworkflow en opslagkosten.
Kwaliteit en bestuurbaarheid. Luister naar natuurlijke pauzes, correcte uitspraak, stabiel volume, consistente sprekeridentiteit, gepaste nadruk en nauwkeurige timing. Een stem kan perfect klinken in een fragment van tien seconden en struikelen over technische termen, lange alinea's, cijfers of ongebruikelijke namen. Test representatieve content, niet het zorgvuldig geselecteerde fragment van de leverancier.
Latentie en doorvoer. Meet de tijd tegen je werkelijke werklast. Eén korte voice-over en honderden gelokaliseerde video's zijn verschillende problemen. Vraag of de verwerking realtime of asynchroon is, wat de rate limits zijn, of jobs parallel lopen, of er prioriteitsverwerking bestaat, en hoe fouten opnieuw worden geprobeerd. DubSmart stelt dat een typische video van vijf minuten ongeveer een minuut nodig heeft om te verwerken, met de opmerking dat de timing afhangt van lengte en bestandsgrootte.
Prijsmodel. Voice-API's kunnen factureren per teken, woord, audio- of videoduur, credits, verzoeken, opslag of gelijktijdige jobs. Voor nasynchronisatie vermenigvuldigt het aantal doeltalen de effectieve kosten. Bereken een volledige workflow—herhalingen, opnieuw gegenereerde segmenten, vertaalreview, opslag—niet alleen de eerste aanroep. Onze uitsplitsing van voice AI API-prijzen behandelt de credit-berekening in detail.
Risico's die het waard zijn om vroeg te beheren
Voice AI introduceert faalmodi die niet bestaan in gewone mediatooling. Deze tijdens het ontwerp aanpakken is veel goedkoper dan na een openbare fout.
Ongeautoriseerd stemgebruik. Het klonen van iemands stem zonder toestemming creëert juridische, ethische en reputatierisico's. Gebruik een schriftelijk toestemmingsproces dat benoemt wie de opname bezit, wat er gegenereerd mag worden, waar de stem gebruikt mag worden, of commercieel gebruik is toegestaan, hoe de stem wordt verwijderd, en wat er gebeurt wanneer de overeenkomst eindigt.
Onjuiste vertaling of uitspraak. Gegenereerde spraak kan namen, acroniemen, adressen en vaktermen verkeerd verwerken. Houd menselijke review in het proces voor publieksgerichte content: een voorlezing van het vertaalde script, een luistersessie door een moedertaalspreker, uitspraaksteekproeven, een timing- en lipbewegingscontrole, en een laatste review van de geëxporteerde media.
Imitatie en fraude. Synthetische stemmen kunnen misbruikt worden voor oplichting of valse aanbevelingen. Vermijd het genereren van iets dat een redelijke luisteraar zou kunnen doen geloven dat een echt persoon iets zei wat hij niet zei. Voeg voor gevoelige communicatie bekendmaking, goedkeuringscontroles en auditlogs toe.
Stem- en gegevensprivacy. Monsters kunnen persoonsgegevens bevatten. Regel voor het uploaden toestemming, bewaarregels, toegangsbeperkingen, verwijderingsprocedures, gegevensverwerkingsvoorwaarden van de leverancier, en een eventueel beleid voor secundair gebruik. DubSmart zegt dat geüploade kloonbestanden versleuteld zijn en dat gebruikers aangepaste stemmen en bijbehorende audiogegevens kunnen verwijderen, hoewel teams nog steeds de huidige voorwaarden en controles voor hun specifieke plan moeten bevestigen.
Leveranciers- en modelwijzigingen. Stem-ID's, taalondersteuning, uitvoerformaten en rate limits kunnen verschuiven. Behandel de API als een externe afhankelijkheid: pin configuratie waar je kunt, bewaar bronscripts, sla goedgekeurde audio op, monitor foutpercentages, houd een terugvalworkflow aan, en test opnieuw na grote leveranciersupdates. Voor teams die minder bewegende delen willen, legt onze overzicht van alles-in-één AI-videotools de afwegingen uit van het consolideren van deze functies.
Wanneer een API beter is dan een handmatige workflow
Een voice AI API verdient zijn integratiekosten terug wanneer je herhaalbare, programmatische productie nodig hebt. Het is een sterke match wanneer een maker gelokaliseerde versies van elke video publiceert, een klein bedrijf productnarratie in meerdere talen genereert, een e-learningbedrijf honderden lessen bijwerkt, een podcast vertaalde edities uitbrengt, een softwareproduct gesproken toegankelijkheid toevoegt, of een bureau stemgeneratie integreert in zijn contentmanagementsysteem.
Een handmatige studioworkflow kan in specifieke gevallen nog steeds winnen: wanneer een project afhangt van een zeer genuanceerde menselijke uitvoering, wanneer juridische goedkeuring een professionele acteur vereist, wanneer content gevoelige claims bevat, wanneer een eenmalige opname sneller is dan het bouwen van een integratie, of wanneer het resultaat zware artistieke regie nodig heeft. Het punt is niet om elke menselijke stem te vervangen. Het is om de delen te automatiseren waar consistentie, snelheid, schaal of meertalige uitvoer het meest belangrijk zijn.
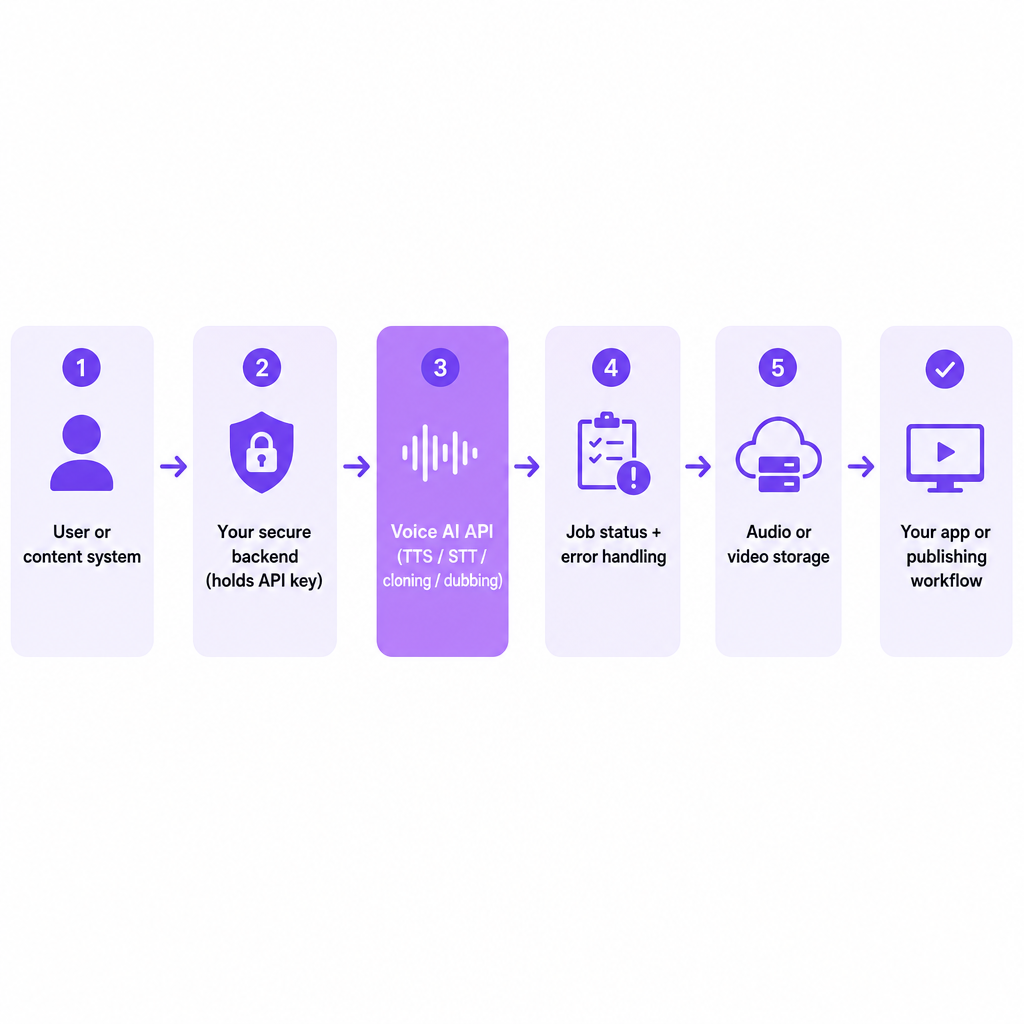
Houd voor een kleine build de architectuur eenvoudig. Een beveiligde backend zit tussen je gebruiker of contentsysteem en de voice-API. Die backend houdt inloggegevens privé, valideert invoer, maakt projecten aan, slaat job-ID's op, peilt status of ontvangt webhooks, probeert tijdelijke fouten opnieuw, slaat resultaat-URL's en metadata op, past gebruikslimieten toe, en registreert toestemming voor elke gekloonde stem. Een versie voor makers zou een afgewerkte Engelse video kunnen accepteren, deze naar een nasynchronisatie-endpoint voor de gekozen talen sturen, wachten op voltooiing, resultaten naar een reviewmap routeren, en pas publiceren na goedkeuring.
Waar DubSmart in past
We bouwen verschillende stemgerelateerde API-functies in één AI-mediaplatform, wat het belangrijkst is wanneer je generatie en lokalisatie wilt verbinden met een bestaande workflow in plaats van elke job handmatig uit te voeren.
Onze Text to Speech API biedt programmatische spraakgeneratie met neurale stemmen, stemklonen, meertalige ondersteuning, projectstatustracking en MP3-resultaten—het voorbeeldverzoek gebruikt tekstsegmenten met een stem-ID, taal, snelheid en toonhoogte. Onze Voice Cloning API volgt een driestappenpatroon: vraag een presigned upload-URL aan, upload een audiomonster, maak dan een aangepaste stem aan van de geüploade bestandssleutel; het accepteert MP3, WAV, AAC, M4A en FLAC, en we raden minstens 20 seconden schone audio aan voor betere resultaten. Onze AI Dubbing API verzorgt videolokalisatie met meertalige projectcreatie, sprekerinstellingen, vertaalde segmenten en downloadbare nagesynchroniseerde uitvoer, en accepteert invoer zoals MP4, MOV, AVI, MKV en WebM tot 5GB.
Als je afweegt met welk endpoint je moet beginnen, match het met je content: scripted narratie wijst naar TTS, een geautoriseerde terugkerende stem wijst naar klonen, en meertalige video wijst naar nasynchronisatie.
Veelgestelde vragen
Wat is een voice AI API in eenvoudige termen?
Het is een verbinding waarmee software spraak kan genereren, herkennen, klonen, vertalen of transformeren zonder zijn eigen AI-stemsysteem te bouwen. Je app stuurt een verzoek en ontvangt verwerkte audio, tekst of video.
Is een voice AI API hetzelfde als tekst naar spraak?
Nee. Tekst naar spraak is één type voice AI API. De categorie omvat ook spraakherkenning, stemklonen, nasynchronisatie en spraak-naar-spraak-functies.
Heb ik programmeerervaring nodig om er een te gebruiken?
Meestal wel wat, omdat API's authenticatie, HTTP-verzoeken, JSON, bestandsuploads en statusafhandeling omvatten. Voor incidentele handmatige jobs is een no-code webapp vaak eenvoudiger.
Kan een voice AI API een YouTube-video vertalen?
Een nasynchronisatie-API kan een video vertalen en nieuwe audio genereren wanneer deze de vereiste bron- en doeltalen, het bestandsformaat en de uitvoerworkflow ondersteunt. Bekijk het resultaat voordat je publiceert.
Kan ik de stem van elke persoon klonen?
Technisch mogelijk is niet hetzelfde als juridisch of ethisch toegestaan. Kloon een stem alleen met gepaste toestemming, en volg de regels van de provider, je contracten, en toepasselijke privacy- en publiciteitsvereisten.