De snelste manier om een video naar tekst te transcriberen is door een AI-spraak-naar-tekst-tool de eerste ronde te laten doen: upload het videobestand of plak een YouTube-link, laat het systeem de gesproken audio omzetten in een bewerkbaar transcript en controleer vervolgens de delen die het meest waarschijnlijk fout zijn. Die laatste stap is belangrijker dan de meeste mensen verwachten, want "snel" zou een snel eerste transcript plus een korte kwaliteitscontrole moeten betekenen, niet directe perfectie. Handmatig typen betekent daarentegen stoppen, terugspoelen en elke regel opnieuw typen, en daar verdwijnen de uren.
Als je de praktische versie wilt van hoe je een video naar tekst transcribeert, dan accepteert onze Speech to Text-workflow video-uploads en YouTube-links, kun je het resulterende project bewerken, ondersteunt het meer dan 60 talen en verwerkt het bestanden tot 5 GB zonder vermelde limiet voor videolengte. De rest van deze gids legt het mechanisme daarachter uit, hoe je de juiste uitvoer kiest en hoe je de nauwkeurigheid hoog houdt wanneer de audio tegenwerkt.
Inhoudsopgave
Wat het transcriberen van een video naar tekst eigenlijk inhoudt
Videotranscriptie zet de gesproken audio in een video om in geschreven woorden. Die ene uitvoer kan vele doeleinden dienen: een volledig videotranscript, ondertitels of gesloten bijschriften, een montagescript, een blog- of nieuwsbriefconcept, doorzoekbare verslagen van vergaderingen en lezingen, of brontekst die je later vertaalt voor nieuwe doelgroepen.
Het helpt om drie termen te scheiden die vaak door elkaar lopen. Transcriptie houdt de oorspronkelijke gesproken taal in tekstvorm. Vertaling zet die inhoud om in een andere taal. Nasynchronisatie vervangt of voegt gesproken audio in een andere taal toe. Je transcribeert eerst en beslist daarna of vertaling of nasynchronisatie de volgende stap is. Als je de diepere definitie wilt van de herkenningstechnologie achter dit alles, behandelt onze gids over hoe spraak-naar-tekst werkt de basis.
Hoe AI-videotranscriptie onder de motorkap werkt
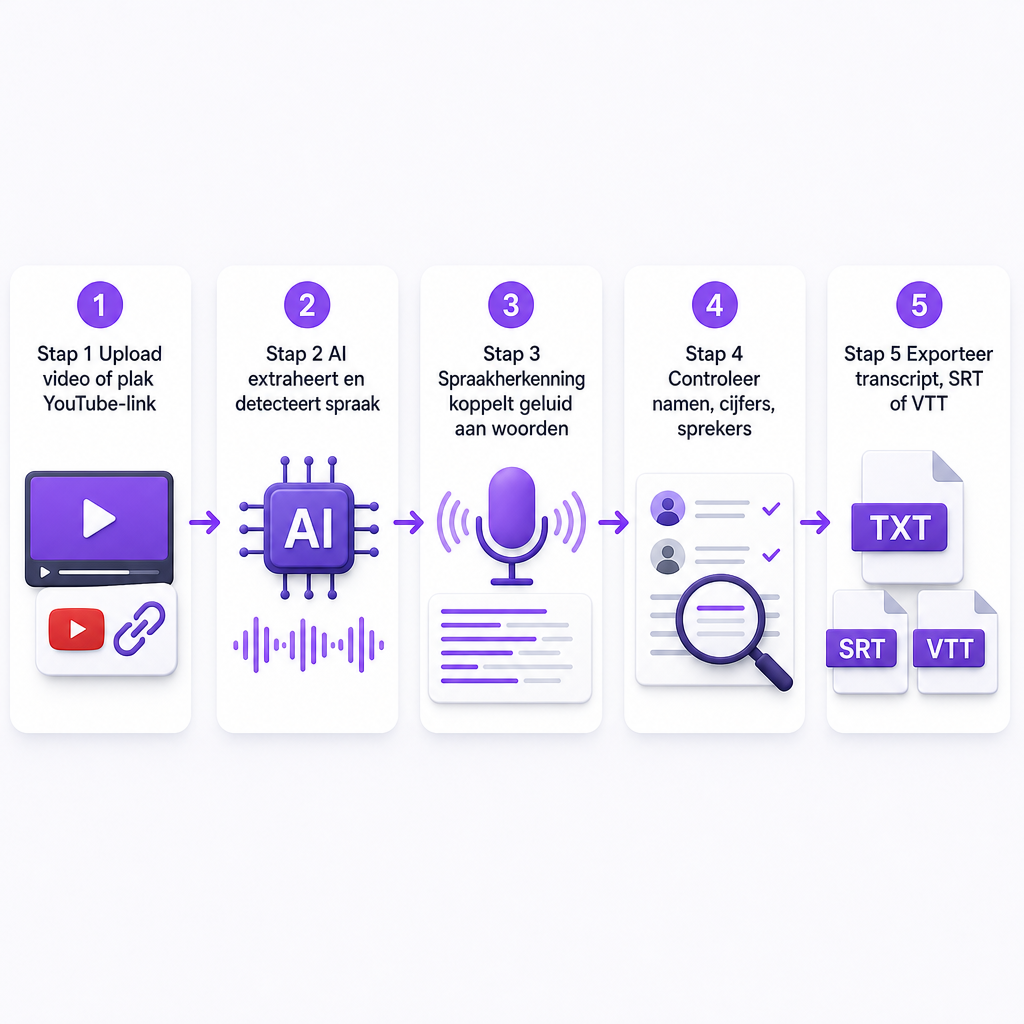
Kennis van de pijplijn helpt je te voorspellen waar fouten vandaan komen. De meeste automatische transcriptiesystemen doorlopen dezelfde fasen. Eerst leest het systeem de audiotrack in de video. Vervolgens detecteert het welke delen daadwerkelijk spraak bevatten. Een herkenningsmodel koppelt dan geluidspatronen aan woorden, en een taalverwerkingsstap gebruikt de omringende context om die voorspellingen te verbeteren. De herkende woorden worden samengevoegd tot zinnen of getimede segmenten, en ten slotte corrigeer en exporteer je het resultaat.
Het herkenningsmodel is slechts een deel van de kwaliteitsvergelijking. Microfoonkwaliteit, overlappende sprekers, accenten, achtergrondmuziek, galm in de ruimte, technisch vocabulaire en onderbrekingen bepalen allemaal de uitvoer. Ons Speech to Text-systeem is gebouwd om rumoerige omgevingen, meerdere sprekers en verschillende talen en dialecten aan te kunnen, met de eerlijke kanttekening dat de nauwkeurigheid varieert met de audiokwaliteit en accentdiversiteit. Die kanttekening is de reden waarom de controleronde bestaat, en geen gebrek dat verborgen moet worden.
Transcript, bijschriften of ondertitels: kies de juiste uitvoer
Het beste exportformaat hangt volledig af van waar de tekst voor is, en een verkeerde keuze kost later tijd.
Een gewoon transcript is leesbare tekst zonder vereiste timing. Gebruik het wanneer je onderzoeksnotities, vergaderverslagen, een videoscript, een blog- of nieuwsbriefconcept of content om opnieuw te gebruiken nodig hebt. Tijdstempels zijn hier optioneel, al helpen ze redacteuren om snel te navigeren.
Bijschriften synchroniseren tekst met de video en kunnen relevante niet-spraakinformatie bevatten, zoals muziek, applaus of een dichtvallende deur. Ze zijn belangrijk voor toegankelijkheid en voor iedereen die zonder geluid kijkt. Ondertitels tonen doorgaans gesproken dialoog voor kijkers die de taal niet verstaan. Wanneer je ondertitels in een andere taal nodig hebt, transcribeer je eerst het origineel en vertaal en time je daarna de vertaalde tekst.
Voor getimede formaten is WebVTT een webstandaard voor tijdgelijnde tekstsporen; de W3C WebVTT-specificatie beschrijft het als een formaat voor bijschriften, ondertitels, hoofdstukken, beschrijvingen en andere metadata die gesynchroniseerd is met audio of video. Voor YouTube-uploads behoren SubRip .srt en .vtt beide tot de ondersteunde ondertitelformaten, en YouTube merkt op dat basis-.srt-bestanden gewone UTF-8-codering moeten gebruiken.
Maak de audio schoon voordat je rumoerige video transcribeert
Achtergrondgeluid is een van de meest voorkomende oorzaken van transcriptiefouten. Straatgeluiden, airconditioning, microfoonfeedback, concurrerende muziek en galm in de ruimte vervagen allemaal de grenzen tussen woorden, en het herkenningsmodel heeft minder signaal om mee te werken.
De oplossing is om de spraak te isoleren vóór de transcriptie. Onze Speech Separator verwijdert achtergrondgeluid en scheidt gesproken woorden van de omringende audio, met ondersteuning voor grote formaten zoals MP3, WAV en AAC, evenals videobestanden. Hij verdient zijn plaats in de workflow voor buiten opgenomen interviews, podcasts opgenomen in onbehandelde ruimtes, video's met zware achtergrondmuziek, paneldiscussies met ongelijke microfoonniveaus en archiefbeelden met bromgeluid of omgevingsgeluid.
Eén waarschuwing voor toegankelijkheidswerk: verwijder niet reflexmatig elk geluid. Als een geluid betekenis draagt, zoals een sirene, een alarm of een luidsprekeraankondiging, kan het nog steeds vertegenwoordigd moeten worden in de bijschriften, zelfs wanneer het wordt uitgesloten van het schone spraakspoor dat je voor transcriptie verstuurt.
Hoe je de transcriptienauwkeurigheid verbetert
Behandel AI-transcriptie als een sterk eerste concept en pas vervolgens gerichte controles toe in plaats van alles blind opnieuw te lezen.
Begin met het helderste bronbestand. Upload de originele opname in plaats van een gecomprimeerde download van social media, want een schoner spraaksignaal geeft het model meer om mee te werken. Verminder concurrerende audio door achtergrondmuziek te verlagen of te verwijderen, en gebruik het schoonste beschikbare spraakspoor als de video aparte sporen heeft. Selecteer de taal of het dialect dat overeenkomt met de opname wanneer die optie bestaat, wat het systeem helpt uitspraak, spelling en zinsstructuur te interpreteren.
Richt je vervolgens op de voorspelbare faalpunten. Zoek het transcript door op eigennamen zoals namen, merken, locaties, producttermen en jargon in plaats van te vertrouwen op een algemene lezing. Controleer sprekerwisselingen en voeg handmatig sprekerlabels toe wanneer het transcript voor juridische, educatieve, onderzoeks- of redactionele doeleinden wordt gebruikt. Verifieer korte, betekeniskritische items: datums, prijzen, percentages, metingen, URL's, acroniemen, ontkenningen zoals "niet" en gelijkklinkende woorden, want één misstap kan een zin omkeren.
De meest betrouwbare methode is om de video af te spelen terwijl je het transcript volgt. Voor een lange opname spring je eerst naar secties met namen, cijfers, onduidelijke audio of overlappende stemmen. Dit weerspiegelt een waarschuwing die het waard is om te internaliseren: automatische bijschriften kunnen spraak verkeerd weergeven door verkeerde uitspraken, accenten, dialecten en achtergrondgeluid.
De workflow afstemmen op je contenttype
Verschillende formaten belasten verschillende delen van het proces, dus pas aan waar je je controletijd besteedt.
Voor YouTube-video's voedt een transcript bijschriften, beschrijvingen, hoofdstukken, clipselectie en op zoeken gerichte herbestemming; gebruik de originele upload of een bron van hoge kwaliteit wanneer je de video bezit. Interviews en podcasts hebben meestal sprekerlabels en een sterkere geluidsverwerking nodig, dus maak audio uit drukke omgevingen eerst schoon en houd de sprekeridentiteit consistent. E-learning- en trainingsvideo's moeten prioriteit geven aan nauwkeurigheid in instructies, terminologie, cijfers en verwijzingen op het scherm, met bijschriften die nauw genoeg zijn gesynchroniseerd zodat cursisten de uitleg en het scherm samen volgen.
Zakelijke vergaderingen worden doorzoekbare verslagen en actiepunten, maar gevoelige gesprekken vragen extra zorg: verifieer namen, beslissingen, datums en toegewezen verantwoordelijkheden voordat je deelt. Korte social media-video's zetten het transcript vaak om in bijschriften op het scherm, een postbeschrijving of vertaalde versies, dus houd regelafbrekingen kort voor mobiel en zorg dat bijschriften belangrijke beelden niet bedekken.
Hoe je een video-naar-tekst-tool kiest
Evalueer de hele workflow, niet alleen een geadverteerd nauwkeurigheidscijfer. De tabel hieronder brengt de criteria in kaart die je doorlooptijd en uitvoerkwaliteit daadwerkelijk veranderen.
| Beslissingscriterium | Wat te controleren |
|---|---|
| Invoerondersteuning | Accepteert het je video, audio of een YouTube-URL? |
| Bestandslimieten | Wat is de maximale bestandsgrootte en videoduur? |
| Taaldekking | Ondersteunt het je taal, dialect en accenten? |
| Sprekerverwerking | Kun je meerdere sprekers identificeren of scheiden? |
| Uitvoerformaten | Kun je platte tekst, SRT of VTT exporteren? |
| Integratie | Is er een API om video's op schaal te verwerken? |
Onze openbare Speech to Text-pagina bevestigt invoer van video en YouTube-links, bewerkbare projecten, downloads, ondersteuning voor meer dan 60 talen en een limiet van 5 GB. We vermelden op die pagina niet of elke uitvoer tijdstempels bevat, hoe lang bestanden worden bewaard, of sprekeridentificatie automatisch is, dus bevestig die specifieke punten voor je eigen workflow voordat je gevoelige of grootschalige content vastlegt. Als een van die antwoorden doorslaggevend voor je is, vertel ons dan je bestandstype, taal, aantal sprekers en gewenste uitvoer, en we kunnen je naar de juiste configuratie verwijzen.
Privacy, rechten en een verstandige controlestandaard
Een transcript kan vertrouwelijke bedrijfsinformatie, persoonsgegevens, klantgesprekken, nog niet uitgebrachte content of auteursrechtelijk beschermd materiaal bevatten. Bevestig voordat je uploadt dat je toestemming hebt om de opname te verwerken, dat eventuele vereiste sprekertoestemming bestaat en of de video vertrouwelijke of gereguleerde informatie bevat. Controleer hoe een aanbieder geüploade bestanden en gegenereerde transcripten opslaat en verwijdert, wie toegang heeft tot het project en de exports, en of bestanden gebruikt mogen worden voor modeltraining. Onthoud dat het transcriberen van een auteursrechtelijk beschermde opname technisch gemakkelijk is maar geen toestemming geeft om de inhoud ervan te verspreiden; je hebt nog steeds rechten nodig om de bron, het transcript, de bijschriften of de vertalingen te publiceren.
Stem de diepgang van de controle af op de belangen. Een lichte controle past bij social clips, interne notities en ruwe ideevorming: scan op voor de hand liggende fouten, namen, cijfers en ontbrekende zinnen. Een volledige controle past bij cursussen, openbare bijschriften, interviews, klantgegevens, juridisch materiaal en alles wat gepubliceerd wordt: luister naar de volledige opname, corrigeer de formulering, verifieer sprekerlabels, controleer tijdstempels en bevestig dat bijschriften voldoen aan de formaatregels van het bestemmingsplatform. Kijk voor toegankelijkheid verder dan de dialoog, want belangrijke geluidseffecten, sprekerwisselingen en betekenisvolle aanwijzingen moeten mogelijk in bijschriften worden weergegeven.
Het efficiënte pad is elke keer hetzelfde: begin met de helderste video die je hebt, isoleer de spraak wanneer de audio lastig is, genereer een bewerkbaar transcript, verifieer namen en cijfers en exporteer het formaat dat je platform vereist. Voor teams die over talen heen werken, is dat transcript ook het natuurlijke startpunt voor latere vertaling en nasynchronisatie.
Veelgestelde vragen
Wat is de snelste manier om een video naar tekst te transcriberen?
Gebruik een automatische spraak-naar-tekst-tool die de video rechtstreeks accepteert of een YouTube-link ondersteunt. Upload de helderste bron, selecteer de juiste taal, genereer het transcript en controleer vervolgens eerst de meest foutgevoelige secties.
Kan ik een video transcriberen zonder handmatig te typen?
Ja. AI-spraak-naar-tekst-tools zetten gesproken audio automatisch om in bewerkbare tekst. Je moet de uitvoer nog steeds controleren, want de nauwkeurigheid kan variëren met geluid, accenten, overlappende spraak en gespecialiseerd vocabulaire.
Kan DubSmart een lange video transcriberen?
Ja. Onze Speech to Text-tool accepteert geüploade audio of video en YouTube-links, ondersteunt bewerken en laat je het voltooide project downloaden. We vermelden ondersteuning voor meer dan 60 talen en een bestandslimiet van 5 GB, zonder vermelde limiet voor videolengte; de werkelijke verwerkingstijd varieert met het bestand en de audio.
Wat moet ik doen als het transcript veel fouten bevat?
Verbeter eerst de bronaudio. Verwijder concurrerend geluid met een spraakscheidingstool, bevestig de geselecteerde taal, en genereer of bewerk vervolgens het transcript, met speciale aandacht voor eigennamen, cijfers, accenten en overlappende sprekers.
Welk ondertitelformaat moet ik gebruiken?
Gebruik het formaat dat je platform vereist. SRT wordt breed ondersteund, terwijl WebVTT een webgericht tijdgelijnd tekstformaat is, en YouTube ondersteunt beide onder zijn ondertitelformaten.