Als je op comfyui text to speech bent terechtgekomen in de verwachting dat er één knop is die een script in audio omzet, is het eerste dat je moet weten dat ComfyUI helemaal geen stemengine is. Het is een node-gebaseerde werkruimte waarin je tekst, een stem, een model, taal en een audio-uitvoer samen bedraadt tot een herbruikbare graaf. De spraak zelf komt van welk TTS-node je ook verbindt: een gehoste aanbieder, een officiële partnerintegratie of een lokaal model dat je zelf installeert. De vraag die er werkelijk toe doet, is dus niet of ComfyUI je script kan uitspreken, want dat kan het, maar of een visuele graaf de juiste plek is voor het werk dat je moet herhalen.
Dat onderscheid bepaalt elke andere beslissing op deze pagina. ComfyUI beloont experimenten en multimodale pipelines waarin voice-over naast beeld-, video- en audiogeneratie staat. Een speciaal spraakprogramma beloont herhaalbare productie waarbij je simpelweg telkens weer schone voice-overs nodig hebt. Hieronder leggen we uit hoe de workflow werkt, welke optietypen er bestaan, hoe je ze beoordeelt en wanneer een graaf het onderhoud niet langer waard is.
Inhoudsopgave
Wat ComfyUI text to speech eigenlijk is
ComfyUI text to speech is de praktijk waarbij je een ComfyUI-graaf gebruikt om geschreven tekst om te zetten in een AUDIO-uitvoer. De officiële documentatie beschrijft ComfyUI als een open-source, node-gebaseerde applicatie voor het bouwen van workflows voor beeld-, video-, audio- en 3D-generatie, en de audio-nodes verbinden externe spraakdiensten of modellen met datzelfde visuele canvas.
Een werkende spraakgraaf is klein. Hij heeft een tekst- of prompt-invoer nodig, een TTS-node, een stem- of referentie-audio-invoer, optionele taal- en weergave-instellingen en een audiovoorbeeld- of opslag-node. De TTS-node stuurt je script door een spraakmodel en geeft gegenereerde audio terug die latere nodes kunnen gebruiken.
Het praktische gevolg is dat ComfyUI de workflowlaag is, niet het model. De werkelijke stem kan worden geproduceerd door een gehoste aanbieder, een partner-audiomodel, een custom node van derden of een lokaal geïnstalleerd systeem. Door dat onderscheid te begrijpen blijven je verwachtingen correct: je stelt een pipeline samen en je kiest nog steeds zelf de engine erin.
Hoe de workflow in vier fasen werkt
Haal de node-namen weg en elke ComfyUI-spraakgraaf doet achtereenvolgens dezelfde vier dingen.
Ten eerste komt het script binnen als tekst. De TTS-node kan platte tekst direct aannemen, of de tekst kan binnenstromen vanuit een andere node die een langer script laadt, vertaalt of segmenteert. Door een lange vertelling op te splitsen in logische secties kun je één alinea opnieuw genereren zonder de hele voice-over opnieuw op te bouwen, en het helpt je onder het invoerplafond van een aanbieder te blijven.
Ten tweede selecteert de workflow een stem en een model. Afhankelijk van de aanbieder kan dat een vooraf ingestelde spreker, een gekloonde stem, een stem-ID of een referentie-opname zijn. De modelkeuze bepaalt ook de snelheid, kwaliteit, expressieve reikwijdte en kosten. De HeyGen-node van ComfyUI biedt bijvoorbeeld zowel heygen-voice-1 als een snellere, goedkopere heygen-voice-1-turbo, terwijl de ElevenLabs-node bedieningselementen zoals stabiliteit, snelheid en stijl aanbiedt.
Ten derde synthetiseert het spraakmodel audio. Moderne neurale systemen schatten uitspraak, ritme, pauzes en toonhoogtebeweging in in plaats van vooraf opgenomen woorden aan elkaar te plakken, en ze geven een golfvorm terug die je verder kunt routeren: opgeslagen in een bestand, gemengd met muziek, in een videograaf gezet of gekoppeld aan een avatar.
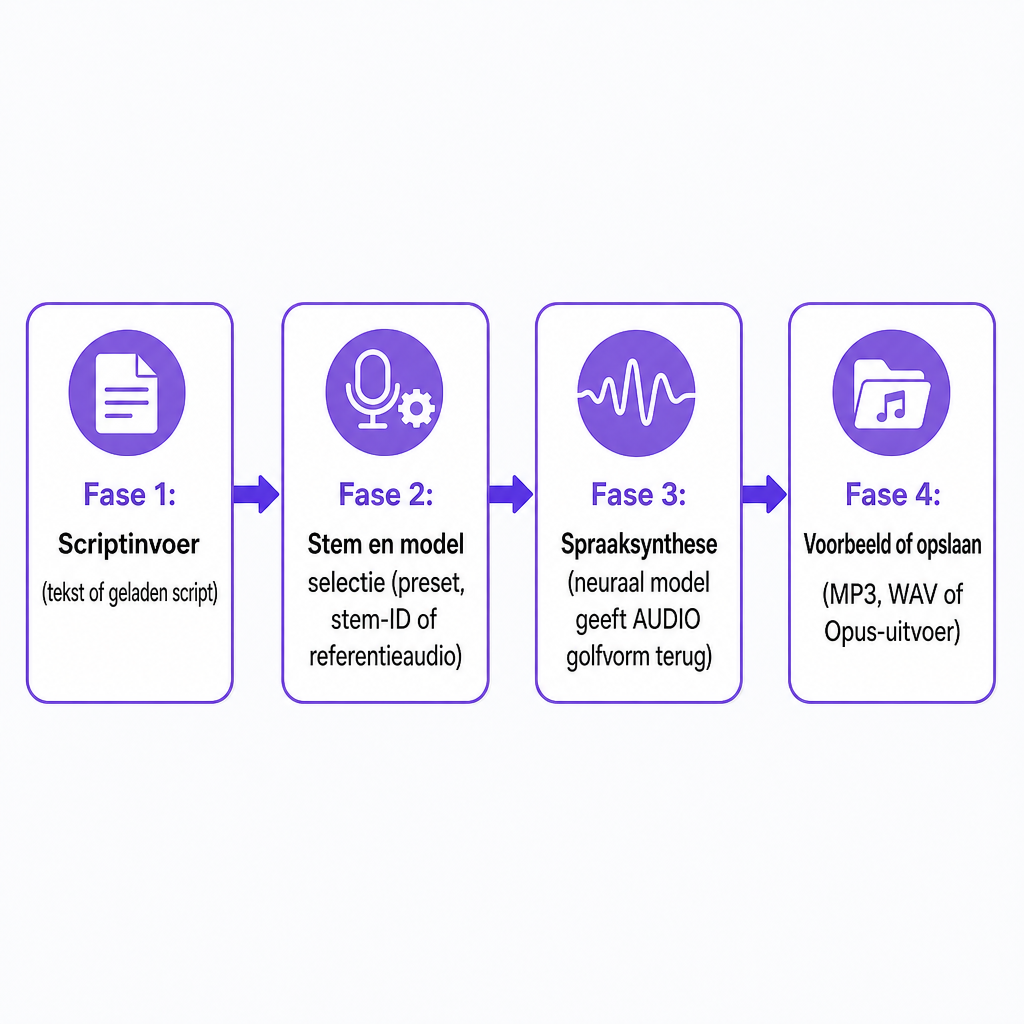
Ten vierde wordt de audio als voorbeeld weergegeven of opgeslagen. TTS-nodes geven meestal een AUDIO-object af dat verbindt met een voorbeeld- of opslag-node, waarbij het bestandsformaat wordt ingesteld door de node en aanbieder; de documentatie van de ElevenLabs-node noemt bijvoorbeeld selecteerbare formaten waaronder MP3- en Opus-varianten. Omdat de graaf visueel is, is de lus eenvoudig opnieuw uit te voeren: wijzig het script, de stem, de taal of het model en zet het opnieuw in de wachtrij.
De drie manieren om TTS in ComfyUI uit te voeren
Er is geen enkele ComfyUI-spraakmethode, en de verschillen komen neer op opzet, controle, privacy en hoeveel onderhoud je bereid bent op je te nemen.
Gehoste aanbieder-nodes sturen je tekst en steminstellingen naar een externe dienst en geven voltooide audio terug. Dit is meestal de snelste weg naar hoogwaardige spraak, omdat het model op de infrastructuur van de aanbieder draait. De HeyGen Voice 1.0-node illustreert het patroon: hij vereist een geldige gekloonde stem-ID, stuurt de tekst en ID naar HeyGen en geeft de spraak terug. De afwegingen zijn ook voorspelbaar: een account of API-verbinding kan vereist zijn, gebruik kan aanbiederscredits verbruiken, je tekst en audio worden door een derde partij verwerkt, en de limieten of prijzen van de aanbieder kunnen veranderen.
Officiële partner-audio-nodes breiden hetzelfde idee uit over een groter deel van de audioruimte. De audiodocumentatie van ComfyUI scheidt tekst-naar-audiogeneratie van stem-en-spraak-toepassingen, waaronder spraak uit tekst en uit referentie-audio. Deze integraties komen tot hun recht wanneer je graaf al afhankelijk is van andere gehoste mediamodellen, omdat ze het heen en weer schuiven van bestanden tussen aparte applicaties verminderen.
Community- en lokale TTS-nodes verbinden ComfyUI met systemen zoals Edge TTS, Kokoro, Index-TTS en andere modellen die lokaal kunnen draaien. Lokale workflows kunnen je meer controle geven over je gegevens en modelkeuze, maar ze vragen er meer voor terug: installatie, compatibele hardware, modeldownloads en het oplossen van problemen. Een lokale node is niet automatisch beter dan een gehoste. Het werkelijke voordeel hangt af van of je machine het model efficiënt kan draaien, of de stemkwaliteit standhoudt, of je taal wordt ondersteund, of de licentie commercieel gebruik toestaat en of je de workflow na verloop van tijd in leven kunt houden.
Stemklonen en de bedieningselementen die je kunt verwachten
Stemklonen voegt een referentie-identiteit toe aan de graaf in plaats van een standaardspreker. De structuur bestaat meestal uit twee verbonden delen: een kloon-node die een stemidentiteit creëert of teruggeeft, en een TTS-node die die identiteit gebruikt om nieuwe tekst uit te spreken. De HeyGen-documentatie beschrijft dit rechtstreeks, waarbij een Instant Clone-node een voice_id produceert die de Voice 1.0 Text to Speech-node voedt; die kloon-workflow vraagt om minstens 10 seconden heldere spraak, en de TTS-node accepteert tot 5.000 tekens per verzoek.
Kloon alleen met toestemming. Reproduceer niet de stem van een echte persoon alleen omdat je een opname kunt bereiken. Vraag toestemming, bewaar het bewijs ervan en maak synthetische of gekloonde spraak kenbaar overal waar de context een publiek zou kunnen misleiden.
Naast de stem zelf variëren de bedieningselementen die je tegenkomt per node en model, maar een bekende reeks keert bij de meeste ervan terug.
- Stem: de spreker-identiteit of preset
- Taal: de taal die wordt gebruikt om het script te interpreteren
- Snelheid: hoe snel de vertelling wordt gebracht
- Toonhoogte: de waargenomen hoogte of laagte van de stem
- Stijl en expressiviteit: het karakter van de voordracht en hoe sterk emotie wordt toegepast
- Stabiliteit: hoe consistent de stem haar kenmerken behoudt
- Uitvoerformaat: zoals MP3, WAV of Opus
- Referentie-audio: een opname die wordt gebruikt voor klonen of spraaktransformatie
Sommige modellen gaan verder met inline-aanwijzingen. De documentatie van de Fish Audio-node ondersteunt emotie-aanwijzingen en multi-spreker-dialoogtags in ondersteunde modellen. Eén waarschuwing geldt voor allemaal: deze bedieningselementen zijn niet uitwisselbaar tussen aanbieders, en een instelling die in de ene node stijl heet, kan zich totaal anders gedragen dan stijl in een andere.
ComfyUI versus een speciaal TTS-platform
ComfyUI verdient zijn plaats wanneer spraak één onderdeel is van een grotere mediapipeline. Een speciaal platform wint doorgaans wanneer het enige echte werk bestaat uit het omzetten van scripts in gepolijste vertelling zonder een graaf samen te stellen.
| Beslissingsfactor | ComfyUI | Speciaal TTS-platform |
|---|---|---|
| Workflowflexibiliteit | Hoog; verbind TTS met andere media-nodes | Meestal gericht op spraakproductie |
| Opzet | Kan nodes, aanbiederskoppelingen of modelinstallaties vereisen | Vaak sneller voor de eerste generatie |
| Stemopties | Afhankelijk van geïnstalleerde of verbonden nodes | Meestal één georganiseerde stembibliotheek |
| Automatisering | Sterk voor herbruikbare visuele grafen | Vaak via API of batchtools |
| Lokale verwerking | Mogelijk met lokale nodes en modellen | Meestal cloudgebaseerd |
| Beste toepassing | Experimentele of multimodale pipelines | Herhaalbare vertelling en productie |
Voor makers die een visuele pipeline bouwen die spraak combineert met beeld, video of audioverwerking, betaalt de graaf zichzelf terug. Voor YouTube-vertelling, e-learning-voice-overs, podcasts of lokalisatieteams die een voorspelbare interface nodig hebben, verwijdert een gespecialiseerde dienst meestal de technische overhead. Onze Text to Speech-workflow is gebouwd rond directe script-naar-audiogeneratie, met 300+ AI-stemmen, stemklonen in 33 talen, instelbare spreeksnelheid, emotionele dialoogaanwijzingen en downloadbare projecten. Wanneer generatie binnen een applicatie of een geautomatiseerde contentpipeline moet leven, verzorgt onze Text to Speech API de integratiekant, en onze AI Dubbing API breidt hetzelfde idee uit naar vertaalde, stemgematchte video.
Hoe je je opstelling kiest en problemen oplost
Voordat je je vastlegt op een node of model, voer je een paar bewuste controles uit in plaats van op een korte demo te vertrouwen.
Beoordeel de stemkwaliteit op een moeilijk voorbeeld, niet op een makkelijk voorbeeld. Genereer een passage met namen, cijfers, acroniemen, lange zinnen, vragen, merktermen en minstens één emotionele regel in je doeltaal en accent. Een stem die je bekoort in een oneliner kan een productnaam verminken of het ritme verliezen over een alinea.
Controleer taal- en accentondersteuning per taal, niet in totaal. Sommige systemen detecteren de taal automatisch terwijl andere vereisen dat je deze instelt, en de documentatie van de HeyGen-node raadt aan de taal handmatig in te stellen voor nauw verwante talen waar automatische detectie onbetrouwbaar kan zijn. Onthoud dat een vloeiende stem een onnauwkeurige vertaling niet kan redden; stemkwaliteit en vertaalkwaliteit zijn aparte problemen.
Meet de uitspraakcontrole voor de woorden die engines daadwerkelijk doen struikelen: productnamen, eigennamen, afkortingen, datums, valuta en technisch vocabulaire. Als een node geen uitspraakwoordenboek of SSML-achtige bedieningselementen biedt, plan dan om tekst fonetisch te herschrijven of cijfers voluit te spellen. Voor een serie of een merkkanaal test je ook de consistentie door dezelfde stem over meerdere generaties, tonen en opnieuw gegenereerde secties te draaien, aangezien aparte ComfyUI-runs voor verschillende scènes kunnen afdrijven.
Weeg latentie, kosten, privacy en rechten samen af. Gehoste nodes starten snel maar zijn afhankelijk van netwerksnelheid, beschikbaarheid van de aanbieder, accountlimieten en prijzen per gebruik, terwijl lokale modellen kosten per verzoek vermijden maar hardware en onderhoud vereisen; vergelijk de totale productiekosten, niet het geadverteerde tarief. Bevestig wat privacy betreft hoe invoer wordt opgeslagen, of content het model traint, of stemgegevens kunnen worden verwijderd, of commercieel gebruik is toegestaan, wie de uitvoer bezit en welke toestemming gekloonde stemmen vereisen.
Wanneer een graaf zich misdraagt, clusteren de storingen zich in een korte lijst. Een gekloonde-stem-node die een fout teruggeeft heeft vaak een lege of ongeldige voice_id; de HeyGen-node stopt om precies die reden. Te lange scripts stuiten op limieten, en de gedocumenteerde HeyGen Voice 1.0-node accepteert tot 5.000 tekens en waarschuwt dat zeer lange spraak kan mislukken, met name voor uitgebreide Chinese of Japanse tekst, dus splits de vertelling op in logische secties. Verkeerde uitspraak reageert meestal op het herschrijven van cijfers in woorden, het toevoegen van interpunctie of het voluit spellen van acroniemen. Overexpressieve uitvoer vraagt om minder expressiviteit, stijl of toonhoogtevariatie. En wanneer audio niet verder wil verbinden, controleer het type, aangezien een AUDIO-uitvoer geen node kan voeden die een beeld, video of tekst verwacht zonder een conversiestap. Sla ten slotte een schone graaf op met benoemde nodes en opgenomen instellingen, want de aanbieder, stem-ID, taal en het uitvoerformaat die je hebt gebruikt zijn de details die jij-in-de-toekomst nodig zult hebben.
Veelgestelde vragen
Is ComfyUI een tekst-naar-spraak-tool?
ComfyUI is een node-gebaseerde workflowapplicatie in plaats van één enkele TTS-engine. Het kan spraak genereren via ingebouwde nodes, partnerintegraties en community- of lokale TTS-nodes.
Kan ComfyUI een stem klonen?
Ja, als de geselecteerde integratie of custom node klonen ondersteunt. De exacte opname-eisen, het stem-ID-proces, de limieten en de commerciële voorwaarden hangen af van de aanbieder.
Werkt ComfyUI text to speech offline?
Dat kan wanneer je een compatibel lokaal TTS-model en lokale nodes gebruikt. Gehoste aanbieder-nodes vereisen een internetverbinding en kunnen tekst- of stemgegevens naar de aanbieder sturen.
Wat is de beste ComfyUI TTS-node?
Er is geen universele beste node. Kies op basis van taalondersteuning, stemkwaliteit, kloonbehoeften, privacy, kosten, latentie en compatibiliteit met de rest van je workflow.
Kan ik ComfyUI TTS gebruiken voor YouTube-video's?
Ja. Genereer de vertelling, controleer uitspraak en rechten, exporteer de audio en synchroniseer deze met je video. Als je een gekloonde of synthetische stem gebruikt, volg dan de toepasselijke toestemmings-, kenbaarheids- en platformvereisten.