Content hergebruiken voor een nieuw publiek vereist zelden tweemaal dezelfde stemtechnologie, en dat is precies waarom de vraag ai nasynchronisatie versus stemklonen voor hergebruik steeds weer opkomt. Hier is het korte antwoord dat we elke week aan makers en teams geven: AI-nasynchronisatie lokaliseert een bestaand stuk content, terwijl stemklonen de identiteit van een specifieke spreker behoudt wanneer je nieuwe of vertaalde spraak genereert. De ene is een lokalisatieworkflow. De andere is een stemidentiteitsmogelijkheid. Ze overlappen vaak genoeg dat de meest voorkomende productieopzet eigenlijk beide gebruikt.
AI-nasynchronisatie lokaliseert een bestaand stuk content. Stemklonen behoudt de identiteit van de spreker bij het maken van nieuwe of vertaalde spraak.
Die scheiding bepaalt bijna alles verderop: je tijdlijn, je beoordelingsproces, je rechtenpapierwerk, en of je naar een browserstudio of een API grijpt. Hieronder definiëren we elke technologie, laten we zien waar ze elkaar ontmoeten, en geven we je een beslissingskader dat je vandaag kunt toepassen op een echte hergebruikklus.
Inhoudsopgave
Het essentiële verschil, in één oogopslag
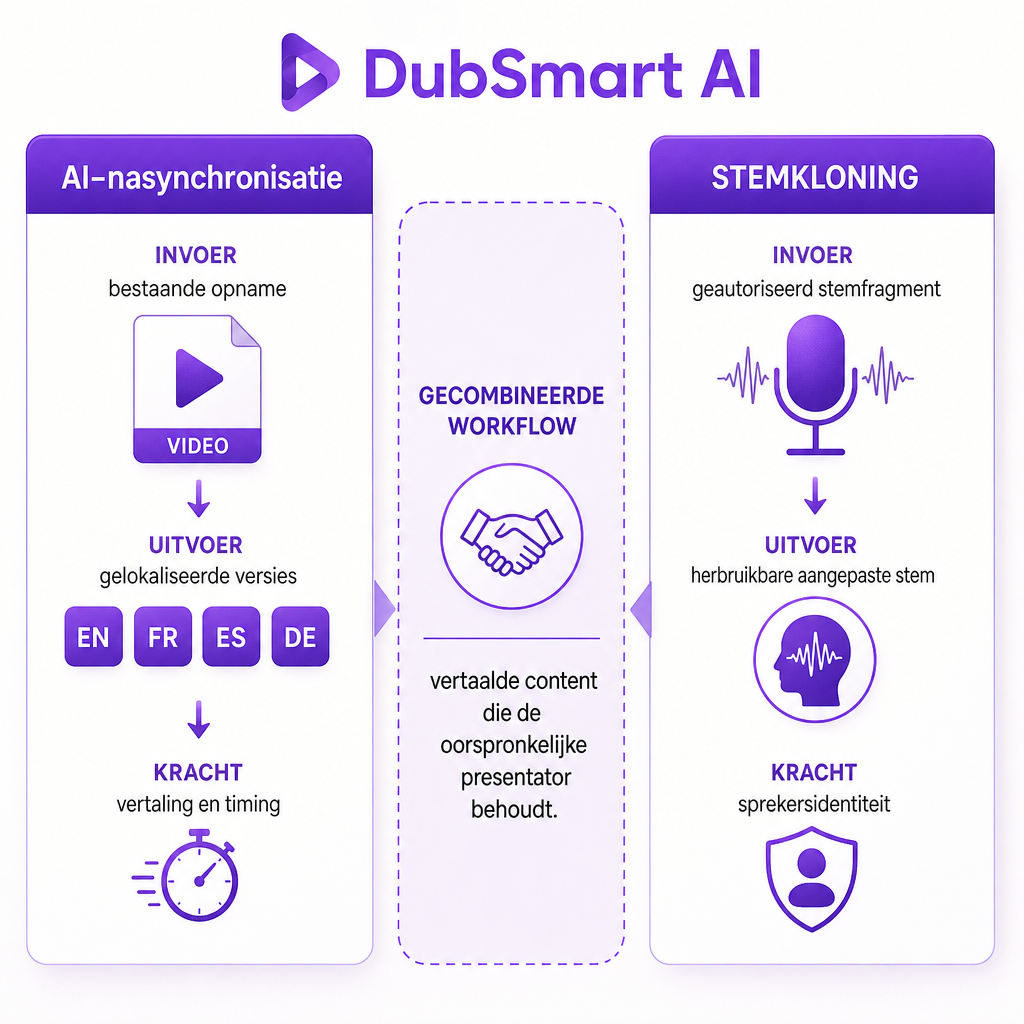
Haal de marketing weg en de twee technologieën beantwoorden verschillende vragen. AI-nasynchronisatie vraagt: hoe maak ik deze bestaande opname begrijpelijk in een andere taal? Stemklonen vraagt: hoe maak ik nieuwe spraak die klinkt als deze geautoriseerde spreker? De onderstaande tabel houdt die banen helder voordat we dieper ingaan.
| AI-nasynchronisatie | Stemklonen |
|---|---|
| Zet bestaande gesproken content om naar een andere taal of gelokaliseerde versie | Maakt nieuwe synthetische spraak die lijkt op een specifieke spreker |
| Begint met een video, audiobestand of bronopname | Begint met een geautoriseerd stemvoorbeeld |
| Combineert transcriptie, vertaling, stemgeneratie, timing en audiovervanging | Combineert stemanalyse, modelcreatie en tekst-naar-spraakgeneratie |
| Het beste voor meertalige versies van bestaande content | Het beste voor het behouden van sprekeridentiteit over nieuwe scripts en formaten |
| Kan stemmen toewijzen of klonen aan sprekers tijdens nasynchronisatie | Produceert een herbruikbare aangepaste stem voor TTS- of nasynchronisatieprojecten |
De overlap in die laatste rij is waar de verwarring begint. Een gekloonde stem kan binnen een nasynchronisatieworkflow leven, wat klonen een potentieel onderdeel van nasynchronisatie maakt in plaats van een concurrent ervan. Als je de volledige vergelijking wilt over kosten, snelheid en compliance, behandelt onze uiteenzetting van AI-nasynchronisatie versus menselijke nasynchronisatie de bemanningskant van die keuze.
Wat AI-nasynchronisatie eigenlijk doet
AI-nasynchronisatie is meer dan tekst-naar-spraak gericht op een transcript. Het moet een bestaande opname begrijpen en een vervangende uitvoering produceren die past bij de oorspronkelijke scène. Een typische pijplijn koppelt verschillende fasen: spraak-naar-tekst om vast te leggen wat elke spreker zegt, sprekerdetectie of -scheiding om stemmen onderscheidbaar te houden en dialoog van achtergrondaudio te isoleren, machinevertaling van het transcript, stemsynthese in de doeltaal, timingaanpassing zodat de nieuwe dialoog in de montage past, en een audiomix die spraak, muziek en omgevingsgeluid in balans brengt. Het klonen van de stem van de oorspronkelijke spreker is een optionele extra fase, geen vereiste.
Stel je een Amerikaanse maker voor met een Engelstalige producttutorial die Spaanse, Franse en Duitse versies wil. Het doel is geen nieuw script. Het is om de betekenis, structuur en timing van de originele video te behouden terwijl je deze openstelt voor nieuwe doelgroepen. Onze AI-nasynchronisatieworkflow accepteert een geüploade video of audiobestand, of een YouTube-link, en laat je vervolgens sprekers, tekst, timings en audio bewerken voordat je downloadt. Het ondersteunt nasynchronisatie vanuit meer dan 60 brontalen naar 33 doeltalen, en het kan tijdens het proces een gekloonde stem aan elke spreker toewijzen.
Als je hergebruikklus vooral gaat over vertaling en releasesnelheid, is dit de baan om mee te beginnen. We lopen door het volledige productiepad in onze gids over hoe je de stemtaal in een video verandert, en eigenaren van meertalige kanalen kunnen het grotere plaatje in kaart brengen in hoe je een meertalig YouTube-kanaal maakt.
Wat stemklonen eigenlijk doet
Stemklonen bouwt een synthetisch stemmodel op uit opnames van een echte spreker. Het model analyseert uitspraak, spreekritme, toonhoogte, intonatie, vocale textuur, pauzeerpatronen en expressieve stijl, en genereert vervolgens nieuwe spraak uit tekst die lijkt op de bronspreker zonder dat die elke regel met de hand hoeft op te nemen. Met onze Stemklonen kun je ten minste 20 seconden relatief schone audio uploaden om een kloon te maken, en klonen is beschikbaar in 33 talen.
Eén detail is belangrijker dan mensen verwachten: de emotionele stijl van je voorbeeld draagt over naar de output. Een monotone clip produceert doorgaans vlakke spraak, terwijl een expressieve clip het model meer stilistische informatie geeft om mee te werken. Kies het voorbeeld dat past bij de voordracht die je wilt, niet alleen het schoonste bestand dat je bezit.
Een gekloonde stem verdient zijn geld wanneer dezelfde spreker consistent moet verschijnen over veel assets, zoals kanaalintro's en updates, meertalige cursusvertelling, podcastcorrecties, productuitleg, audionieuwsbrieven, marketingvariaties en door API gegenereerde app-content. Omdat die stem ook binnen de nasynchronisatiepijplijn kan draaien, gedraagt klonen zich als een bouwsteen van nasynchronisatie in plaats van een concurrent ervan. Voor een bredere kaart van wat makers met een aangepaste stem doen, zie de beste toepassingen voor AI-stemklonen.
Hoe de twee samenwerken
Neem een maker met een gepubliceerde Engelstalige educatieve video van 20 minuten. Een nasynchronisatieworkflow transcribeert deze, identificeert de sprekers, vertaalt het transcript, genereert spraak in de doeltaal, en past vervolgens de timing aan en mixt de nieuwe dialoog met de originele audiobed. Als die maker ook wil dat de vertaalde versie hun vocale identiteit behoudt, voegt het systeem een stemkloon toe aan de spraakgeneratiefase. Dezelfde pijplijn, één extra ingrediënt.
De schoonste manier om het verschil in je hoofd te houden is via de vraag die elk beantwoordt:
- AI-nasynchronisatie beantwoordt: hoe maak ik deze bestaande content begrijpelijk in een andere taal?
- Stemklonen beantwoordt: hoe maak ik nieuwe spraak die klinkt als deze geautoriseerde spreker?
- De gecombineerde workflow beantwoordt: hoe lokaliseer ik deze content terwijl ik dezelfde herkenbare presentator behoud?
Onze gekloonde stemmen zijn gebouwd voor gebruik in zowel Tekst-naar-spraak als AI-nasynchronisatie, en dat is wat het gecombineerde pad praktisch maakt in plaats van een omweg. Dat hergebruik is het hele punt: één geautoriseerde stem, vele bestemmingen.
Welke past bij jouw hergebruikklus
De juiste keuze hangt af van wat er daadwerkelijk verandert: de taal, het script, de sprekeridentiteit, of alle drie. De onderstaande matrix koppelt veelvoorkomende hergebruikklussen aan de beter passende aanpak.
| Hergebruikvereiste | Betere match | Reden |
|---|---|---|
| Een bestaande video naar het Spaans vertalen | AI-nasynchronisatie | Bronopname en timing bestaan al |
| Dezelfde presentator in meerdere talen publiceren | Nasynchronisatie met stemklonen | Lokalisatie en sprekercontinuïteit zijn beide belangrijk |
| Tien nieuwe video's maken uit het script van één presentator | Stemklonen | Je hebt nieuwe spraak nodig, geen vertaalde opname |
| Eén zin in een gepubliceerde podcast vervangen | Stemklonen | Een aangepaste stem produceert een passende pickup zonder heropname |
| Een cursus met meerdere instructeurs lokaliseren | Nasynchronisatie, mogelijk meerdere klonen | De workflow beheert bron, sprekers, vertaling, timing |
| Merkgebonden gesproken reacties in een app genereren | Klonen-API of TTS-API | De kernbehoefte is programmatische spraakgeneratie |
| Een film, interview of panel nasynchroniseren | AI-nasynchronisatie | Meerdere sprekers, dialoogtiming en mixen zijn centraal |
| Neutrale vertelling in meerdere talen produceren | Nasynchronisatie of meertalige TTS | Een herkenbare originele stem is mogelijk onnodig |
Kies AI-nasynchronisatie wanneer de broncontent het bezit is: je hebt al een afgewerkte video of podcast, bestaande dialoog om te vertalen, meerdere sprekers, een muziekbed om te behouden, en een meertalig releaseschema. Het is vooral nuttig om de vraag in een nieuwe markt te testen zonder een volledig nieuwe video te produceren.
Kies stemklonen wanneer de identiteit van de spreker het bezit is: de stem van een oprichter over productvideo's, een instructeur die lessen bijwerkt, een podcaster die een feitelijke fout corrigeert, gelokaliseerde intro's en outro's, of gepersonaliseerde audio die op schaal wordt gegenereerd. Klonen vermindert de opnameoverhead, maar het is geen vervanging voor redactionele beoordeling. Een model kan vocale kenmerken reproduceren en toch een naam verkeerd uitspreken, context missen, of de verkeerde emotie overbrengen.
Kwaliteitscriteria die de commerciële output bepalen
Een serieuze vergelijking gaat verder dan of de output "realistisch klinkt." Voor hergebruikte content die moet presteren, scheiden zes criteria een bruikbaar bezit van een gênant exemplaar.
Betekenis en vertaalnauwkeurigheid. Een vloeiende stem kan een verkeerd vertaalde boodschap niet redden. Bestudeer productnamen, technische termen, getallen en maten, oproepen tot actie, juridische of veiligheidstaal, idiomen, humor en regionale verwijzingen. Een letterlijke vertaling kan grammaticaal correct en commercieel nutteloos zijn; marketing- en trainingscontent heeft meestal aanpassing nodig, geen woord-voor-woordconversie.
Sprekerconsistentie. Bepaal of dezelfde persoon identiek moet klinken over originele en gelokaliseerde versies, meerdere afleveringen, campagne-assets, korte clips, en toekomstige updates. Zo ja, dan voegt klonen waarde toe. Als je alleen heldere gelokaliseerde vertelling nodig hebt, is een standaard synthetische stem vaak voldoende.
Timing en bewerkbaarheid. Vertaalde spraak heeft zelden dezelfde lengte als de bronregel. Een werkbaar nasynchronisatieprogramma moet redacteuren in staat stellen segmenttiming, spreeksnelheid, tekst, geregenereerde secties en achtergrondniveaus aan te passen. Onze Nasynchronisatiestudio biedt precies die bedieningselementen: bewerk tekst en tijdstempels, verander de spreeksnelheid, regenereer individuele segmenten, en pas het achtergrondgeluid aan.
Emotionele voordracht. Stemidentiteit en emotionele uitvoering zijn aparte problemen. Een kloon kan lijken op de spreker maar toch urgentie, humor, empathie, autoriteit, spanning of enthousiasme niet overbrengen. Voed het met een voorbeeld dat de bedoelde voordracht demonstreert; een kalm voorbeeld past bij een cursus, een energiek bij een lanceringsvideo.
Lipsynchronisatie en visuele afstemming. Voor video geleid door een presentator of personage moet vertaalde audio passen bij de zichtbare uitvoering: mondbeweging, pauzes, shotwisselingen, reactietiming, ondertitelafstemming en sprekerovergangen. Voice-over buiten beeld tolereert losse synchronisatie; close-updialoog niet.
Productiesnelheid en schaal. AI loont naarmate assets en talen vermenigvuldigen, vergelijk dus de totale werklast in plaats van alleen de generatietijd. Hoeveel talen en sprekers zijn erbij betrokken? Hoe vaak wordt content bijgewerkt? Kan het team één zin regenereren zonder het project opnieuw op te bouwen? Is een API vereist, en kan dezelfde stem worden hergebruikt onder de juiste rechten? We publiceren afzonderlijke AI-nasynchronisatie, Stemklonen-API, Tekst-naar-spraak-API en AI-nasynchronisatie-API producten; controleer die pagina's rechtstreeks voor actuele authenticatie, invoer- en uitvoerformaten, snelheidslimieten en plandetails voordat je bouwt.
Rechten, openbaarmaking en governance die je niet kunt overslaan
Snelheid maakt het gemakkelijk om het papierwerk over te slaan, en dat is waar projecten in de problemen komen. Kloon een stem alleen wanneer je de autorisatie van de spreker en de rechten voor het beoogde gebruik, talen, kanalen, duur en gebied in handen hebt. Toestemming om iemand op te nemen is geen toestemming om een herbruikbare synthetische kopie van hun stem te bouwen. Houd voor zakelijk gebruik documentatie bij die de identiteit van de stemeigenaar dekt, het toegestane gebruik, distributiekanalen, geografische gebieden, contractduur, vergoedingsvoorwaarden, of de stem in reclame mag draaien, of het model via een API mag worden aangeroepen, en hoe verwijdering of intrekking werkt. Toestemming en verantwoord gebruik zijn onderdeel van hoe wij klonen benaderen, maar het veiligstellen van de rechten voor je materiaal en voorbeelden blijft bij jou.
Behandel geüploade opnames als gevoelig. Stemvoorbeelden kunnen biometrische en persoonlijke informatie bevatten, dus beperk de toegang tot bronbestanden, upload nooit materiaal dat je niet mag gebruiken, en bevestig hoe een aanbieder stemdata opslaat, verwerkt en verwijdert. NIST markeert synthetische stemmen als een risicogebied omdat gekloonde audio imitatie en fraude mogelijk kan maken, en de richtlijnen benadrukken het bepalen van toestemming en het aanpakken van de risico's verbonden aan synthetische content.
Platformregels voegen nog een laag toe. YouTube vereist momenteel dat makers realistische AI-gegenereerde of betekenisvol gewijzigde content in relevante gevallen bekendmaken; de eigen voorbeelden geven aan dat het klonen van je eigen stem voor voice-overs of nasynchronisaties geen openbaarmaking vereist onder dat voorbeeld, terwijl realistische synthetische content die kijkers kan misleiden dat mogelijk wel doet. Beleid verandert, dus verifieer de huidige regels van het bestemmingsplatform voordat je publiceert, en onthoud dat openbaarmaking nooit auteursrechttoestemming, persoonlijkheidsrechten, merkgoedkeuring of reclamecompliance vervangt. Je kunt het eigen beleid van YouTube lezen in het helpartikel over openbaarmaking.
Houd tot slot een mens in de lus. Beoordeel elk gelokaliseerd bezit op vertaalfouten, verkeerde namen, verkeerd uitgesproken merken, onjuiste getallen, cultureel ongepaste bewoordingen, onnatuurlijke pauzes, inconsistente terminologie, stemartefacten, audiovervorming en verkeerd toegewezen sprekers. Haal voor gereguleerde, veiligheidskritieke, politieke, medische of juridische content gekwalificeerde beoordelaars en vakexperts erbij.
Hoe DubSmart beide kanten aanpakt
We combineren AI-nasynchronisatie, Stemklonen, Tekst-naar-spraak, Spraak-naar-tekst, Spraakscheider en andere mediatools op één platform, wat een maker of klein team bespaart om bestanden heen en weer te schuiven tussen afzonderlijke transcriptie-, vertaal-, stem- en bewerkingsapps. Onze openbare productpagina's vermelden dat AI-nasynchronisatie nasynchronisatie ondersteunt vanuit 60+ talen naar 33 talen, dat het gekloonde stemmen voor sprekers kan gebruiken en projectbewerkingscontroles biedt, dat Stemklonen werkt vanaf ten minste 20 seconden schone audio, dat gekloonde stemmen draaien in zowel Tekst-naar-spraak als AI-nasynchronisatie, en dat Stemklonen- en AI-nasynchronisatie-API's beschikbaar zijn als afzonderlijke ontwikkelaarsproducten.
Voor een klein project is de browserworkflow meestal voldoende. Bureaus, platforms en ontwikkelteams moeten de API-documentatie, gebruikslimieten, dataverwerking, commerciële rechten, foutafhandeling en huidige krediet- of planvoorwaarden evalueren voordat ze zich committeren aan een geautomatiseerde integratie. Weet je niet zeker in welke baan je volgende hergebruikklus thuishoort? Vertel ons het bronformaat, de doeltalen, het aantal sprekers en de updatefrequentie, en we kunnen je naar de juiste opzet wijzen.
Veelgestelde vragen
Is AI-nasynchronisatie hetzelfde als stemklonen?
Nee. AI-nasynchronisatie lokaliseert bestaande gesproken content door transcriptie, vertaling, spraakgeneratie, timing en mixen te combineren. Stemklonen creëert een herbruikbare synthetische stem uit een geautoriseerd sprekervoorbeeld. Klonen kan worden gebruikt binnen een nasynchronisatieworkflow, maar ze zijn niet onderling verwisselbaar.
Is stemklonen beter dan AI-nasynchronisatie voor YouTube?
Dat hangt af van het doel. Gebruik AI-nasynchronisatie om bestaande video's naar nieuwe talen te vertalen. Gebruik stemklonen wanneer je de stem van dezelfde presentator nodig hebt voor nieuwe scripts, correcties of gelokaliseerde intro's. Voor meertalige kanaalgroei is het combineren van beide vaak het sterkst.
Kan ik AI-nasynchronisatie gebruiken zonder mijn stem te klonen?
Ja. Een nasynchronisatieworkflow kan een standaard synthetische stem of een andere goedgekeurde stem gebruiken in plaats van de oorspronkelijke spreker te klonen. Klonen is optioneel wanneer sprekeridentiteit niet essentieel is voor het stuk.
Hoeveel audio is nodig om een stem te klonen met DubSmart?
Onze Stemklonen-pagina vermeldt dat je een audiobestand van ten minste 20 seconden kunt uploaden. We raden audio zonder achtergrondgeluid aan, en de spreekstijl in je voorbeeld beïnvloedt de emotionele kwaliteit van de gegenereerde stem.
Moet door AI gegenereerde nasynchronisatie op YouTube worden bekendgemaakt?
Soms. De huidige richtlijnen van YouTube vereisen openbaarmaking voor realistische AI-gegenereerde of betekenisvol gewijzigde content in relevante gevallen. Het noemt het klonen van je eigen stem voor voice-overs of nasynchronisaties als een voorbeeld dat geen openbaarmaking vereist, terwijl andere realistische synthetische content dat mogelijk wel doet. Controleer het huidige beleid voordat je publiceert.