ナレーション向けのtts対ボイスクローニングのどちらを選ぶかは、結局のところ一つの率直な問いに行き着きます。コンテンツに信頼できる音声が必要なのか、それともその中に特定の話者のアイデンティティが必要なのか、ということです。標準的な音声合成(テキスト読み上げ)なら、既製のライブラリから素早く柔軟にナレーションを作れます。ボイスクローニングは、認識可能な声を再現し、同じ人物が新しい台本・動画・言語をまたいで話しているように見せます。多くのクリエイターやチームにとって賢い選択は両方を使うことです。スピード重視でストックボイスを使ってプロトタイプを作り、ブランドアイデンティティや話者の一貫性が重要になってきたら、承認済みの作業を同意の取れたクローンに切り替えるのです。このガイドの残りの部分では、それぞれがどこで優位に立つのかを正確に示します。
目次
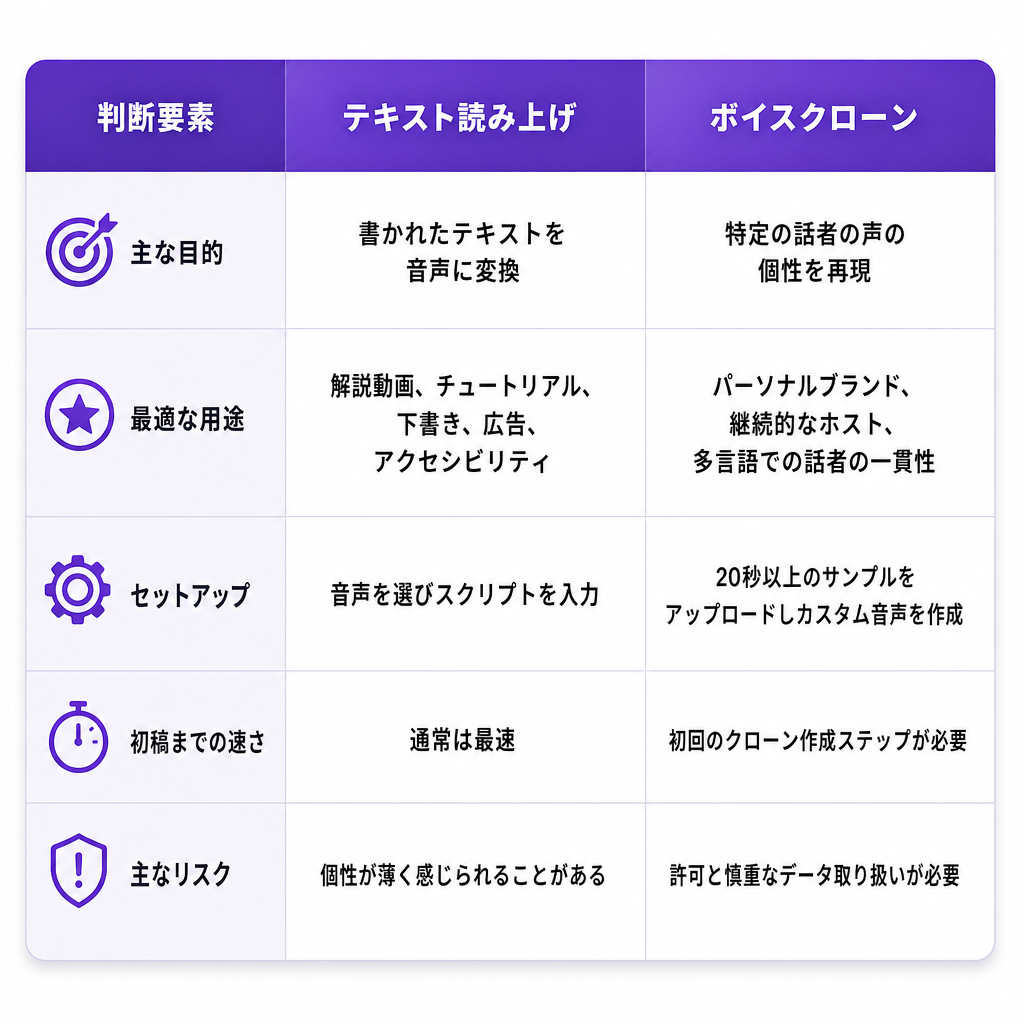
この選択で堂々巡りを止める最も手っ取り早い方法は、人々が絶えず混同してしまう二つのものを切り離すことです。すなわち、音声のスタイルと、その背後にあるアイデンティティです。標準的なTTS音声は、すぐに使える制作可能なスタイルを提供してくれます。温かみのある、権威ある、エネルギッシュな、会話調の、あるいはニュートラルな読み上げが可能で、台本に合うものを選びます。クローンされた音声は、特定の人物との連続性を提供します。リスナーはそれをクリエイター、講師、創業者、あるいはナレーターとして認識し、そのアイデンティティが製品の一部であるからこそあなたはそれを選ぶのです。
この違いは、クリップの聞こえ方以上のものを変えます。運用負荷が変わるのです。スタイルは自由に差し替えられるものですが、アイデンティティは保護し、文書化し、新しいファイルすべてにわたって一貫させるべきものです。この分かれ目を念頭に置けば、以下の判断のほとんどは自ずと答えが出ます。
音声合成ナレーションの実際の仕組み
音声合成(テキスト読み上げ)は、書かれたテキストを合成音声に変換します。システムは台本を読み取り、発音や文構造を解釈し、カタログから選んだ音声で音声トラックをレンダリングします。特定の人物が言葉を読み上げているのを録音しているわけではなく、既製音声のスタイルで新たな音声を生成しているのです。
実際には、いくつかのレバーを制御します。言語、アクセント、音声プロファイル、トーン、話す速度、そして読み上げスタイルです。この柔軟性こそが肝心な点です。価格、商品名、統計、レッスンが変わったときは、テキストを編集して影響を受けた部分だけを再生成すればよく、スタジオを再予約する必要はありません。当社の音声合成ツールは、このループを最初から最後まで実行します。テキストを入力し、300以上のAI音声から話者を選び、生成し、プロジェクトを編集し、ダウンロードできます。発話速度の制御や、強調のためのテキストキューも備えています。
音声そのものが認識可能である必要がない場合は、標準TTSを選びましょう。初稿やテスト版、頻繁に公開して迅速な更新を要するチャンネル、複数人が台本を書いたり管理したりするワークフロー、キャラクターやセクションごとに異なる音声を必要とするコンテンツに適しています。また、複数の言語、アクセント、読み上げスタイルを試したい場合や、教育的・情報提供的・アクセシビリティ重視の素材を制作している場合にも自然な選択となります。例えば、週次で商品チュートリアルを配信する小規模事業者は、一つの一貫したストックボイスを維持しながら、録音の調整を一切行うことなく機能やコールトゥアクションを更新できます。
ボイスクローニングナレーションの実際の仕組み
ボイスクローニングは、特定の人物に似た合成音声を構築します。システムはサンプルの発音、ピッチ、リズム、トーン、話し方を分析し、それらの特徴を用いてテキストから新しい音声を生成します。これは完成したナレーションをタイムライン上で切り貼りするものではありません。話者が録音したことのない台本を読み上げられる、再利用可能な音声モデルを生み出すのです。
サンプルが大半の作業を担います。当社のボイスクローニングページでは、20秒以上の音声ファイルからカスタム音声を作成でき、背景ノイズのないクリーンな録音ほど良い結果が得られると記載しています。そのアップロードにおける話し方がそのまま引き継がれます。単調な参照音声は平板なナレーションになりがちで、実際に求めるエネルギーと感情を含んだサンプルは、モデルにより明確な目標を与えます。作成後は、その音声を音声合成プロジェクトとAIダビングプロジェクトの両方で再利用できます。
話者のアイデンティティがブランドや製品の一部である場合は、クローニングを選びましょう。すべてのセリフを録音せずにより頻繁に公開したいYouTubeホスト、エピソードを録り直す代わりに小さな部分を修正するポッドキャスター、一貫した創業者や講師の音声を求める企業、複数言語にわたって同じ講師を保たなければならないコースに適しています。オンライン講師は、クリーンなサンプルを一度録音すれば、同意の取れたクローンを使ってレッスンを刷新したり、古くなった事実を修正したり、海外の学習者向けのバージョンを作成したりできます。各種フォーマットをまたいでアイデンティティを再利用することについてさらに詳しく知りたい方は、コンテンツ再利用のためのAIダビング対ボイスクローニングに関するガイドをご覧ください。
核心の分かれ目:音声のスタイルか、音声のアイデンティティか
他に何も覚えていなくても、このフレームだけは覚えておいてください。どんな機能一覧表よりも素早く、ほとんどのエッジケースを解決してくれるからです。標準TTSは選択の問題です。棚からスタイルを選んでいるのであり、来週には無償で気が変わってもかまいません。クローニングは連続性へのコミットメントです。一つのアイデンティティに固定され、時間をかけてそれを維持し、管理し、守ることに同意しているのです。
だからこそ、台本が同じに見えても、創業者主導のブランドと顔の見えない解説チャンネルとでは振る舞いが異なります。解説チャンネルに必要なのは有能な音声だけなので、TTSで事足ります。創業者ブランドは認知によって成り立っているため、クローンされた音声は、追加のセットアップと書類手続きに見合うだけの資産となります。行き詰まったら、来月音声を差し替えたらオーディエンスとコンテンツとの関係が損なわれるかどうかを自問してください。もし損なわれるなら、それはクローニングの領域です。この二つのルートを真っ向から比較した詳細な説明については、クローン音声とストックTTS音声の選び方に関する解説で、判断基準をより深く掘り下げています。
制作目標別に、どちらを使うべきか
正しい答えは、実際に何を作っているかによって変わります。以下では、最も一般的なナレーションの仕事において、この選択がどう落ち着くかを示します。
YouTubeクリエイター。 TTSは、ホストのアイデンティティが関わらない、顔の見えないチャンネル、解説動画、リスト動画、ニュース風のコンテンツに適しています。クローニングは、視聴者が特定のプレゼンターと結びつけるチャンネルに適しており、認識可能な音声を保ちつつ、修正・イントロ・短編バリエーションのための録り直しを省けます。多言語展開については、言語ごとに別々のナレーションアイデンティティを考案するのではなく、カスタム音声をAIダビングと組み合わせましょう。
中小企業とマーケティングチーム。 キャンペーンのバリエーション、商品解説、ソーシャル広告、頻繁なコピー変更にはTTSに頼りましょう。創業者、アンバサダー、スポークスパーソンが信頼の中心にある場合はクローニングを取り入れます。クローンは承認済みの台本バリエーションを読み上げることはできますが、主張・発音・ブランドトーンのレビューに取って代わることは決してありません。
eラーニングと企業研修。 TTSは、コースが多数のモジュール、科目、頻繁な更新にまたがる場合に真価を発揮します。ストックボイスなら、異なるコースや役割に異なる音声を割り当てるのが簡単だからです。クローニングは、学習者が全体を通して一人の講師を期待するプログラムや、馴染みのある音声アイデンティティを失わずに既存コースを刷新する場合に適しています。いずれの場合も、名前、専門用語、略語、数字の人間によるレビューは不可欠です。
ポッドキャストと独立系映画。 最終的な話者が確定する前のスクラッチトラック、ナレーションテスト、仮作業にはTTSを使いましょう。一貫したピックアップ、代替バージョン、承認されたホストや出演者のローカライズにはクローニングを使い、制作開始前に権利と使用目的を文書化しておきます。
開発者とエージェンシー。 TTSは通常、よりシンプルなAPIの入口です。テキストを送り、音声を選び、音声を受け取ります。クローニングは、クライアント、ブランド、キャラクターごとに永続的なカスタム音声を必要とするアプリに適しています。当社のボイスクローニングAPIは、MP3、WAV、AAC、M4A、FLAC形式のアップロードを受け付け、TTSやAIダビングで参照できるカスタム音声を返し、カスタム音声の一覧取得や削除の操作を公開しています。
どちらがより自然に聞こえるか
どちらの選択肢も自動的に自然なものになるわけではありません。高品質なストックボイスは、ノイズの多い音声から作られたクローンを簡単に上回ることがありますし、質の悪いサンプルはそれ自身の欠陥を再現します。背景のハム音、ムラのある読み上げ、台本に合わない感情的なトーンといったものです。自然さは、前提として仮定するラベルではなく、テストして確かめる出力結果なのです。
第一印象ではなく、具体的な基準に照らして結果を判断しましょう。
- 発音: 名前、頭字語、数字、専門用語を正しく読み上げているか?
- プロソディ(韻律): リズムは台本に合っているか?
- 一貫性: クリップや言語をまたいで音声は安定しているか?
- 感情: 読み上げはナレーションの目的に合っているか?
- 明瞭さ: スマートフォン、ノートパソコン、ヘッドフォンで聞き取れるか?
- 編集可能性: トラック全体が崩れることなく、一文だけを再生成できるか?
- ローカライズ: 別の市場向けに適応させてもなお適合するか?
TTSの場合は、同じ段落に対して複数のストックボイスを走らせて比較しましょう。クローニングの場合は、短い挨拶だけでなく、完成プロジェクトの難しい単語、感情の幅、ペース配分を含む代表的な台本をテストしましょう。挨拶はほとんど常に問題なく聞こえます。本当の勝負は、クローンがその弱点を露呈する部分にあるのです。
省略できない権利、同意、開示
クローニングには、通常のTTSにはない責任が伴います。識別可能な人物の声を再現できるからです。意図された使用について許可と権利を保有している場合にのみ音声をクローンし、その許可を具体的なものにしてください。適切な同意は、元の録音を誰が所有しているか、合成音声がどこに登場してよいか、商用利用が許可されているか、どの言語と地域が含まれるか、広告やダビングが許可されているか、許可がどのくらいの期間有効か、モデルと元ファイルがどのように保存されるか、ライセンスが終了したときに何が起こるか、といった点を網羅します。
当社は同意と倫理的利用をボイスクローニングのアプローチの一部として扱っており、当社のAPIはカスタム音声とそれに関連する音声データの削除をサポートしています。サンプルをアップロードする前に、あなたのアカウントとプロジェクトに適用される現行の規約を確認してください。法的な背景も依然として変化し続けています。米国著作権局は、リアルな音声レプリカをデジタルレプリカとして特定し、無許可のものに対する連邦レベルの追加保護を勧告しています。これはその著作権とデジタルレプリカに関する報告書に記載されています。
開示の層もあります。AI生成コンテンツの開示に関するYouTubeのガイダンスは、動画のナレーションのために人物の声を合成的に生成することを、クリエイターが開示しなければならないリアルな改変・合成コンテンツとして挙げています。したがって、視聴者を誤解させる可能性がある場合は、クローンされた音声を未改変の録音であるかのように提示してはいけません。FTCは別途、ボイスクローニングがなりすまし詐欺をより信じられやすくすると警告しており、これこそが、許可と透明性のある利用が任意の心遣いではない理由です。
今日から使える判断ルール
オーディエンスが良い音声を必要としているなら、TTSを選びましょう。オーディエンスがこの特定の話者を必要としているなら、ボイスクローニングを選びましょう。
スピード、多様性、実験、頻繁な台本変更が主たる要素である場合は、TTSから始めましょう。テストが速く、修正が容易で、サンプル不要で幅広い音声を利用できます。認知、連続性、話者のアイデンティティが要点である場合は、クローニングに移行しましょう。クリエイター主導のチャンネル、講師主導のコース、創業者主導のブランド、ポッドキャストホスト、多言語スポークスパーソンなどです。許可された音声サンプルのみを使用し、生成された音声を入念にレビューし、該当する場合は開示ルールに従ってください。
多くのチームが、意図的に両方に行き着きます。ストックボイスでプロトタイプを作り、制作がそのセットアップに見合うようになったら、承認済みの反復コンテンツをカスタム音声に移行するのです。このハイブリッドは、YouTubeチャンネル、オンラインコース、ブランドキャンペーン、多言語ライブラリにとって特に効果的です。当社は両方を一つのワークフローに統合しているので、300以上の音声による柔軟なナレーションから始め、音声サンプルからカスタム音声を作成し、プロジェクトの成熟に合わせてTTSやAIダビングで再利用できます。
よくある質問
ボイスクローニングはTTSと同じですか?
いいえ。TTSは、選択した合成音声を使って書かれたテキストを音声に変換します。ボイスクローニングは、特定の話者に似せることを意図したカスタム音声モデルを作成し、それを使ってTTSナレーションを生成できます。
TTSはボイスクローニングより優れていますか?
一概には言えません。TTSは通常、スピード、音声の多様性、テスト、頻繁な更新で優位に立ちます。クローニングは、特定の話者のアイデンティティを新しいコンテンツ全体にわたって一貫させなければならない場合に優位に立ちます。
DubSmartで音声をクローンするにはどれくらいの音声が必要ですか?
当社のボイスクローニングページでは、アップロードには少なくとも20秒の音声が含まれるべきだとしています。より良い結果を得るには、背景ノイズのないクリーンな録音が推奨されます。
クローンした音声を多言語ナレーションに使えますか?
はい。クローンされた音声は、当社がサポートする言語にわたってAIダビングで再利用できます。公開前に、各ターゲット市場で発音と文化的な適合性をテストしてください。
YouTubeクリエイターはAIナレーションを開示すべきですか?
YouTubeの現行の開示コントロールを確認してください。YouTubeは、ナレーションのために人物の声を合成的に生成することを、開示が必要となる可能性のあるリアルな改変・合成コンテンツとして特定しています。