comfyui text to speech(ComfyUI テキスト読み上げ)にたどり着き、スクリプトを音声に変換する単一のボタンを期待しているなら、まず知っておくべきことは、ComfyUI はそもそも音声エンジンではないということです。これは、テキスト、音声、モデル、言語、そして音声出力を一つの再利用可能なグラフに結線するノードベースのワークスペースです。音声そのものは、あなたが接続する TTS ノードから生まれます。ホスト型プロバイダー、公式パートナー連携、あるいは自分でインストールするローカルモデルなどです。したがって、実際に重要な問いは、ComfyUI があなたのスクリプトを読み上げられるかどうか(それは可能です)ではなく、繰り返し行う必要のある作業にとって、ビジュアルグラフが適切な場所なのかどうかということです。
この区別が、このページにおける他のすべての判断を形作ります。ComfyUI は、ナレーションが画像、動画、音声の生成の隣に並ぶ、実験的でマルチモーダルなパイプラインで真価を発揮します。専用の音声ツールは、きれいなボイスオーバーを何度も何度も作る必要があるだけの、再現性のある制作で真価を発揮します。以下では、ワークフローの仕組み、どのような選択肢のタイプが存在するか、それらをどう評価するか、そしてグラフがメンテナンスの手間に見合わなくなるのはどこかを解説します。
目次
ComfyUI テキスト読み上げとは実際のところ何か
ComfyUI テキスト読み上げとは、ComfyUI グラフを使って書かれたテキストを AUDIO 出力に変換する手法です。公式ドキュメントでは、ComfyUI を画像、動画、音声、3D 生成にわたるワークフローを構築するためのオープンソースのノードベースアプリケーションとして説明しており、その音声ノードは外部の音声サービスやモデルを同じビジュアルキャンバスに接続します。
動作する音声グラフは小さなものです。テキストまたはプロンプトの入力、TTS ノード、音声または参照音声の入力、オプションの言語および配信設定、そして音声のプレビューまたは保存ノードが必要です。TTS ノードはあなたのスクリプトを音声モデルに通し、生成された音声を返し、それを後続のノードが利用できます。
実務上の帰結として、ComfyUI はワークフローのレイヤーであって、モデルそのものではありません。実際の音声は、ホスト型プロバイダー、パートナーの音声モデル、サードパーティのカスタムノード、あるいはローカルにインストールされたシステムによって生成される場合があります。この区分を理解することが、期待を正確に保つ鍵です。あなたはパイプラインを組み立てているのであり、その中のエンジンは依然として自分で選ぶのです。
4段階のワークフローの仕組み
ノード名を取り除けば、どの ComfyUI 音声グラフも順番に同じ4つのことを行っています。
まず、スクリプトがテキストとして届きます。TTS ノードはプレーンテキストを直接受け取る場合もあれば、より長いスクリプトを読み込み、翻訳し、分割する別のノードからテキストが流れ込む場合もあります。長いナレーションを論理的なセクションに分割すると、ボイスオーバー全体を作り直すことなく1つの段落を再生成でき、プロバイダーの入力上限内に収めるのにも役立ちます。
次に、ワークフローが音声とモデルを選択します。プロバイダーによって、それはプリセットの話者、クローンされた音声、音声 ID、または参照録音の場合があります。モデルの選択は、速度、品質、表現の幅、コストも左右します。たとえば ComfyUI の HeyGen ノードは、heygen-voice-1 と、より高速で低コストの heygen-voice-1-turbo の両方を公開しており、ElevenLabs ノードは安定性、速度、スタイルといったコントロールを提供します。
3番目に、音声モデルが音声を合成します。現代のニューラルシステムは、あらかじめ録音された単語をつなぎ合わせるのではなく、発音、リズム、ポーズ、ピッチの動きを推定し、先へと送れる波形を返します。ファイルに保存したり、音楽とミックスしたり、動画グラフに落とし込んだり、アバターと組み合わせたりできます。
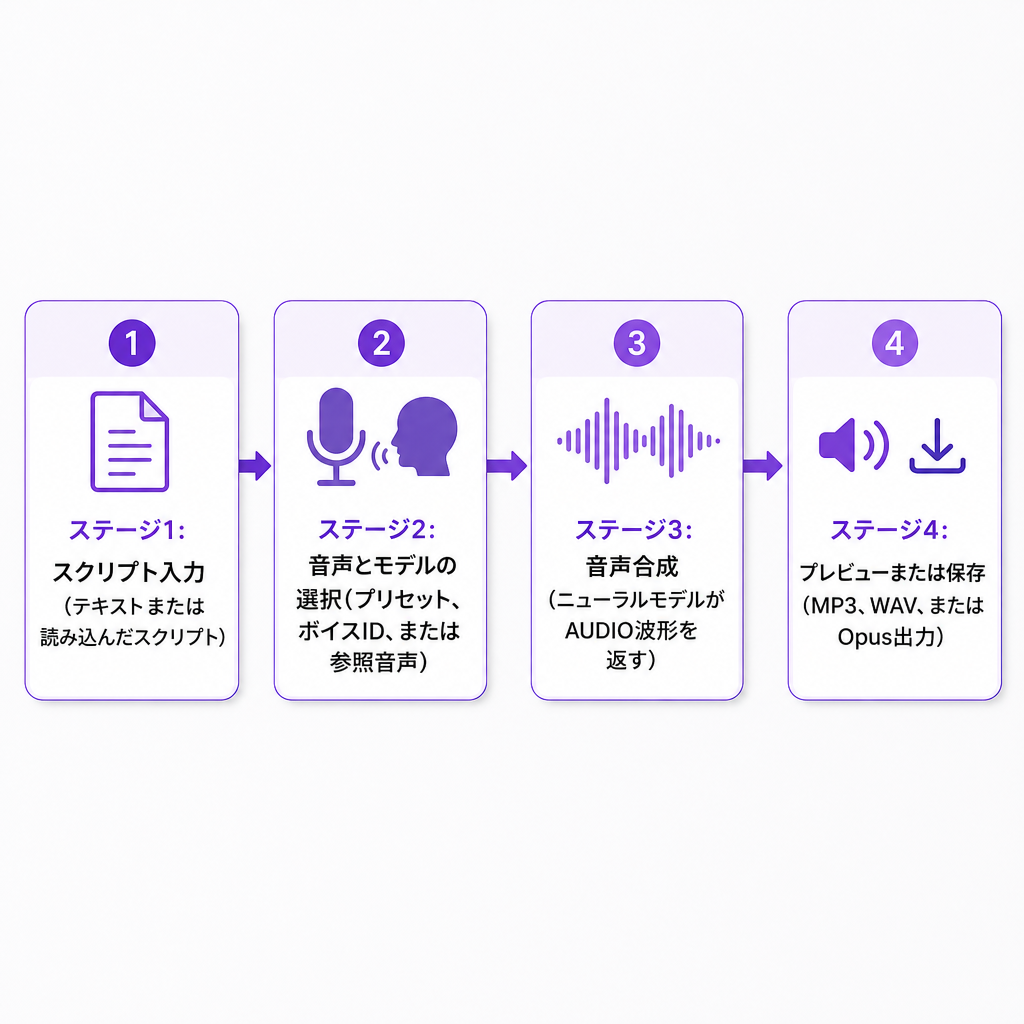
4番目に、音声がプレビューまたは保存されます。TTS ノードは通常 AUDIO オブジェクトを出力し、それがプレビューまたは保存ノードに接続されます。ファイル形式はノードとプロバイダーによって設定され、たとえば ElevenLabs ノードのドキュメントには、MP3 や Opus のバリアントを含む選択可能な形式が列挙されています。グラフはビジュアルなので、ループの再実行は簡単です。スクリプト、音声、言語、またはモデルを変更して、再びキューに入れるだけです。
ComfyUI で TTS を実行する3つの方法
単一の ComfyUI 音声方式というものはなく、その違いはセットアップ、コントロール、プライバシー、そしてどれだけのメンテナンスを自分で引き受ける覚悟があるかに帰着します。
ホスト型プロバイダーノードは、あなたのテキストと音声設定を外部サービスに送信し、完成した音声を返します。モデルがプロバイダーのインフラ上で動作するため、これは通常、高品質な音声への最速の経路です。HeyGen Voice 1.0 ノードがこのパターンを示しています。有効なクローン音声 ID が必要で、テキストと ID を HeyGen に送信し、音声を返します。トレードオフも予測可能です。アカウントまたは API 接続が必要な場合があり、使用がプロバイダーのクレジットを消費する可能性があり、あなたのテキストと音声はサードパーティによって処理され、プロバイダーの制限や価格設定が変更される可能性があります。
公式パートナーの音声ノードは、同じ発想を音声空間のより広い範囲に拡張します。ComfyUI の音声ドキュメントは、テキストからの音声生成を、テキストからの音声や参照音声からの音声を含む、ボイス・音声のユースケースと区別しています。これらの連携は、グラフがすでに他のホスト型メディアモデルに依存している場合に輝きます。別々のアプリケーション間でファイルをやり取りする手間を減らせるからです。
コミュニティおよびローカル TTS ノードは、ComfyUI を Edge TTS、Kokoro、Index-TTS、その他ローカルで実行できるモデルなどのシステムに接続します。ローカルワークフローは、データとモデルの選択に対するより多くのコントロールを与えてくれますが、見返りにより多くを求めます。インストール、互換性のあるハードウェア、モデルのダウンロード、そしてトラブルシューティングです。ローカルノードがホスト型より自動的に優れているわけではありません。その真の利点は、あなたのマシンがモデルを効率的に実行できるか、音声品質が持ちこたえるか、あなたの言語がサポートされているか、ライセンスが商用利用を許可しているか、そしてワークフローを長期にわたって維持できるかにかかっています。
ボイスクローンと期待できるコントロール
ボイスクローンは、ストックの話者の代わりに参照アイデンティティをグラフに追加します。構造は通常、接続された2つの部分から成ります。音声アイデンティティを作成または返すクローンノードと、そのアイデンティティを使って新しいテキストを読み上げる TTS ノードです。HeyGen のドキュメントはこれを直接説明しており、Instant Clone ノードが voice_id を生成し、それが Voice 1.0 Text to Speech ノードに供給されます。このクローンワークフローは少なくとも10秒の明瞭な音声を必要とし、TTS ノードは1リクエストあたり最大5,000文字を受け付けます。
クローンは許可を得た場合にのみ行ってください。録音に手が届くからというだけで実在する人物の声を複製してはいけません。許可を得て、その証拠を保管し、文脈が聴衆を誤解させる可能性のある場所では合成音声やクローン音声であることを開示してください。
音声そのものを超えて、あなたが出会うコントロールはノードやモデルによって異なりますが、よく見かける一連のものがほとんどで繰り返し現れます。
- 音声: 話者のアイデンティティまたはプリセット
- 言語: スクリプトを解釈するために使用される言語
- 速度: ナレーションが配信される速さ
- ピッチ: 知覚される声の高低
- スタイルと表現力: 配信の性格と、感情がどれだけ強く適用されるか
- 安定性: 音声がその特性をどれだけ一貫して保つか
- 出力形式: MP3、WAV、Opus など
- 参照音声: クローンまたは音声変換に使用される録音
一部のモデルはインラインキューでさらに先へ進みます。Fish Audio ノードのドキュメントは、サポートされているモデルで感情キューとマルチスピーカーの会話タグをサポートしています。すべてに共通する注意点が一つあります。これらのコントロールはプロバイダー間で互換性がなく、あるノードでスタイルと呼ばれる設定が、別のノードのスタイルとはまったく異なる振る舞いをすることがあります。
ComfyUI 対 専用 TTS プラットフォーム
ComfyUI は、音声がより大きなメディアパイプラインの一部である場合にその地位を勝ち取ります。専用プラットフォームは、唯一の実際の仕事がグラフを組み立てることなくスクリプトを洗練されたナレーションに変えることである場合に勝ちがちです。
| 判断要素 | ComfyUI | 専用 TTS プラットフォーム |
|---|---|---|
| ワークフローの柔軟性 | 高い。TTS を他のメディアノードに接続できる | 通常は音声制作に特化 |
| セットアップ | ノード、プロバイダーのリンク、またはモデルのインストールが必要な場合がある | 最初の生成はしばしばより速い |
| 音声オプション | インストールまたは接続されたノードに依存 | 通常は整理された1つの音声ライブラリ |
| 自動化 | 再利用可能なビジュアルグラフに強い | 多くは API またはバッチツール経由 |
| ローカル処理 | ローカルノードとモデルで可能 | 通常はクラウドベース |
| 最適なユースケース | 実験的またはマルチモーダルなパイプライン | 再現性のあるナレーションと制作 |
音声を画像、動画、または音声処理と組み合わせるビジュアルパイプラインを構築するクリエイターにとって、グラフは元が取れます。YouTube ナレーション、eラーニングのボイスオーバー、ポッドキャスト、または予測可能なインターフェースを必要とするローカライゼーションチームにとっては、専門サービスが通常、技術的なオーバーヘッドを取り除きます。私たちの Text to Speech ワークフローは、300以上の AI 音声、33言語にわたるボイスクローン、調整可能な読み上げ速度、感情的な会話キュー、そしてダウンロード可能なプロジェクトを備えた、スクリプトから音声への直接生成を中心に構築されています。生成がアプリケーションや自動化されたコンテンツパイプラインの中に収まる必要がある場合、私たちの Text to Speech API が統合の面を担い、私たちの AI Dubbing API が同じ発想を、翻訳され音声がマッチした動画へと拡張します。
セットアップの選び方とトラブルシューティング
ノードやモデルに本格的に取り組む前に、短いデモを信じるのではなく、いくつかの意図的なチェックを行いましょう。
音声品質は、簡単なサンプルではなく難しいサンプルで判断しましょう。名前、数字、頭字語、長い文、疑問文、ブランド用語、そして対象言語とアクセントでの少なくとも1つの感情的なセリフを含む一節を生成してください。一言で魅了する音声でも、製品名を台無しにしたり、段落全体でリズムを失ったりすることがあります。
言語とアクセントのサポートは、総合的にではなく言語ごとに確認しましょう。言語を自動的に検出するシステムもあれば、設定が必要なものもあり、HeyGen ノードのドキュメントは、自動検出が信頼できない可能性のある近縁の言語については言語を手動で設定することを推奨しています。流暢な音声でも不正確な翻訳を救うことはできないことを覚えておいてください。音声品質と翻訳品質は別個の問題です。
発音のコントロールは、実際にエンジンを躓かせる単語について測定しましょう。製品名、固有名詞、略語、日付、通貨、専門用語です。ノードが発音辞書や SSML スタイルのコントロールを提供していない場合は、テキストを音声的に書き換えたり、数字をつづりで書き出したりする計画を立てましょう。シリーズやブランドチャンネルの場合は、同じ音声を複数の生成、トーン、再生成されたセクションにわたって実行して一貫性もテストしてください。異なるシーンのための別々の ComfyUI 実行はブレが生じることがあるためです。
レイテンシー、コスト、プライバシー、権利を一緒に検討しましょう。ホスト型ノードは起動が速いですが、ネットワーク速度、プロバイダーの可用性、アカウントの制限、使用ごとの価格設定に依存します。一方、ローカルモデルはリクエストごとの課金を避けられますが、ハードウェアと保守を要求します。広告された料金ではなく、総制作コストを比較してください。プライバシーについては、入力がどのように保存されるか、コンテンツがモデルを学習させるか、音声データを削除できるか、商用利用が許可されているか、出力を誰が所有するか、そしてクローン音声にどのような同意が必要かを確認してください。
グラフが誤動作する場合、失敗は短いリストに集約されます。エラーを返すクローン音声ノードは、多くの場合 voice_id が空か無効です。HeyGen ノードはまさにその理由で停止します。長すぎるスクリプトは制限に達し、ドキュメント化された HeyGen Voice 1.0 ノードは最大5,000文字を受け付けますが、非常に長い音声、特に長い中国語や日本語のテキストでは失敗する可能性があると警告しているので、ナレーションを論理的なセクションに分割してください。誤った発音は通常、数字を単語で書き換えたり、句読点を追加したり、頭字語をつづりで書き出したりすることで対応できます。表現過多の出力は、表現力、スタイル、またはピッチの変動を下げることを求めます。そして、音声が下流に接続されない場合は、タイプを確認してください。AUDIO 出力は、変換ステップなしに画像、動画、またはテキストを期待するノードに供給することはできないからです。最後に、名前の付いたノードと記録された設定を備えたクリーンなグラフを保存してください。使用したプロバイダー、音声 ID、言語、出力形式は、未来のあなたが必要とする詳細だからです。
よくある質問
ComfyUI はテキスト読み上げツールですか?
ComfyUI は、単一の TTS エンジンというよりノードベースのワークフローアプリケーションです。組み込みノード、パートナー連携、そしてコミュニティまたはローカルの TTS ノードを通じて音声を生成できます。
ComfyUI は音声をクローンできますか?
はい、選択した連携またはカスタムノードがクローンをサポートしていれば可能です。正確な録音要件、音声 ID のプロセス、制限、商用条件はプロバイダーによって異なります。
ComfyUI テキスト読み上げはオフラインで動作しますか?
互換性のあるローカル TTS モデルとローカルノードを使用すれば動作します。ホスト型プロバイダーノードはインターネット接続を必要とし、テキストや音声データをプロバイダーに送信する場合があります。
最良の ComfyUI TTS ノードは何ですか?
万能の最良ノードというものはありません。言語サポート、音声品質、クローンの必要性、プライバシー、コスト、レイテンシー、そしてワークフローの他の部分との互換性に基づいて選択してください。
ComfyUI TTS を YouTube 動画に使用できますか?
はい。ナレーションを生成し、発音と権利を確認し、音声をエクスポートして、動画と同期させてください。クローン音声または合成音声を使用する場合は、該当する同意、開示、プラットフォームの要件に従ってください。