Un'API di voice AI è la connessione programmabile che consente alla tua applicazione di creare, comprendere, trasformare o localizzare audio parlato utilizzando modelli di IA che non devi costruire tu stesso. Invii testo, audio o video a un endpoint e ottieni in cambio qualcosa di utile: una narrazione sintetizzata, una trascrizione, una voce personalizzata o un video interamente doppiato. La vera domanda quando inizi non è se hai bisogno di una "voce IA"—è quale capacità vocale il tuo prodotto richiede realmente, perché la generazione del parlato, il riconoscimento vocale, la clonazione della voce e il doppiaggio sono prodotti distinti che per caso condividono il nome di una categoria.
Questa guida illustra cosa significa il termine, i principali tipi di API e come si differenziano, come una richiesta si muove attraverso la pipeline, i criteri decisionali che distinguono una scelta azzeccata da un costoso errore, e i rischi da gestire prima di andare in produzione. È il punto centrale della nostra serie dedicata a sviluppatori e API, quindi troverai collegamenti alle guide di integrazione più approfondite dove utili.
Indice
Cosa significa realmente "API di voice AI"
La frase racchiude tre idee. La voice AI è l'intelligenza artificiale che lavora con il parlato umano o genera parlato sintetico. L'API è un'interfaccia di programmazione delle applicazioni—un modo definito con cui due sistemi software si scambiano richieste e risposte. La combinazione significa che l'elaborazione pesante dei modelli avviene dal lato del provider, mentre la tua applicazione gestisce l'esperienza utente, le tue regole di business e il contenuto finale.
Una richiesta può essere semplice come un breve payload JSON con il testo che vuoi far pronunciare, un identificatore di voce e un codice di lingua. La risposta tipicamente restituisce un identificatore di progetto, uno stato di elaborazione e un URL all'audio generato una volta pronto. Per la localizzazione video, la richiesta fa invece riferimento a un file caricato e a un elenco di lingue di destinazione.
Questa struttura è ciò che distingue un'API da un generatore vocale basato su browser. Un'app web è costruita perché una persona la utilizzi manualmente, un lavoro alla volta. Un'API è costruita perché il software la richiami ripetutamente, automaticamente e su larga scala. Se stai producendo una voce fuori campo occasionale, lo strumento web è spesso più veloce. Se stai localizzando ogni video che pubblichi, l'API è il punto.
I cinque principali tipi di API di voice AI
"API di voice AI" è una categoria, non un'unica tecnologia. I cinque tipi comuni accettano input diversi e restituiscono output diversi, e scegliere quello sbagliato fa perdere tempo di integrazione. La tabella sottostante li mappa così puoi abbinare il tuo materiale di partenza al risultato che desideri.
| Tipo di API | Input | Output | Uso tipico |
|---|---|---|---|
| Text-to-speech | Testo scritto | Audio vocale sintetico | Narrazione, accessibilità, prompt di app, formazione |
| Speech-to-text | Parlato o video | Trascrizione scritta | Sottotitoli, ricerca, note di riunioni, riutilizzo |
| Clonazione della voce | Campione vocale autorizzato | Voce sintetica personalizzata | Voci di marca, presentatori ricorrenti, narrazione multilingue |
| Doppiaggio IA | Video o audio | Media tradotto e con voce | Localizzazione YouTube, corsi, film, podcast |
| Speech-to-speech | Parlato registrato | Parlato trasformato o tradotto | Conversione vocale, produzione multilingue |
La regola di selezione è semplice. Se hai già uno script, il text to speech è di solito il percorso più semplice. Se hai una registrazione che necessita di una trascrizione, ti serve lo speech to text. Se vuoi la stessa identità del presentatore in diverse lingue, la clonazione della voce o il doppiaggio sono più appropriati. Per una spiegazione focalizzata solo sul lato TTS, la nostra guida complementare su cos'è un'API di text to speech approfondisce la pipeline di sintesi.
Una distinzione utile: la clonazione della voce non è un modulatore di voce. Un modulatore di voce trasforma sul posto un'esecuzione esistente, mentre la clonazione crea un modello vocale riutilizzabile che genera nuovo parlato da testo o da un altro input controllato.
Come una richiesta si muove attraverso la pipeline
Le implementazioni variano, ma la maggior parte delle API vocali segue le stesse quattro fasi. Comprendere la forma del flusso fa risparmiare ore di congetture quando qualcosa restituisce uno stato inatteso.
Primo, la tua applicazione si autentica. Invia una chiave API o un token bearer nell'intestazione della richiesta. L'API TTS di DubSmart, ad esempio, utilizza un endpoint REST con autenticazione tramite token bearer e richieste JSON verso l'URL di base https://dubsmart.ai/api/v1. Una regola che conta più di quanto sembri: non inserire mai una chiave privata in JavaScript lato browser o in un'app mobile distribuita. Memorizzala su un server sicuro e fai in modo che il tuo client chiami quel server.
Secondo, la tua applicazione invia contenuto e impostazioni. Una richiesta solitamente contiene un mix di testo o un riferimento a un file, lingua di origine e di destinazione, un ID voce, velocità o tono, informazioni sul parlante, preferenze di output e metadati del progetto. Per il TTS semplice, il contenuto è testo. Per il doppiaggio, l'API richiede spesso prima un caricamento video, poi una richiesta separata per creare il progetto.
Terzo, il servizio elabora il contenuto. A seconda del compito, ciò può significare normalizzare e interpretare il testo, prevedere pronuncia e prosodia, tradurre il contenuto parlato, separare i parlanti o isolare il parlato dall'audio di sottofondo, generare audio con una voce standard o personalizzata e sincronizzare il risultato con una timeline video. I lavori più lunghi vengono eseguiti in modo asincrono: invece di restituire un file finito, l'API restituisce un ID di progetto.
Quarto, la tua applicazione recupera il risultato—un URL audio o video, URL di singoli segmenti, una trascrizione, testo tradotto, dati di temporizzazione e campi di stato o errore. L'API TTS di DubSmart documenta stati di progetto come pending, processing, completed e failed, e i progetti completati possono restituire URL MP3 a livello di progetto o di segmento.
Sincrono contro asincrono: la distinzione che modella la tua implementazione
Il modo in cui un'API restituisce i risultati determina come progetti la tua architettura intorno ad essa, quindi decidi questo prima di scrivere il codice di integrazione.
Un'API sincrona mantiene la richiesta aperta fino al termine dell'elaborazione, poi restituisce il risultato. Questo funziona bene per testi brevi, prompt vocali rapidi, piccoli frammenti audio e funzionalità interattive a bassa latenza. Il suo punto debole è che i lavori lunghi possono superare i timeout delle richieste.
Un'API asincrona restituisce immediatamente un ID di progetto o di lavoro. La tua applicazione poi interroga un endpoint di stato o riceve un webhook quando il lavoro termina. Questo modello è adatto a narrazioni lunghe, doppiaggio video, lingue di destinazione multiple, generazione in batch e file di grandi dimensioni. I flussi di lavoro documentati di TTS e doppiaggio di DubSmart utilizzano stati di progetto e recupero dei risultati, che è un modello asincrono costruito per i lavori multimediali.
Quando valuti un'opzione, verifica se supporta i webhook. Fare polling ogni pochi secondi è banale da implementare, ma i webhook riducono le richieste inutili e scalano meglio quando esegui molti lavori contemporaneamente.
Cosa valutare prima di impegnarti
L'API giusta dipende dal lavoro, ma una manciata di criteri si applica a quasi ogni progetto. Passali in rassegna deliberatamente invece di fidarti di una breve demo.
Adeguatezza delle funzionalità. Conferma che l'API supporti il compito esatto—text to speech, speech to text, clonazione della voce, doppiaggio, parlanti multipli, output solo audio o video, in tempo reale o in batch. Non dare per scontato che tutto ciò che è pubblicizzato come "voice AI" includa tutte queste cose.
Copertura linguistica. Verifica le lingue di origine e di destinazione. "Supporta 30 lingue" potrebbe significare 30 voci TTS, 30 destinazioni di traduzione, o un mix di lingue e dialetti. Per un canale multilingue, considera anche la qualità degli accenti, la pronuncia di nomi e luoghi, il vocabolario regionale, la disponibilità di voci per lingua e se una voce clonata viene mantenuta tra le lingue.
Supporto di output e media. Verifica i formati audio, i contenitori video, la frequenza di campionamento e il bitrate, i download a livello di segmento, il video renderizzato completo, la disponibilità di trascrizioni o sottotitoli e la dimensione massima dei file. Questi aspetti modellano il tuo flusso di lavoro di editing e i costi di archiviazione.
Qualità e controllabilità. Ascolta pause naturali, pronuncia corretta, volume stabile, identità del parlante coerente, enfasi appropriata e temporizzazione accurata. Una voce può sembrare perfetta in un campione di dieci secondi e inciampare su termini tecnici, lunghi paragrafi, numeri o nomi insoliti. Testa contenuti rappresentativi, non il clip selezionato ad arte dal fornitore.
Latenza e throughput. Misura i tempi rispetto al tuo carico di lavoro reale. Una breve voce fuori campo e centinaia di video localizzati sono problemi diversi. Chiedi se l'elaborazione è in tempo reale o asincrona, quali sono i limiti di velocità, se i lavori vengono eseguiti in parallelo, se esiste un'elaborazione prioritaria e come vengono ritentati i fallimenti. DubSmart afferma che un tipico video di cinque minuti richiede circa un minuto per essere elaborato, notando che i tempi dipendono dalla lunghezza e dalla dimensione del file.
Modello di prezzo. Le API vocali possono fatturare in base a caratteri, parole, durata audio o video, crediti, richieste, archiviazione o lavori simultanei. Per il doppiaggio, il numero di lingue di destinazione moltiplica il costo effettivo. Calcola un flusso di lavoro completo—ritentativi, segmenti rigenerati, revisione della traduzione, archiviazione—non solo la prima chiamata. La nostra analisi dei prezzi delle API di voice AI illustra nel dettaglio i calcoli dei crediti.
Rischi da gestire fin da subito
La voice AI introduce modalità di fallimento che non esistono negli strumenti multimediali ordinari. Affrontarle durante la progettazione è molto più economico che dopo un errore pubblico.
Uso non autorizzato della voce. Clonare la voce di una persona senza permesso crea esposizione legale, etica e reputazionale. Usa un processo di consenso scritto che indichi chi possiede la registrazione, cosa può essere generato, dove la voce può essere usata, se l'uso commerciale è consentito, come viene eliminata la voce e cosa succede quando l'accordo termina.
Traduzione o pronuncia errata. Il parlato generato può gestire male nomi, acronimi, indirizzi e termini di settore. Mantieni la revisione umana nel processo per i contenuti rivolti al pubblico: una lettura dello script tradotto, un ascolto da parte di un madrelingua, controlli puntuali della pronuncia, una verifica della temporizzazione e del movimento labiale, e una revisione finale del media esportato.
Impersonificazione e frode. Le voci sintetiche possono essere utilizzate in modo improprio per truffe o false sponsorizzazioni. Evita di generare qualsiasi cosa possa far credere a un ascoltatore ragionevole che una persona reale abbia detto qualcosa che non ha detto. Per le comunicazioni sensibili, aggiungi divulgazione, controlli di approvazione e registri di audit.
Privacy della voce e dei dati. I campioni possono contenere dati personali. Prima di caricare, definisci consenso, regole di conservazione, restrizioni di accesso, procedure di eliminazione, termini di trattamento dati del fornitore e qualsiasi policy di uso secondario. DubSmart afferma che i file di clonazione caricati sono criptati e che gli utenti possono eliminare le voci personalizzate e i dati audio associati, anche se i team dovrebbero comunque confermare i termini e i controlli attuali per il loro piano specifico.
Modifiche al fornitore e al modello. Gli ID voce, il supporto linguistico, i formati di output e i limiti di velocità possono cambiare. Tratta l'API come una dipendenza esterna: fissa la configurazione dove possibile, memorizza gli script di origine, salva l'audio approvato, monitora i tassi di errore, mantieni un flusso di lavoro di riserva e riesegui i test dopo gli aggiornamenti importanti del fornitore. Per i team che vogliono meno componenti in movimento, la nostra panoramica degli strumenti video IA tutto-in-uno spiega i compromessi del consolidare queste capacità.
Quando un'API batte un flusso di lavoro manuale
Un'API di voice AI ripaga il suo costo di integrazione quando hai bisogno di una produzione ripetibile e programmatica. È adatta quando un creator pubblica versioni localizzate di ogni video, una piccola impresa genera narrazioni di prodotto in diverse lingue, un'azienda di e-learning aggiorna centinaia di lezioni, un podcast distribuisce edizioni tradotte, un prodotto software aggiunge accessibilità vocale, o un'agenzia collega la generazione vocale al proprio sistema di gestione dei contenuti.
Un flusso di lavoro di studio manuale può comunque prevalere in casi specifici: quando un progetto dipende da un'esecuzione umana altamente sfumata, quando l'approvazione legale richiede un attore professionista, quando il contenuto comporta affermazioni sensibili, quando una registrazione una tantum è più veloce della costruzione di un'integrazione, o quando il risultato richiede una forte direzione artistica. Il punto non è sostituire ogni voce umana. È automatizzare le parti in cui coerenza, velocità, scala o output multilingue contano di più.
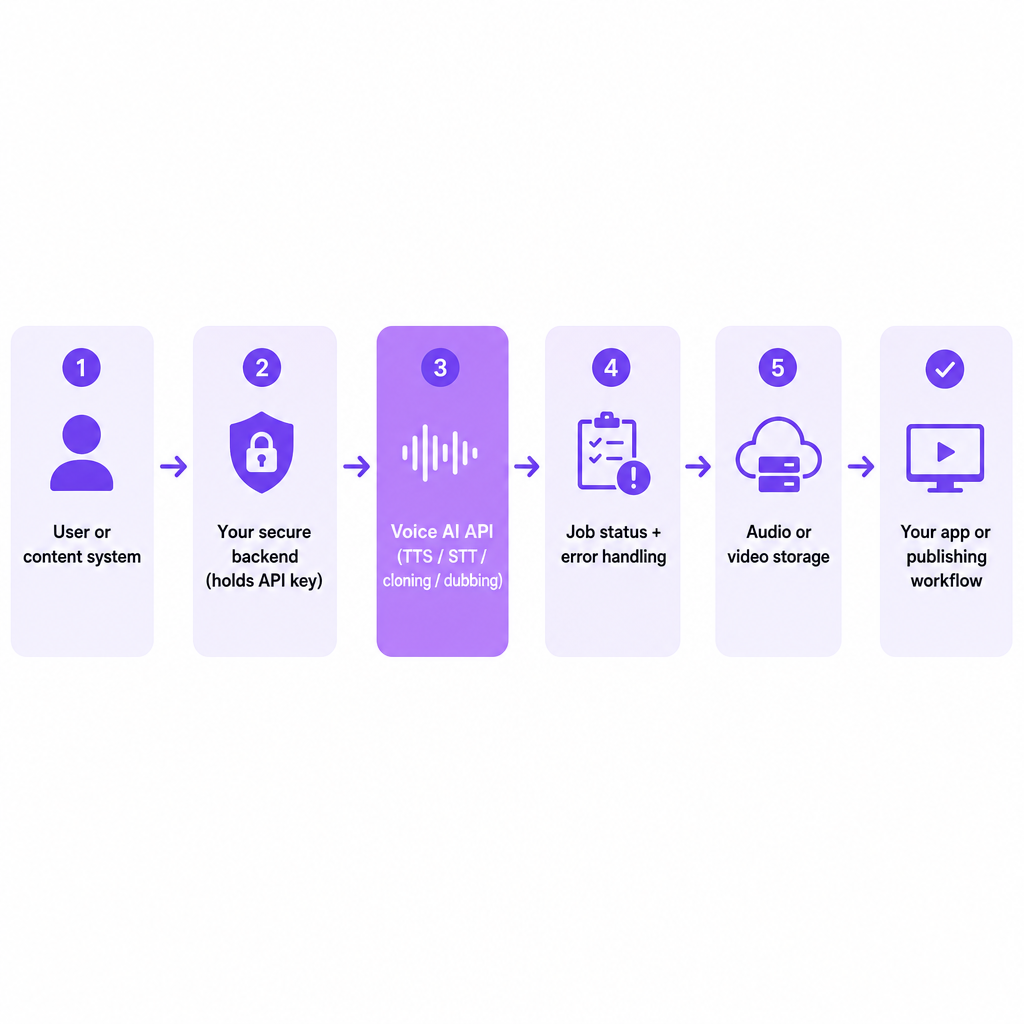
Per una piccola implementazione, mantieni l'architettura semplice. Un backend sicuro si colloca tra il tuo utente o sistema di contenuti e l'API vocale. Quel backend mantiene private le credenziali, valida gli input, crea progetti, memorizza gli ID dei lavori, interroga lo stato o riceve webhook, ritenta i fallimenti temporanei, salva gli URL dei risultati e i metadati, applica limiti di utilizzo e registra il consenso per qualsiasi voce clonata. Una versione rivolta ai creator potrebbe accettare un video inglese finito, inviarlo a un endpoint di doppiaggio per le lingue scelte, attendere il completamento, indirizzare i risultati a una cartella di revisione e pubblicare solo dopo l'approvazione.
Dove si colloca DubSmart
Integriamo diverse capacità API legate alla voce in un'unica piattaforma multimediale IA, il che conta soprattutto quando vuoi collegare generazione e localizzazione a un flusso di lavoro esistente piuttosto che eseguire ogni lavoro manualmente.
La nostra API Text to Speech fornisce generazione programmatica del parlato con voci neurali, clonazione della voce, supporto multilingue, tracciamento dello stato del progetto e risultati MP3—la sua richiesta di esempio utilizza segmenti di testo con un ID voce, lingua, velocità e tono. La nostra API di Clonazione della Voce segue uno schema in tre passaggi: richiedere un URL di caricamento prefirmato, caricare un campione audio, poi creare una voce personalizzata dalla chiave del file caricato; accetta MP3, WAV, AAC, M4A e FLAC, e consigliamo almeno 20 secondi di audio pulito per risultati migliori. La nostra API di Doppiaggio IA gestisce la localizzazione video con creazione di progetti multilingue, impostazioni dei parlanti, segmenti tradotti e output doppiato scaricabile, accettando input come MP4, MOV, AVI, MKV e WebM fino a 5GB.
Se stai valutando da quale endpoint iniziare, abbinalo al tuo contenuto: la narrazione con script indica il TTS, una voce ricorrente autorizzata indica la clonazione, e il video multilingue indica il doppiaggio.
Domande frequenti
Cos'è un'API di voice AI in parole semplici?
È una connessione che consente al software di generare, riconoscere, clonare, tradurre o trasformare il parlato senza costruire il proprio sistema di voce IA. La tua app invia una richiesta e riceve audio, testo o video elaborati.
Un'API di voice AI è la stessa cosa del text to speech?
No. Il text to speech è un tipo di API di voice AI. La categoria include anche il riconoscimento vocale, la clonazione della voce, il doppiaggio e le funzioni speech-to-speech.
Ho bisogno di esperienza di programmazione per usarne una?
Di solito un po', perché le API coinvolgono autenticazione, richieste HTTP, JSON, caricamenti di file e gestione degli stati. Per lavori manuali occasionali, un'app web no-code è spesso più facile.
Un'API di voice AI può tradurre un video di YouTube?
Un'API di doppiaggio può tradurre e generare nuovo audio per un video quando supporta le lingue di origine e di destinazione richieste, il formato del file e il flusso di lavoro di output. Rivedi il risultato prima di pubblicare.
Posso clonare la voce di qualsiasi persona?
Tecnicamente possibile non è lo stesso di legalmente o eticamente consentito. Clona una voce solo con l'autorizzazione appropriata, e segui le regole del fornitore, i tuoi contratti e i requisiti applicabili in materia di privacy e diritto all'immagine.