Il modo più veloce per trascrivere un video in testo è lasciare che uno strumento di speech-to-text basato su IA faccia il primo passaggio: carica il file video o incolla un link di YouTube, lascia che il sistema converta l'audio parlato in una trascrizione modificabile, poi rivedi le parti più probabilmente errate. Quest'ultimo passaggio conta più di quanto la maggior parte delle persone si aspetti, perché "veloce" dovrebbe significare una trascrizione rapida al primo passaggio più un breve controllo qualità, non una perfezione istantanea. La digitazione manuale, al contrario, significa fermarsi, riavvolgere e ridigitare ogni riga, ed è qui che spariscono le ore.
Se vuoi la versione pratica di come trascrivere un video in testo, il nostro flusso di lavoro Speech to Text accetta caricamenti video e link di YouTube, ti permette di modificare il progetto risultante, supporta più di 60 lingue e gestisce file fino a 5 GB senza alcun limite dichiarato sulla durata del video. Il resto di questa guida spiega il meccanismo che c'è dietro, come scegliere l'output giusto e come mantenere alta l'accuratezza quando l'audio fa resistenza.
Indice dei contenuti
Cosa significa realmente trascrivere un video in testo
La trascrizione video converte l'audio parlato all'interno di un video in parole scritte. Quell'unico output può servire a molti scopi: una trascrizione video completa, sottotitoli o didascalie, un copione per il montaggio, una bozza di blog o newsletter, registrazioni ricercabili di riunioni e lezioni, o testo sorgente che poi traduci per nuovi pubblici.
Aiuta distinguere tre termini che spesso vengono confusi. La trascrizione mantiene la lingua parlata originale in forma di testo. La traduzione converte quel contenuto in un'altra lingua. Il doppiaggio sostituisce o aggiunge audio parlato in una lingua diversa. Prima trascrivi, poi decidi se il passo successivo è la traduzione o il doppiaggio. Se vuoi la definizione più approfondita della tecnologia di riconoscimento alla base di tutto questo, la nostra guida su come funziona lo speech-to-text copre le basi.
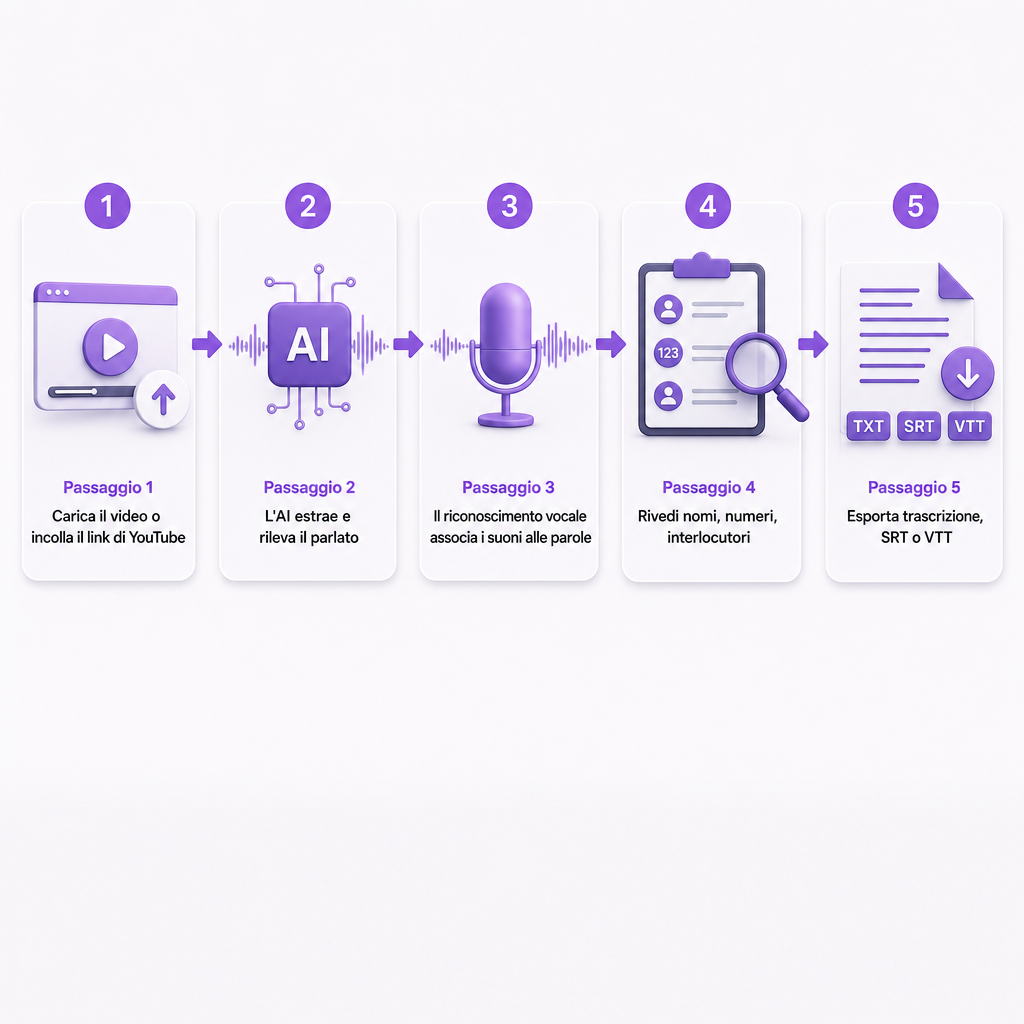
Come funziona la trascrizione video con IA sotto il cofano
Conoscere il flusso di lavoro aiuta a prevedere da dove provengono gli errori. La maggior parte dei sistemi di trascrizione automatica attraversa le stesse fasi. Prima, il sistema legge la traccia audio all'interno del video. Poi rileva quali sezioni contengono effettivamente parlato. Un modello di riconoscimento mappa quindi i pattern sonori in parole, e un passaggio di elaborazione del linguaggio usa il contesto circostante per migliorare quelle previsioni. Le parole riconosciute vengono assemblate in frasi o segmenti temporizzati, e infine correggi ed esporti il risultato.
Il modello di riconoscimento è solo una parte dell'equazione della qualità. La qualità del microfono, le voci sovrapposte, gli accenti, la musica di sottofondo, l'eco della stanza, il vocabolario tecnico e le interruzioni influenzano tutti l'output. Il nostro sistema Speech to Text è costruito per gestire ambienti rumorosi, parlanti multipli e diverse lingue e dialetti, con l'onesta avvertenza che l'accuratezza varia con la qualità dell'audio e la diversità degli accenti. Quell'avvertenza è il motivo per cui esiste il passaggio di revisione, piuttosto che un difetto da nascondere.
Trascrizione, didascalie o sottotitoli: scegli l'output giusto
Il miglior formato di esportazione dipende interamente da a cosa serve il testo, e scegliere male fa perdere tempo in seguito.
Una trascrizione semplice è testo leggibile senza timing richiesto. Ricorri a essa quando hai bisogno di note di ricerca, registrazioni di riunioni, un copione video, una bozza di blog o newsletter, o contenuto da riutilizzare. I timestamp sono opzionali qui, anche se aiutano i montatori a spostarsi.
Le didascalie sincronizzano il testo con il video e possono riportare informazioni rilevanti non parlate come musica, applausi o una porta che si chiude. Sono importanti per l'accessibilità e per chiunque guardi senza audio. I sottotitoli tipicamente mostrano il dialogo parlato per gli spettatori che non comprendono la lingua. Quando hai bisogno di sottotitoli in un'altra lingua, trascrivi prima l'originale, poi traduci e temporizza il testo tradotto.
Per i formati temporizzati, WebVTT è uno standard web per tracce di testo allineate nel tempo; la specifica W3C WebVTT lo descrive come un formato per didascalie, sottotitoli, capitoli, descrizioni e altri metadati sincronizzati con audio o video. Per i caricamenti su YouTube, SubRip .srt e .vtt sono entrambi tra i formati di sottotitoli supportati, e YouTube nota che i file .srt di base devono usare la codifica UTF-8 semplice.
Pulisci l'audio prima di trascrivere video rumorosi
Il rumore di sottofondo è una delle cause più comuni di errori di trascrizione. Rumori della strada, aria condizionata, feedback del microfono, musica concorrente ed eco della stanza offuscano tutti i confini tra le parole, e il modello di riconoscimento ha meno segnale su cui lavorare.
La soluzione è isolare il parlato prima della trascrizione. Il nostro Speech Separator rimuove il rumore di sottofondo e separa le parole parlate dall'audio circostante, supportando i principali formati come MP3, WAV e AAC oltre ai file video. Si guadagna il suo posto nel flusso di lavoro per interviste registrate all'aperto, podcast catturati in stanze non trattate, video con musica di sottofondo pesante, dibattiti con livelli di microfono irregolari, e filmati d'archivio che portano ronzii o rumore ambientale.
Un'avvertenza per il lavoro di accessibilità: non rimuovere ogni suono per riflesso. Se un rumore porta un significato, come una sirena, un allarme o un annuncio dall'altoparlante, potrebbe comunque dover essere rappresentato nelle didascalie anche quando è escluso dalla traccia di parlato pulita che invii per la trascrizione.
Come migliorare l'accuratezza della trascrizione
Tratta la trascrizione con IA come una solida prima bozza, poi applica controlli mirati invece di rileggere tutto alla cieca.
Inizia con il file sorgente più chiaro. Carica la registrazione originale piuttosto che un download compresso dai social media, poiché un segnale di parlato più pulito dà al modello più su cui lavorare. Riduci l'audio concorrente abbassando o rimuovendo la musica di sottofondo, e usa la traccia di parlato più pulita disponibile se il video ne ha di separate. Seleziona la lingua o il dialetto che corrisponde alla registrazione quando l'opzione esiste, il che aiuta il sistema a interpretare pronuncia, ortografia e struttura della frase.
Poi punta ai punti di fallimento prevedibili. Cerca nella trascrizione i nomi propri come nomi, marchi, luoghi, termini di prodotto e gergo invece di fidarti di una lettura generale. Rivedi i cambi di parlante, e aggiungi manualmente le etichette dei parlanti quando la trascrizione sarà usata per scopi legali, educativi, di ricerca o editoriali. Verifica gli elementi brevi e critici per il significato: date, prezzi, percentuali, misure, URL, acronimi, negazioni come "non" e parole dal suono simile, perché una singola svista può invertire una frase.
Il metodo più affidabile è riprodurre il video seguendo la trascrizione. Per una registrazione lunga, salta prima alle sezioni con nomi, numeri, audio poco chiaro o voci sovrapposte. Questo rispecchia un'avvertenza che vale la pena interiorizzare: le didascalie automatiche possono rappresentare male il parlato a causa di errori di pronuncia, accenti, dialetti e rumore di sottofondo.
Adattare il flusso di lavoro al tipo di contenuto
Formati diversi mettono sotto stress parti diverse del processo, quindi adatta dove spendi il tempo di revisione.
Per i video di YouTube, una trascrizione alimenta didascalie, descrizioni, capitoli, selezione di clip e riutilizzo focalizzato sulla ricerca; usa il caricamento originale o una sorgente di alta qualità quando possiedi il video. Interviste e podcast di solito necessitano di etichette dei parlanti e una gestione del rumore più forte, quindi pulisci prima l'audio di ambienti affollati e mantieni coerente l'identità dei parlanti. I video di e-learning e formazione dovrebbero dare priorità all'accuratezza in istruzioni, terminologia, numeri e riferimenti a schermo, con didascalie sincronizzate abbastanza strettamente da far sì che gli studenti seguano la spiegazione e lo schermo insieme.
Le riunioni aziendali si trasformano in registrazioni ricercabili e voci di azione, ma le conversazioni sensibili richiedono un'attenzione extra: verifica nomi, decisioni, date e responsabilità assegnate prima di condividere. I video brevi per i social spesso convertono la trascrizione in didascalie a schermo, una descrizione del post o versioni tradotte, quindi mantieni brevi le interruzioni di riga per il mobile e assicurati che le didascalie non coprano elementi visivi importanti.
Come scegliere uno strumento video-to-text
Valuta l'intero flusso di lavoro, non solo un numero di accuratezza pubblicizzato. La tabella sottostante mappa i criteri che cambiano davvero i tuoi tempi di consegna e la qualità dell'output.
| Criterio di decisione | Cosa verificare |
|---|---|
| Supporto input | Accetta il tuo video, audio o un URL di YouTube? |
| Limiti dei file | Qual è la dimensione massima del file e la durata del video? |
| Copertura linguistica | Supporta la tua lingua, dialetto e accenti? |
| Gestione dei parlanti | Puoi identificare o separare più parlanti? |
| Formati di output | Puoi esportare testo semplice, SRT o VTT? |
| Integrazione | C'è un'API per elaborare i video su larga scala? |
La nostra pagina pubblica Speech to Text conferma l'input video e tramite link di YouTube, progetti modificabili, download, supporto per più di 60 lingue e un limite di dimensione di 5 GB. Su quella pagina non dichiariamo se ogni output include timestamp, per quanto tempo vengono conservati i file, o se l'identificazione dei parlanti è automatica, quindi conferma questi dettagli per il tuo flusso di lavoro prima di affidare contenuti sensibili o ad alto volume. Se una di queste risposte è decisiva per te, dicci il tuo tipo di file, lingua, numero di parlanti e output previsto e possiamo indicarti la configurazione giusta.
Privacy, diritti e uno standard di revisione sensato
Una trascrizione può contenere informazioni aziendali riservate, dati personali, conversazioni con i clienti, contenuti non ancora pubblicati o materiale protetto da copyright. Prima di caricare, conferma di avere il permesso di elaborare la registrazione, che esista qualsiasi consenso richiesto dei parlanti, e se il video contiene informazioni riservate o regolamentate. Verifica come un provider archivia ed elimina i file caricati e le trascrizioni generate, chi può accedere al progetto e alle esportazioni, e se i file possono essere usati per l'addestramento del modello. Ricorda che trascrivere una registrazione protetta da copyright è tecnicamente facile ma non concede il permesso di ridistribuirne i contenuti; hai comunque bisogno dei diritti per pubblicare la sorgente, la trascrizione, le didascalie o le traduzioni.
Calibra la profondità della revisione in base alla posta in gioco. Una revisione leggera si adatta a clip per i social, note interne e ideazione approssimativa: scorri alla ricerca di errori evidenti, nomi, numeri e frasi mancanti. Una revisione completa si adatta a corsi, didascalie pubbliche, interviste, registrazioni dei clienti, materiale legale e qualsiasi cosa pubblicata: ascolta l'intera registrazione, correggi la formulazione, verifica le etichette dei parlanti, controlla i timestamp e conferma che le didascalie rispettino le regole di formato della piattaforma di destinazione. Per l'accessibilità, rivedi oltre il dialogo, poiché effetti sonori importanti, cambi di parlante e segnali significativi potrebbero necessitare di rappresentazione nelle didascalie.
Il percorso efficiente è sempre lo stesso: inizia con il video più pulito che hai, isola il parlato quando l'audio è difficile, genera una trascrizione modificabile, verifica nomi e numeri, ed esporta il formato richiesto dalla tua piattaforma. Per i team che lavorano su più lingue, quella trascrizione è anche il punto di partenza naturale per la traduzione e il doppiaggio in seguito.
Domande frequenti
Qual è il modo più veloce per trascrivere un video in testo?
Usa uno strumento di speech-to-text automatico che accetta il video direttamente o supporta un link di YouTube. Carica la sorgente più chiara, seleziona la lingua corretta, genera la trascrizione, poi rivedi prima le sezioni più soggette a errori.
Posso trascrivere un video senza digitare manualmente?
Sì. Gli strumenti di speech-to-text con IA convertono automaticamente l'audio parlato in testo modificabile. Dovresti comunque rivedere l'output, perché l'accuratezza può variare con rumore, accenti, parlato sovrapposto e vocabolario specialistico.
DubSmart può trascrivere un video lungo?
Sì. Il nostro strumento Speech to Text accetta audio o video caricati e link di YouTube, supporta la modifica e ti permette di scaricare il progetto finito. Dichiariamo il supporto per più di 60 lingue e un limite di file di 5 GB, senza alcun limite dichiarato sulla durata del video; il tempo di elaborazione effettivo varia con il file e l'audio.
Cosa dovrei fare se la trascrizione ha molti errori?
Migliora prima l'audio sorgente. Rimuovi il rumore concorrente con uno strumento di separazione del parlato, conferma la lingua selezionata, poi rigenera o modifica la trascrizione, prestando particolare attenzione a nomi propri, numeri, accenti e parlanti sovrapposti.
Quale formato di sottotitoli dovrei usare?
Usa il formato richiesto dalla tua piattaforma. SRT è ampiamente supportato, mentre WebVTT è un formato di testo temporizzato orientato al web, e YouTube supporta entrambi tra i suoi formati di sottotitoli.