Se sei arrivato a comfyui text to speech aspettandoti un singolo pulsante che trasforma uno script in audio, la prima cosa che vale la pena sapere è che ComfyUI non è affatto un motore vocale. È uno spazio di lavoro basato su nodi in cui colleghi testo, una voce, un modello, la lingua e un output audio insieme in un grafo riutilizzabile. Il parlato stesso proviene da qualsiasi nodo TTS tu colleghi: un provider ospitato, un'integrazione partner ufficiale o un modello locale che installi tu stesso. La domanda che conta davvero, quindi, non è se ComfyUI possa pronunciare il tuo script, perché può farlo, ma se un grafo visivo sia il posto giusto per il lavoro che devi ripetere.
Questa distinzione plasma ogni altra decisione di questa pagina. ComfyUI premia la sperimentazione e le pipeline multimodali in cui la narrazione si trova accanto alla generazione di immagini, video e audio. Uno strumento vocale dedicato premia la produzione ripetibile in cui hai semplicemente bisogno di voci fuori campo pulite più e più volte. Di seguito, analizziamo come funziona il flusso di lavoro, quali tipi di opzioni esistono, come valutarle e dove un grafo smette di valere la manutenzione.
Indice dei contenuti
Cos'è davvero il text to speech di ComfyUI
Il text to speech di ComfyUI è la pratica di usare un grafo ComfyUI per convertire testo scritto in un output AUDIO. La documentazione ufficiale descrive ComfyUI come un'applicazione open-source basata su nodi per costruire flussi di lavoro per la generazione di immagini, video, audio e 3D, e i suoi nodi audio collegano servizi o modelli vocali esterni a quella stessa tela visiva.
Un grafo vocale funzionante è piccolo. Richiede un input di testo o prompt, un nodo TTS, un input di voce o audio di riferimento, impostazioni opzionali di lingua e resa, e un nodo di anteprima o salvataggio dell'audio. Il nodo TTS spinge il tuo script attraverso un modello vocale e restituisce l'audio generato che i nodi successivi possono utilizzare.
La conseguenza pratica è che ComfyUI è il livello del flusso di lavoro, non il modello. La voce vera e propria può essere prodotta da un provider ospitato, un modello audio partner, un nodo personalizzato di terze parti o un sistema installato localmente. Comprendere questa divisione è ciò che mantiene accurate le tue aspettative: stai assemblando una pipeline e scegli comunque il motore al suo interno.
Come funziona il flusso di lavoro in quattro fasi
Togliendo i nomi dei nodi, ogni grafo vocale di ComfyUI fa le stesse quattro cose in sequenza.
Primo, lo script arriva come testo. Il nodo TTS può prendere direttamente del testo semplice, oppure il testo può arrivare da un altro nodo che carica, traduce o segmenta uno script più lungo. Suddividere una narrazione lunga in sezioni logiche ti permette di rigenerare un paragrafo senza ricostruire l'intera voce fuori campo, e ti aiuta a rimanere sotto il limite di input di un provider.
Secondo, il flusso di lavoro seleziona una voce e un modello. A seconda del provider, potrebbe trattarsi di un parlante preimpostato, una voce clonata, un ID voce o una registrazione di riferimento. La scelta del modello governa anche velocità, qualità, gamma espressiva e costo. Il nodo HeyGen di ComfyUI, ad esempio, espone sia heygen-voice-1 che un più veloce ed economico heygen-voice-1-turbo, mentre il nodo ElevenLabs offre controlli come stabilità, velocità e stile.
Terzo, il modello vocale sintetizza l'audio. I moderni sistemi neurali stimano pronuncia, ritmo, pause e movimento dell'intonazione invece di cucire insieme parole preregistrate, e restituiscono una forma d'onda che puoi instradare in avanti: salvata in un file, mixata con musica, inserita in un grafo video o abbinata a un avatar.
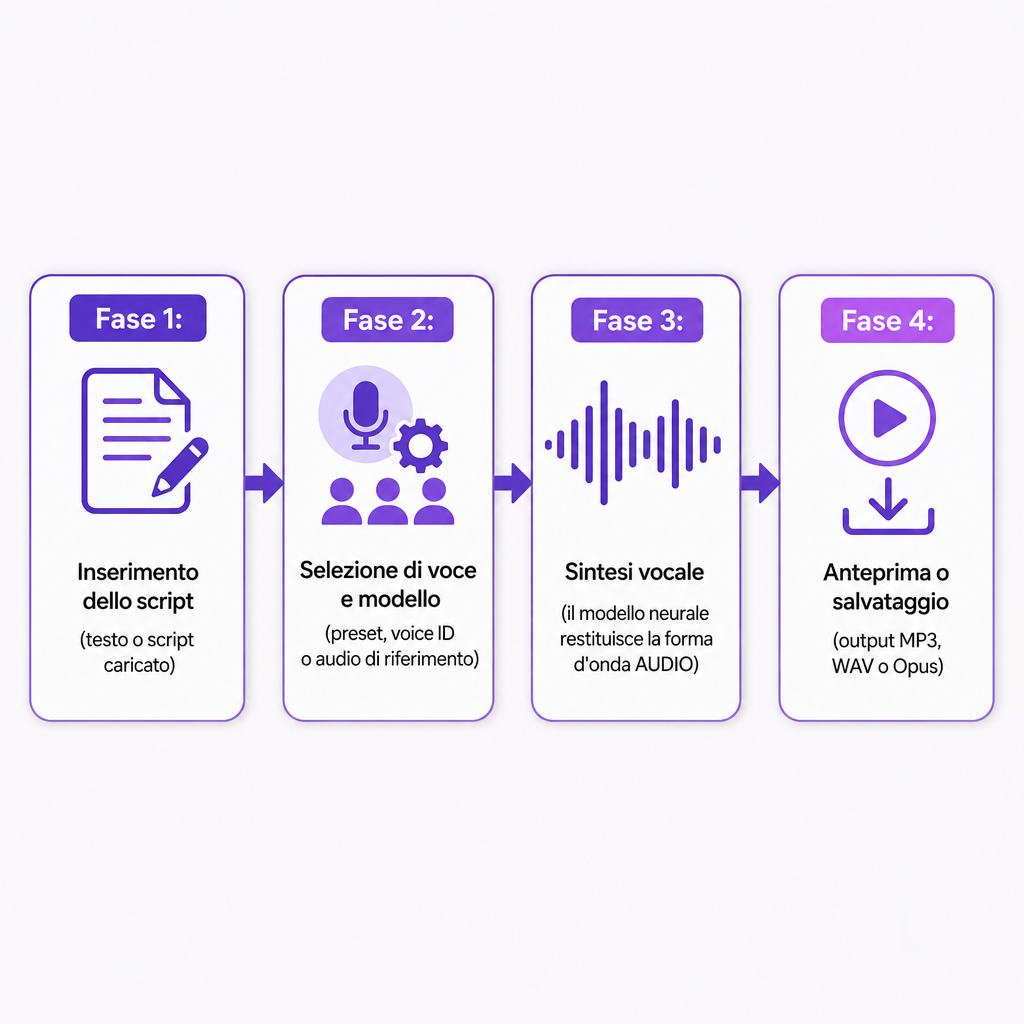
Quarto, l'audio viene visualizzato in anteprima o salvato. I nodi TTS emettono tipicamente un oggetto AUDIO che si collega a un nodo di anteprima o salvataggio, con il formato del file impostato dal nodo e dal provider; la documentazione del nodo ElevenLabs, ad esempio, elenca formati selezionabili tra cui MP3 e varianti Opus. Poiché il grafo è visivo, il ciclo è facile da rieseguire: cambia lo script, la voce, la lingua o il modello, poi mettilo di nuovo in coda.
I tre modi per eseguire il TTS in ComfyUI
Non esiste un unico metodo vocale di ComfyUI, e le differenze si riducono a configurazione, controllo, privacy e quanta manutenzione sei disposto a gestire.
I nodi dei provider ospitati inviano il tuo testo e le impostazioni vocali a un servizio esterno e restituiscono l'audio finito. Questo è solitamente il percorso più rapido verso un parlato di alta qualità perché il modello gira sull'infrastruttura del provider. Il nodo HeyGen Voice 1.0 illustra lo schema: richiede un ID voce clonata valido, invia il testo e l'ID a HeyGen, e restituisce il parlato. Anche i compromessi sono prevedibili, poiché potrebbe essere richiesto un account o una connessione API, l'utilizzo può consumare crediti del provider, il tuo testo e audio vengono elaborati da una terza parte, e i limiti o i prezzi del provider possono cambiare.
I nodi audio dei partner ufficiali estendono la stessa idea su una parte più ampia dello spazio audio. La documentazione audio di ComfyUI separa la generazione di text-to-audio dai casi d'uso di voce e parlato, inclusi il parlato da testo e da audio di riferimento. Queste integrazioni brillano quando il tuo grafo si basa già su altri modelli multimediali ospitati, perché riducono lo spostamento di file tra applicazioni separate.
I nodi TTS della community e locali collegano ComfyUI a sistemi come Edge TTS, Kokoro, Index-TTS e altri modelli che possono girare localmente. I flussi di lavoro locali possono darti più controllo sui tuoi dati e sulla scelta del modello, ma chiedono di più in cambio: installazione, hardware compatibile, download di modelli e risoluzione dei problemi. Un nodo locale non è automaticamente migliore di uno ospitato. Il suo vero vantaggio dipende dal fatto che la tua macchina possa eseguire il modello in modo efficiente, che la qualità vocale regga, che la tua lingua sia supportata, che la licenza consenta l'uso commerciale e che tu possa mantenere vivo il flusso di lavoro nel tempo.
La clonazione vocale e i controlli che puoi aspettarti
La clonazione vocale aggiunge un'identità di riferimento al grafo invece di un parlante predefinito. La struttura è solitamente composta da due parti collegate: un nodo di clonazione che crea o restituisce un'identità vocale, e un nodo TTS che usa quell'identità per pronunciare nuovo testo. La documentazione di HeyGen descrive questo direttamente, dove un nodo Instant Clone produce un voice_id che alimenta il nodo Voice 1.0 Text to Speech; quel flusso di lavoro di clonazione richiede almeno 10 secondi di parlato chiaro, e il nodo TTS accetta fino a 5.000 caratteri per richiesta.
Clona solo con autorizzazione. Non replicare la voce di una persona reale semplicemente perché puoi accedere a una registrazione. Ottieni il permesso, conservane la prova e dichiara il parlato sintetico o clonato ovunque il contesto possa fuorviare un pubblico.
Oltre alla voce stessa, i controlli che incontrerai variano a seconda del nodo e del modello, ma un insieme familiare ricorre nella maggior parte di essi.
- Voce: l'identità del parlante o il preset
- Lingua: la lingua usata per interpretare lo script
- Velocità: quanto rapidamente viene resa la narrazione
- Intonazione: l'altezza percepita, alta o bassa, della voce
- Stile ed espressività: il carattere della resa e quanto fortemente viene applicata l'emozione
- Stabilità: con quanta coerenza la voce mantiene le sue caratteristiche
- Formato di output: come MP3, WAV o Opus
- Audio di riferimento: una registrazione usata per la clonazione o la trasformazione vocale
Alcuni modelli vanno oltre con indicazioni inline. La documentazione del nodo Fish Audio supporta indicazioni di emozione e tag di dialogo multi-parlante nei modelli supportati. Un avvertimento vale per tutti: questi controlli non sono intercambiabili tra i provider, e un'impostazione chiamata stile in un nodo può comportarsi in modo del tutto diverso dallo stile in un altro.
ComfyUI contro una piattaforma TTS dedicata
ComfyUI si guadagna il suo posto quando il parlato è una parte di una pipeline multimediale più grande. Una piattaforma dedicata tende a vincere quando l'unico vero compito è trasformare gli script in una narrazione rifinita senza assemblare un grafo.
| Fattore decisionale | ComfyUI | Piattaforma TTS dedicata |
|---|---|---|
| Flessibilità del flusso di lavoro | Alta; collega il TTS ad altri nodi multimediali | Solitamente focalizzata sulla produzione vocale |
| Configurazione | Può richiedere nodi, collegamenti ai provider o installazioni di modelli | Spesso più veloce per la prima generazione |
| Opzioni vocali | Dipende dai nodi installati o collegati | Solitamente una libreria vocale organizzata |
| Automazione | Forte per grafi visivi riutilizzabili | Spesso tramite API o strumenti batch |
| Elaborazione locale | Possibile con nodi e modelli locali | Solitamente basata sul cloud |
| Caso d'uso migliore | Pipeline sperimentali o multimodali | Narrazione e produzione ripetibili |
Per i creatori che costruiscono una pipeline visiva che fonde il parlato con immagini, video o elaborazione audio, il grafo ripaga da solo. Per la narrazione su YouTube, le voci fuori campo per l'e-learning, i podcast o i team di localizzazione che hanno bisogno di un'interfaccia prevedibile, un servizio specializzato solitamente elimina il sovraccarico tecnico. Il nostro flusso di lavoro Text to Speech è costruito attorno alla generazione diretta da script ad audio, con oltre 300 voci AI, clonazione vocale in 33 lingue, velocità di parlato regolabile, indicazioni di dialogo emotivo e progetti scaricabili. Quando la generazione deve vivere all'interno di un'applicazione o di una pipeline di contenuti automatizzata, la nostra API Text to Speech gestisce il lato dell'integrazione, e la nostra API AI Dubbing estende la stessa idea a video tradotti e con voce corrispondente.
Come scegliere e risolvere i problemi della tua configurazione
Prima di impegnarti con un nodo o un modello, esegui alcuni controlli deliberati invece di fidarti di una breve demo.
Valuta la qualità vocale su un campione difficile, non su uno facile. Genera un passaggio che includa nomi, numeri, acronimi, frasi lunghe, domande, termini di marca e almeno una riga emotiva nella tua lingua e accento target. Una voce che ti affascina in una battuta può storpiare il nome di un prodotto o perdere il ritmo in un paragrafo.
Verifica il supporto di lingua e accento per lingua, non in aggregato. Alcuni sistemi rilevano la lingua automaticamente mentre altri richiedono che tu la imposti, e la documentazione del nodo HeyGen consiglia di impostare la lingua manualmente per lingue strettamente correlate in cui il rilevamento automatico può essere inaffidabile. Ricorda che una voce fluente non può salvare una traduzione inaccurata; la qualità vocale e la qualità della traduzione sono problemi separati.
Misura il controllo della pronuncia per le parole che effettivamente mettono in difficoltà i motori: nomi di prodotti, nomi propri, abbreviazioni, date, valuta e vocabolario tecnico. Se un nodo non offre alcun dizionario di pronuncia o controlli in stile SSML, prevedi di riscrivere il testo foneticamente o di scrivere i numeri per esteso. Per una serie o un canale di marca, testa anche la coerenza eseguendo la stessa voce su più generazioni, toni e sezioni rigenerate, poiché esecuzioni ComfyUI separate per scene diverse possono deviare.
Valuta insieme latenza, costo, privacy e diritti. I nodi ospitati partono veloci ma dipendono dalla velocità della rete, dalla disponibilità del provider, dai limiti dell'account e dai prezzi a consumo, mentre i modelli locali evitano addebiti per richiesta ma richiedono hardware e manutenzione; confronta il costo totale di produzione, non la tariffa pubblicizzata. Sulla privacy, conferma come viene conservato l'input, se il contenuto addestra il modello, se i dati vocali possono essere cancellati, se l'uso commerciale è consentito, chi possiede l'output e quale consenso richiedono le voci clonate.
Quando un grafo si comporta male, i fallimenti si raggruppano in una breve lista. Un nodo di voce clonata che restituisce un errore ha spesso un voice_id vuoto o non valido; il nodo HeyGen si ferma esattamente per questo motivo. Gli script troppo lunghi raggiungono i limiti, e il documentato nodo HeyGen Voice 1.0 accetta fino a 5.000 caratteri avvertendo che un parlato molto lungo può fallire, in particolare per testo cinese o giapponese esteso, quindi suddividi la narrazione in sezioni logiche. La pronuncia errata di solito risponde riscrivendo i numeri in parole, aggiungendo punteggiatura o scrivendo gli acronimi per esteso. Un output troppo espressivo richiede una minore espressività, stile o variazione di intonazione. E quando l'audio non si collega a valle, controlla il tipo, poiché un output AUDIO non può alimentare un nodo che si aspetta un'immagine, un video o del testo senza un passaggio di conversione. Infine, salva un grafo pulito con nodi nominati e impostazioni registrate, perché il provider, l'ID voce, la lingua e il formato di output che hai usato sono i dettagli di cui il te stesso futuro avrà bisogno.
Domande frequenti
ComfyUI è uno strumento di text-to-speech?
ComfyUI è un'applicazione di flusso di lavoro basata su nodi piuttosto che un singolo motore TTS. Può generare parlato tramite nodi integrati, integrazioni partner e nodi TTS della community o locali.
ComfyUI può clonare una voce?
Sì, se l'integrazione selezionata o il nodo personalizzato supportano la clonazione. I requisiti esatti di registrazione, il processo di ID voce, i limiti e i termini commerciali dipendono dal provider.
Il text to speech di ComfyUI funziona offline?
Può farlo quando usi un modello TTS locale compatibile e nodi locali. I nodi dei provider ospitati richiedono una connessione a internet e possono inviare testo o dati vocali al provider.
Qual è il miglior nodo TTS di ComfyUI?
Non esiste un nodo universalmente migliore. Scegli in base al supporto linguistico, alla qualità vocale, alle esigenze di clonazione, alla privacy, al costo, alla latenza e alla compatibilità con il resto del tuo flusso di lavoro.
Posso usare il TTS di ComfyUI per i video di YouTube?
Sì. Genera la narrazione, controlla la pronuncia e i diritti, esporta l'audio e sincronizzalo con il tuo video. Se usi una voce clonata o sintetica, segui i requisiti applicabili di consenso, divulgazione e piattaforma.