Suara text to speech wiseguy adalah ucapan yang dihasilkan AI yang dibuat agar terdengar seperti narator yang jenaka, percaya diri, dan sedikit suka berkelakar yang bisa Anda gunakan kembali di berbagai video, iklan, dan konten pelatihan. Ini bukan teknologi terpisah. Ini adalah gaya sulih suara yang Anda bangun di atas text-to-speech (TTS) biasa dan kloning suara: Anda menulis naskah, memilih atau membuat suara dengan sikap cerdas ala jalanan itu, dan menghasilkan audio yang mempertahankan kepribadian yang sama dari satu konten ke konten berikutnya. Dengan DubSmart AI, persona wiseguy itu bisa berasal dari suara siap pakai di perpustakaan kami atau dari suara khusus yang Anda kloning dari rekaman Anda sendiri.
Perbedaan itu lebih penting daripada labelnya. Kata "wiseguy" menggambarkan nada, bukan tombol. Segala sesuatu yang membuat suara itu dapat dikenali berasal dari tiga tuas yang Anda kendalikan: suara yang Anda pilih, cara Anda menulis naskah, dan cara Anda menyetel penyampaian. Panduan ini menjelaskan apa gaya itu sebenarnya, bagaimana text to speech kami menghasilkannya, tiga cara praktis untuk menjalankannya, dan kapan narator yang menyenangkan membantu versus kapan hal itu diam-diam merugikan kepercayaan Anda.
Daftar isi
Apakah suara wiseguy tepat untuk proyek Anda?
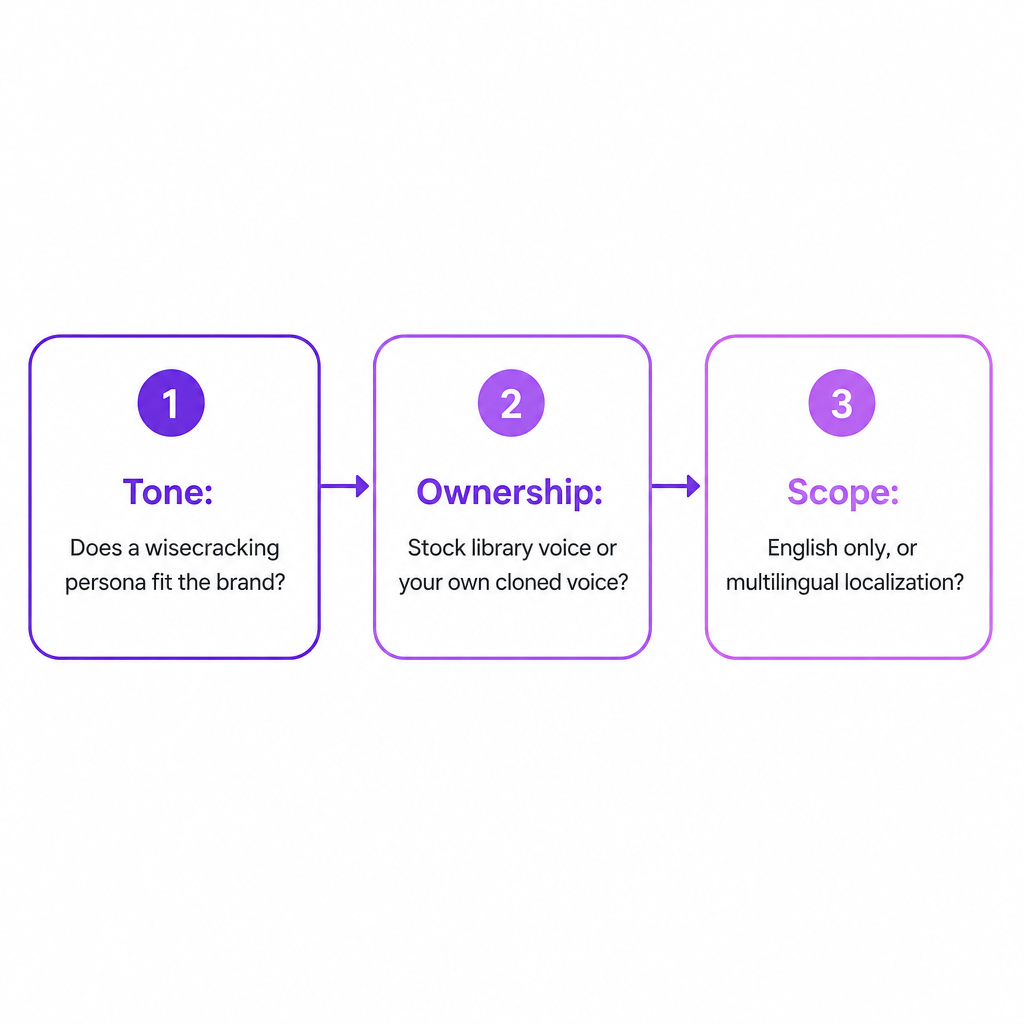
Sebelum Anda mencari suara, selesaikan tiga pertanyaan, karena pertanyaan-pertanyaan itu menentukan segalanya di tahap berikutnya.
Yang pertama adalah nada. Persona yang jenaka dan suka berkelakar dapat membuat konten hiburan, konten kreator, dan penjelasan informal lebih menarik. Namun, itu juga dapat merusak kredibilitas pada materi yang serius. Jika konten Anda berada di bidang kesehatan, keuangan, SDM, hukum, atau kepatuhan, narator yang sok pintar justru merugikan Anda.
Yang kedua adalah kepemilikan. Apakah Anda ingin karakter AI generik yang juga bisa dipilih orang lain, atau suara yang jelas-jelas milik Anda? Suara stok lebih cepat digunakan; suara kloning memberi Anda identitas vokal yang tidak bisa diambil kompetitor mana pun dari rak yang sama.
Yang ketiga adalah cakupan. Jika Anda hanya membutuhkan sulih suara bahasa Inggris hari ini, satu pilihan suara sudah mencukupi. Jika Anda berencana meluas ke bahasa lain, Anda menginginkan persona yang bisa berpindah, yang mendorong Anda ke platform yang menangani keluaran multibahasa tanpa memaksa peralihan alat.
Ketika jawaban jujurnya adalah "merek kami menyenangkan," "kami menginginkan suara yang khas," dan "kami akan berkembang ke banyak bahasa," strategi text to speech wiseguy adalah taruhan jangka panjang yang masuk akal. Jika salah satu dari jawaban tersebut berubah, persempit rencananya sebelum Anda berinvestasi pada suara.
Bagaimana text to speech kami menciptakan suara bergaya wiseguy
Inti dari alat text to speech kami, Anda mengubah teks tertulis menjadi ucapan yang alami dan mirip manusia serta memilih dari perpustakaan lebih dari 300 suara yang mencakup lebih dari 33 bahasa. Katalog itu mencakup berbagai macam aksen, jenis kelamin, dan nada, yang justru menjadi alasan mengapa hasil "wiseguy" dimungkinkan tanpa mode khusus apa pun: Anda hanya memilih suara yang sudah membawa nuansa santai dan percaya diri yang Anda kaitkan dengan narator jenis itu.
Alurnya singkat secara praktis. Anda memilih suara dengan sikap yang tepat, memasukkan teks Anda dalam bahasa yang Anda perlukan, dan menghasilkan audionya. Dari sana Anda bisa menyesuaikan kecepatan, jeda, dan terkadang nada agar penyampaiannya terbaca informal dan percakapan alih-alih datar. Keluarannya adalah file audio yang langsung Anda masukkan ke dalam pengeditan Anda, entah itu unggahan YouTube, modul e-learning, atau iklan pemasaran.
Yang membuat ini lebih dari sekadar trik sekali pakai adalah bahwa DubSmart dibangun sebagai platform serba-satu. Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image, dan Image to Video semuanya berada dalam satu alur kerja. Jadi suara wiseguy yang sama bisa berpindah dari narasi ke versi sulih suara video yang sama tanpa meninggalkan alat atau membangun ulang persona di tempat lain.
Tiga cara menjalankan text to speech wiseguy
Ada tiga rute menuju gaya yang sama, dan perbedaannya terutama pada kecepatan, kepemilikan, dan otomatisasi.
Opsi 1: Suara stok dari perpustakaan. Jalur tercepat adalah memilih suara yang sudah ada dari katalog 300+ kami. Untuk persona wiseguy, cari aksen yang sedikit santai atau urban, nada menengah yang terbaca percaya diri, dan tempo yang cenderung percakapan. Karena alat ini mendukung konten dalam 33+ bahasa, Anda bisa menjalankan suara itu dalam bahasa Inggris sekarang dan meluncurkan bahasa lain seiring pertumbuhan saluran Anda. Rute ini cocok untuk Anda ketika Anda membutuhkan sesuatu segera, Anda tidak keberatan bahwa pengguna lain bisa memilih suara yang sama, dan Anda lebih peduli pada nada dan cakupan bahasa daripada identitas vokal yang unik.
Opsi 2: Kloning persona Anda sendiri. Jika Anda ingin suaranya benar-benar milik Anda, voice cloning kami membangun model sintetis dari pembicara tertentu sehingga ucapan baru bisa dihasilkan dari teks dalam suara itu. Anda merekam sekitar 20 detik ucapan yang jernih, idealnya bebas dari kebisingan latar, dan mengunggahnya ke alat Voice Cloning, yang memprosesnya menjadi profil suara khusus bernama. Setelah kloning selesai, suara itu muncul di samping perpustakaan dasar di dalam Text to Speech maupun AI Dubbing, siap untuk proyek mendatang. Itu berarti satu persona bisa membawa komentar bahasa Inggris Anda, versi sulih suaranya, dan narasi karakter di dalam modul pelatihan. Pilih ini ketika merek Anda berpusat pada pembawa acara yang dapat dikenali, Anda menginginkan suara yang tidak bisa diakses orang lain, dan Anda bisa merekam audio sumber serta mengelola izin untuk pembicara.
Opsi 3: Otomatisasi melalui API. Pengembang dan agensi bisa menghubungkan gaya ini ke aplikasi dan pipeline dengan Text to Speech API kami, layanan RESTful tempat Anda mengirim permintaan POST yang berisi teks dan preferensi suara Anda serta menerima ucapan yang terdengar alami sebagai file audio. Preferensi tersebut bisa merujuk pada ID suara perpustakaan tertentu atau profil suara kloning yang Anda buat sebelumnya. Itu memungkinkan narator khas menggerakkan ringkasan video otomatis, sulih suara tutorial dalam aplikasi, atau salinan pemasaran dinamis yang diambil dari CMS Anda. Back end Anda cukup meneruskan teks dan pengenal suara ke endpoint, dan responsnya di-streaming atau disimpan di mana pun produk Anda memerlukannya. Jika Anda juga melokalkan dalam skala besar, AI Dubbing API dan Voice Cloning API memperluas identitas yang sama ke video sulih suara dan pembuatan suara khusus secara terprogram.
Apa yang terjadi di balik layar
Baik Anda menggunakan suara stok maupun kloning, pipeline mengikuti pola AI dasar yang sama, dan mengetahuinya membantu Anda mendapatkan hasil yang lebih baik.
Pertama datang analisis teks. Sistem menyerap naskah Anda, menormalkan angka dan singkatan, serta memprediksi di mana penekanan dan jeda harus ditempatkan. Inilah sebabnya tanda baca dan panjang kalimat sangat membentuk penyampaian: baris-baris pendek dan tajam secara alami menghasilkan ritme yang terpotong dan percaya diri yang menjadi andalan suara wiseguy.
Berikutnya adalah pemodelan akustik. Sebuah jaringan saraf menggunakan profil suara pilihan Anda untuk memprediksi seperti apa audio seharusnya terdengar dari waktu ke waktu, termasuk nada, kenyaringan, dan pengaturan waktu. Dengan suara kloning, model itu telah disetel dengan cermat untuk mereproduksi karakteristik pembicara tertentu; dengan suara stok, Anda mengandalkan profil terlatih yang sudah cocok untuk gaya tertentu.
Terakhir, pembuatan gelombang suara. Model vocoder mengubah prediksi tersebut menjadi gelombang suara berkualitas tinggi yang terdengar seperti ucapan manusia alami.
Kualitas "wiseguy" tidak tersembunyi di dalam mesin itu. Anda mengarahkannya melalui tiga tuas yang terlihat: pilihan suara (perpustakaan versus kloning), penulisan naskah (bahasa sehari-hari dan kalimat yang ringkas), dan pengaturan penyampaian (kecepatan, jeda, dan terkadang nada). Ubah semua itu, dan Anda mengubah karakternya.
Kriteria keputusan: kapan harus condong, kapan harus menahan diri
Gunakan uji berikut untuk memutuskan seberapa jauh mendorong persona.
| Faktor | Condong ke suara wiseguy | Pilih suara netral |
|---|---|---|
| Kesesuaian merek | Hiburan, kreator, penjelasan informal | Kepatuhan, medis, hukum, SDM |
| Audiens | Pemirsa lebih muda, penutur asli media sosial | Pembeli perusahaan, pelatihan formal |
| Rencana bahasa | Persona dilokalkan dengan hati-hati per pasar | Slang yang tidak akan diterjemahkan dengan mulus |
| Alur kerja | Satu platform memelihara suara di seluruh aset | Beberapa alat yang tidak terhubung |
| Tahap anggaran | Eksperimen kecil sebelum penskalaan | Konten berisiko tinggi tanpa ruang untuk pengujian |
Urutan yang masuk akal adalah menguji suara bergaya wiseguy stok pada sebagian kecil audiens Anda terlebih dahulu. Jika keterlibatan meningkat dan nada cocok dengan merek Anda, pertimbangkan untuk mengkloning persona Anda sendiri untuk diferensiasi jangka panjang. Kemudian gunakan TTS multibahasa dan AI Dubbing untuk mereplikasi persona itu di seluruh saluran yang dilokalkan, menjaga setiap naskah tersetel secara budaya alih-alih diterjemahkan kata demi kata. Karena DubSmart menyatukan alat-alat ini di satu tempat, mempertahankan suara karakter yang konsisten di seluruh narasi dan sulih suara tidak memaksa Anda untuk mengelola aplikasi terpisah. Model berbasis kredit dengan tingkatan gratis juga memberi Anda ruang untuk bereksperimen dalam skala kecil sebelum meningkatkan penggunaan.
Risiko dan pengaman yang layak dibangun
Gaya suara yang ekspresif membawa kerugian nyata jika Anda menerapkannya dengan sembarangan.
Ketidakselarasan merek adalah kegagalan yang paling umum: penyampaian yang terlalu sarkastis mengikis kepercayaan pada topik sensitif. Kesalahan budaya adalah yang berikutnya, karena humor dan sikap "wiseguy" jarang diterjemahkan secara harfiah; apa yang terbaca menyenangkan di satu pasar bisa terdengar kasar di pasar lain. Hak suara paling penting terutama dengan kloning. Modelkan suara orang sungguhan hanya dengan izin yang jelas dan terdokumentasi, yang sangat penting untuk proyek komersial. Dan suara sintetis bisa disalahgunakan untuk peniruan atau konten yang menyesatkan ketika tidak ada kebijakan internal yang mengaturnya.
Pengamannya sederhana. Tulis pedoman nada merek agar persona memiliki batasan. Gunakan suara kloning hanya di bawah perjanjian eksplisit dengan pembicara. Tinjau naskah untuk kepekaan budaya sebelum peluncuran multibahasa apa pun. Dan jauhkan suara wiseguy dari konten di mana netralitas dan otoritas adalah inti utamanya.
Bagaimana berbagai kreator menerapkannya
Bagi kreator YouTube, suara wiseguy bekerja baik sebagai narator saluran berulang untuk intro, komentar, dan bacaan sponsor, sementara kehadiran Anda di depan kamera tetap dicadangkan untuk segmen kunci. Suara yang sama itu kemudian bisa disulihsuarakan ke bahasa lain menggunakan alat terintegrasi. Jika Anda merencanakan perluasan itu, penjelasan kami tentang membangun saluran YouTube multibahasa memandu alur kerja yang lebih luas.
Bagi bisnis kecil dan tim pemasaran, persona memberikan penjelasan produk dan iklan media sosial sentuhan yang berkesan. Hasilkan sulih suara bahasa Inggris melalui TTS, lalu lokalkan kampanye dengan menggunakan kembali suara yang sama atau padanan yang tersetel secara budaya dalam bahasa lain.
Bagi produser e-learning dan pelatihan korporat, cadangkan gaya ini untuk modul informal, tips singkat, dan penambah keterlibatan, serta pertahankan suara netral untuk konten kepatuhan dan kebijakan. Pembagian itu menjaga perhatian tanpa mengorbankan keseriusan di tempat yang penting. Ikhtisar kami tentang apa yang tercakup dalam lokalisasi media adalah pengantar yang berguna jika Anda membangun perpustakaan pelatihan multibahasa.
Bagi pembuat film dan kreator podcast, mengkloning suara karakter tertentu membuatnya bisa menjadi kehadiran khas di seluruh trailer, teaser, dan klip di balik layar. Bagi pengembang dan agensi, menghubungkan TTS API ke pipeline Anda memungkinkan satu narator membacakan salinan dinamis yang diambil dari basis data atau konten buatan pengguna dengan identitas yang konsisten setiap saat.
Pertanyaan yang sering diajukan
Apa itu text to speech wiseguy di DubSmart?
Ini adalah ucapan yang dihasilkan AI di mana Anda memilih atau mengkloning suara yang terdengar seperti narator yang jenaka dan percaya diri, lalu menggunakan text to speech kami untuk mengubah naskah menjadi audio dalam persona itu. Ini mengandalkan TTS standar dan kloning suara alih-alih teknologi terpisah apa pun.
Bisakah DubSmart menangani suara wiseguy dalam banyak bahasa?
Ya. Text to speech kami dan alat terkait mendukung konten dalam lebih dari 33 bahasa, sehingga suara bergaya wiseguy bisa berjalan di seluruh saluran internasional. Lokalkan slang dan humor per pasar alih-alih menerjemahkannya secara harfiah.
Apakah saya membutuhkan banyak audio untuk mengkloning suara wiseguy?
Tidak. Kloning suara dirancang untuk bekerja dari rekaman pendek. Sekitar 20 detik ucapan yang jernih sudah cukup untuk membuat profil suara khusus yang bisa Anda gunakan kembali baik di text to speech maupun AI Dubbing.
Bisakah pengembang memicu narasi wiseguy secara terprogram?
Ya. Text to Speech API kami menerima permintaan POST dengan teks dan preferensi suara serta mengembalikan ucapan yang terdengar alami. Anda bisa merujuk baik suara stok maupun persona kloning berdasarkan ID-nya.
Adakah cara berisiko rendah untuk mencoba ini terlebih dahulu?
Model berbasis kredit dengan tingkatan gratis memungkinkan Anda menguji gaya ini pada video atau kampanye sampel sebelum mengalokasikan anggaran yang lebih besar, yang cocok untuk kreator, bisnis kecil, dan agensi yang bereksperimen dengan persona suara.