Voice cloning API adalah antarmuka pengembang yang mengubah sampel audio yang telah diizinkan menjadi suara sintetis yang dapat digunakan kembali, sehingga sebuah aplikasi dapat mengirim teks—atau menjalankan tugas dubbing otomatis—dan mendapatkan ucapan baru yang menyerupai pembicara asli. Alih-alih memilih suara tetap dari katalog, kode Anda membuat identitas suara yang terikat pada ID unik, lalu menggunakannya kembali di berbagai skrip, produk, dan bahasa. Satu pergeseran itu—dari memilih suara menjadi memilikinya secara terprogram—itulah yang membuat teknologi ini menarik bagi kreator, merek, dan pengembang yang membangun dalam skala besar.
Jawaban singkat untuk apa itu voice cloning api adalah ini: ia mengekspos tiga kemampuan yang saling terhubung—unggah audio, pembuatan suara, dan generasi suara—sebagai endpoint yang dapat dipanggil oleh perangkat lunak Anda. Memahami bagaimana bagian-bagian itu saling terhubung adalah yang membedakan pipeline produksi yang mulus dari yang menjengkelkan, jadi sisa penjelasan ini membahas mekanisme, trade-off, dan pertanyaan hak yang perlu Anda selesaikan sebelum satu file pun tayang.
Daftar isi
Apa yang sebenarnya dilakukan voice cloning API
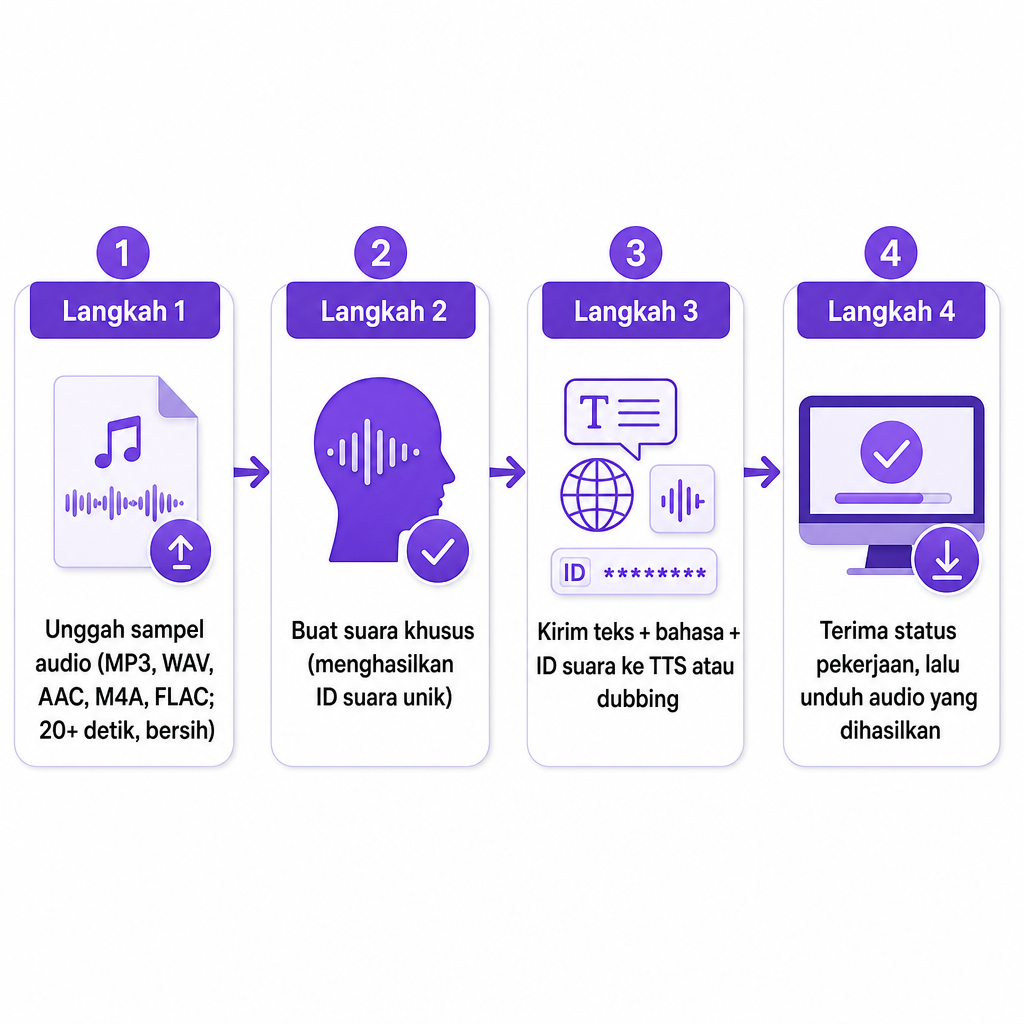
Voice cloning API mengekspos kloning sebagai layanan yang dapat diprogram, bukan fitur manual yang terkubur di dalam editor audio atau dasbor web. Aplikasi Anda mengunggah sampel, penyedia mengubahnya menjadi suara kustom dengan ID-nya sendiri, dan sejak itu ID tersebut menjadi handle yang Anda teruskan ke permintaan text-to-speech atau dubbing.
Polanya konsisten di seluruh penyedia: sampel audio menjadi ID suara kustom, yang menjadi ucapan baru dari teks atau skrip yang diterjemahkan, yang menjadi file audio yang sudah jadi. Pekerjaan machine-learning—menganalisis nada, pola pengucapan, rentang pitch, ritme, dan timbre—terjadi di balik endpoint, dan model suara yang dihasilkan dapat mengucapkan skrip yang sama sekali baru sambil mempertahankan kualitas yang dapat dikenali dari pembicara referensi.
Satu perbedaan lebih penting dari yang lain. API tidak memutar ulang rekaman asli; ia mensintesis ucapan segar. Suara kloning dapat mengucapkan kata-kata yang tidak pernah ada dalam sampel sumber, yang justru itulah alasan ia kuat dan mengapa ia membawa tanggung jawab.
Cara kerja voice cloning di balik API
Penyedia mengimplementasikan model secara berbeda, tetapi sebagian besar sistem berbagi tahap-tahap umum yang sama, dan mengetahuinya membantu Anda merancang integrasi yang andal.
Pertama, sistem menerima sampel suara. Pengembang umumnya mengunggah melalui presigned upload URL, yang memungkinkan aplikasi mengirim file langsung ke penyimpanan alih-alih menjejalkan payload audio besar di dalam permintaan pembuatan suara. Audio sumber yang bersih penting di sini karena model dapat mempelajari suara yang tidak diinginkan bersama pembicara: musik, gema ruangan, beberapa pembicara yang tumpang tindih, distorsi, dan pengurangan noise yang agresif semuanya mengurangi konsistensi kloning. Voice Cloning API kami mendokumentasikan dukungan untuk MP3, WAV, AAC, M4A, dan FLAC, dan merekomendasikan audio minimal 20 detik tanpa noise latar belakang untuk hasil terbaik.
Kedua, penyedia membuat suara kustom. Setelah diunggah, aplikasi mengirimkan lokasi file yang tersimpan dan sebuah nama, dan layanan mengembalikan objek suara dengan pengenal. Pengenal itu adalah kunci dari segala sesuatu yang mengikuti—aplikasi Anda menyimpannya bersama catatan pengguna, proyek, karakter, atau merek di database-nya sendiri. Dokumentasi kami mengikuti pola ini dengan endpoint create, ditambah endpoint untuk mencantumkan suara kustom dengan pagination dan untuk menghapus suara kustom berdasarkan ID.
Ketiga, aplikasi menghasilkan ucapan baru. Setelah suara kustom ada, kode Anda mengirim teks, bahasa, dan ID suara kustom ke endpoint text-to-speech. Layanan mengembalikan pengenal proyek atau tugas; aplikasi kemudian melakukan polling status tugas hingga pemrosesan selesai dan mengambil URL audio yang dihasilkan. TTS API kami mendokumentasikan generasi berbasis proyek dengan status pending, processing, completed, dan failed, serta mengekspos nilai voice, language, speed, dan pitch di tingkat segmen individual.
Jika Anda ingin mekanisme yang lebih dalam dari sisi generasi, penjelasan kami tentang apa itu text to speech API dan cara kerjanya menguraikan pipeline sintesis yang pada akhirnya digerakkan oleh suara kloning.
Voice cloning API versus API text-to-speech dan dubbing
Ketiga API ini saling terkait tetapi menyelesaikan masalah yang berbeda, dan mencampuradukkannya menghasilkan arsitektur yang salah.
| Jenis API | Input utama | Output utama | Paling cocok untuk |
|---|---|---|---|
| API text-to-speech | Teks ditambah suara yang dipilih | Ucapan sintetis | Narasi, peringatan, asisten, audio berskrip |
| Voice cloning API | Sampel audio | ID suara kustom | Membuat identitas suara yang dapat digunakan kembali |
| API AI dubbing | Video atau audio ditambah pengaturan bahasa | Media yang diterjemahkan dan di-dubbing | Lokalisasi video dan audio multibahasa |
Dalam praktiknya, voice cloning API jarang bekerja sendiri. Endpoint kloning membuat suara; endpoint text-to-speech menggunakan ID suara itu untuk mengucapkan teks baru. ID suara yang sama juga dapat mengalir ke alur kerja dubbing, di mana sistem menerjemahkan dialog asli dan menghasilkan penampilan terjemahan dalam suara kustom yang dipilih. Kami menggambarkan suara kustom kami sebagai dapat digunakan dalam proyek TTS maupun AI Dubbing, yang memungkinkan satu sampel 20 detik melayani narasi dan lokalisasi dari identitas yang sama. Untuk arsitektur khusus dubbing, lihat penjelasan pendamping kami tentang apa itu AI dubbing API, dan untuk keluarga endpoint suara yang lebih luas, panduan kami tentang apa itu voice AI API.
Apa yang bisa Anda bangun dengannya
Voice cloning API mendapatkan tempatnya ketika suara yang sama harus dihasilkan berulang kali, di banyak skrip, produk, atau bahasa. Beberapa pola konkret menunjukkan di mana ia cocok.
Seorang kreator YouTube dapat merekam satu sampel suara dan menggunakan kembali suara yang dihasilkan untuk versi video yang dilokalisasi, menghasilkan narasi untuk pasar bahasa yang berbeda tanpa merekam ulang setiap skrip. Kloning tidak menghilangkan kebutuhan untuk meninjau terjemahan—nama, idiom, lelucon, dan referensi budaya masih memerlukan pemeriksaan manusia—tetapi ia menghilangkan hambatan perekaman.
Sebuah perusahaan dapat membuat narator yang konsisten untuk penjelasan produk, video onboarding, iklan, dan konten bantuan, alih-alih menetapkan suara yang berbeda untuk setiap kampanye. Langkah praktis sebelum produksi adalah kebijakan penggunaan suara: departemen mana yang boleh menggunakan suara, konten mana yang memerlukan persetujuan, dan apakah narasi sintetis harus diungkapkan.
Tim pelatihan memperoleh kemampuan untuk memperbarui pelajaran dengan cepat ketika kebijakan, detail produk, atau prosedur berubah, menjaga kontinuitas di seluruh perpustakaan kursus yang besar. Untuk subjek sensitif, tinjauan manusia tetap penting, karena suara yang dihasilkan terdengar percaya diri bahkan ketika skripnya salah. Produser podcast dapat mempertahankan suara host atau karakter yang konsisten untuk intro, koreksi, ringkasan, atau edisi bahasa alternatif, yang berguna ketika suntingan kecil jika tidak akan memerlukan sesi yang sama sekali baru. Dan pengembang yang membangun game, aplikasi edukasi, alat aksesibilitas, atau pengalaman terpandu dapat menjadikan suara sebagai bagian dari alur kerja yang sudah ada alih-alih mengekspor audio secara manual untuk setiap respons.
Cara mengevaluasi voice cloning API
Penyedia yang tepat bergantung pada kebutuhan produksi Anda, bukan pada seberapa mulus terdengarnya satu demo. Telusuri dimensi-dimensi di bawah ini sebelum Anda berkomitmen.
Persyaratan input audio. Konfirmasikan format file yang didukung, panjang sampel minimum atau yang direkomendasikan, apakah beberapa pembicara ditolak, bagaimana noise latar belakang ditangani, apakah unggahan diterima secara langsung, dan apakah file referensi dapat dihapus setelah kloning. Kami mencantumkan MP3, WAV, AAC, M4A, dan FLAC sebagai format yang didukung dan merekomendasikan sampel bersih minimal 20 detik.
Kualitas dan konsistensi suara. Uji suara dengan lebih dari satu kalimat. Sertakan kalimat pendek dan panjang, angka dan tanggal, nama diri, pertanyaan dan seruan, kosakata teknis, dan kata-kata yang sulit diucapkan. Kloning yang memukau dalam demo pendek dapat menyimpang dalam narasi panjang atau bahasa yang tidak dikenal.
Dukungan bahasa dan lokalisasi. Jika output multibahasa adalah tujuannya, verifikasi bahasa sumber dan target yang didukung, apakah suara kustom dapat mengucapkan masing-masing, perilaku aksen dan pengucapan, dan apakah suara tetap dapat dikenali di seluruh bahasa. TTS API kami secara publik menyatakan lebih dari 300 suara AI di 33+ bahasa dan dialek, termasuk Inggris, Portugis, Spanyol, Prancis, Jerman, Mandarin, dan Jepang. Kami tidak menerbitkan katalog bahasa lengkap di halaman tersebut, jadi konfirmasikan kombinasi suara-dan-bahasa yang tepat sebelum Anda mengunci alur kerja produksi.
Arsitektur API. API yang siap produksi harus memberikan penanganan yang dapat diprediksi untuk autentikasi, unggahan, pembuatan suara, pencantuman, penghapusan, status proyek, percobaan ulang, kesalahan validasi, pagination, pengambilan audio, dan pemantauan penggunaan. Kami menunjukkan autentikasi Bearer-token dalam contoh kami dan mendokumentasikan endpoint manajemen suara serta pemrosesan TTS berbasis proyek.
Generasi sinkron versus asinkron. Permintaan pendek mungkin kembali dengan cepat, tetapi konten yang lebih panjang lebih baik ditangani sebagai tugas: kirim permintaan, terima ID tugas, polling atau terima status, lalu unduh audio. Desain asinkron menghentikan permintaan web agar tidak timeout saat narasi panjang atau sejumlah besar segmen dirender. Dokumentasi TTS kami menggunakan status proyek dan nilai progres, dan proyek yang selesai mengembalikan URL audio bersama URL audio per-segmen.
Kontrol output dan pengeditan. Periksa format dan kualitas output, apakah sample rate dapat dikonfigurasi, apakah speed dan pitch dapat disesuaikan, apakah segmen individual dapat diunduh, apakah segmen yang gagal dapat dibuat ulang tanpa menjalankan ulang seluruh proyek, dan apakah URL audio bersifat sementara atau permanen. Kami mendokumentasikan output MP3 pada 22 kHz untuk TTS API dan mengekspos kontrol speed dan pitch di tingkat segmen.
Kontrol penghapusan dan data. Penyedia harus memungkinkan Anda menghapus audio referensi yang diunggah, suara kustom yang dihasilkan, file audio yang dihasilkan, dan data proyek terkait. Voice Cloning API kami menyertakan endpoint delete untuk suara kustom dan menyatakan bahwa pengguna dapat menghapus suara kustom dan audio terkait. Tinjau ketentuan privasi dan komitmen retensi saat ini sebelum mengunggah rekaman yang rahasia atau sensitif secara komersial.
Hak, peniruan, dan penggunaan yang bertanggung jawab
Mengkloning suara adalah keputusan hak, privasi, dan peniruan sebanyak keputusan teknis, dan memperlakukannya hanya sebagai kode adalah cara tim mendapat masalah.
Mulailah dengan izin. Gunakan rekaman hanya ketika Anda memiliki hak untuk mengkloning dan menggunakan suara pembicara tersebut. Untuk alur kerja bisnis, persetujuan tertulis harus membahas pembuatan suara sintetis, penggunaan komersial, bahasa dan wilayah, durasi lisensi, konten iklan dan politik, penggunaan pelatihan dan layanan pelanggan, apakah suara boleh disublisensikan, dan bagaimana ia akan dihapus atau dipensiunkan. Menemukan rekaman online tidak memberi Anda hak untuk mengkloningnya.
Jaga terhadap peniruan, karena suara sintetis dapat membuat permintaan penipuan terdengar meyakinkan. FTC telah memperingatkan bahwa penipu dapat mengkloning suara kerabat atau eksekutif untuk menekan orang agar mengirim uang atau membagikan informasi. Pengamanan yang masuk akal termasuk membatasi siapa yang dapat membuat atau mengakses suara kustom, mewajibkan persetujuan sebelum menerbitkan audio yang dihasilkan, mencatat aktivitas generasi, memisahkan kredensial pengembangan dan produksi, menerapkan batas laju, memblokir kategori konten berisiko tinggi, dan mewajibkan saluran verifikasi kedua untuk permintaan finansial.
Untuk audiens AS, panggilan keluar menambahkan bobot hukum. FCC menyatakan bahwa suara yang dihasilkan AI termasuk dalam pembatasan Telephone Consumer Protection Act atas suara buatan atau rekaman sebelumnya, dan panggilan semacam itu umumnya memerlukan persetujuan tegas sebelumnya kecuali ada pengecualian yang berlaku. Voice cloning API bukan lisensi untuk mengotomatiskan telemarketing, penagihan utang, panggilan politik, atau komunikasi sensitif identitas. Anda dapat membaca putusan FCC tentang suara robocall yang dihasilkan AI dan peringatan konsumen FTC tentang voice cloning secara langsung.
Terakhir, kloning mengubah penyampaian, bukan kebenaran. Suara yang realistis membuat pernyataan yang tidak akurat terdengar otoritatif, jadi tinjau nama dan angka, terjemahan, klaim medis, finansial, atau hukum apa pun, instruksi produk, pengucapan, pengaturan waktu, dan teks di layar sebelum dirilis. Untuk video multibahasa, periksa baik skrip terjemahan maupun audio akhir—kloning yang baik tidak dapat menyelamatkan kesalahan terjemahan.
Apakah voice cloning API tepat untuk proyek Anda?
Voice cloning API sangat cocok ketika Anda membutuhkan suara yang sama di banyak file, Anda sudah memiliki pipeline teks, terjemahan, atau media yang andal, Anda menginginkan generasi terprogram daripada ekspor manual sesekali, Anda memegang izin terdokumentasi untuk menggunakan suara referensi, Anda memproduksi konten yang dilokalisasi atau dipersonalisasi dalam skala besar, dan Anda dapat menguji serta meninjau audio yang dihasilkan sebelum dirilis.
Suara TTS preset mungkin lebih melayani Anda ketika kecepatan, kesederhanaan, dan risiko hukum rendah lebih penting daripada kontinuitas merek. Aktor suara profesional sering kali merupakan pilihan yang tepat untuk kampanye unggulan, penampilan bernuansa, topik sensitif, atau pekerjaan yang membutuhkan arahan manusia penuh. Untuk tim yang membutuhkan suara kustom maupun lokalisasi di satu tempat, kami menyajikan kloning, TTS, dan AI dubbing sebagai kemampuan API yang terhubung: Voice Cloning API kami membangun suara kustom dari sampel, dan TTS API kami menggunakan ID suara untuk menghasilkan ucapan di dalam alur kerja proyek. Ketika Anda siap menyambungkannya, panduan kami tentang cara mengintegrasikan voice cloning API membahas langkah unggah-buat-hasilkan secara rinci.
Evaluasi yang paling berguna adalah uji terkontrol: gunakan sampel yang bersih dan diizinkan, hasilkan skrip yang sama dalam bahasa yang Anda tuju, periksa kualitas dan latensi, verifikasi kontrol siklus hidup dan penghapusan API, dan wajibkan persetujuan manusia sebelum apa pun diterbitkan.
Pertanyaan yang sering diajukan
Apakah voice cloning API sama dengan AI voice generator?
Tidak. AI voice generator biasanya memungkinkan Anda memilih suara sintetis yang sudah ada dan menghasilkan ucapan dari teks. Voice cloning API membuat suara kustom dari sampel audio, yang kemudian dapat Anda gunakan kembali untuk generasi.
Berapa banyak audio yang dibutuhkan untuk mengkloning suara?
Persyaratan bervariasi menurut penyedia dan model. Kami merekomendasikan audio bersih minimal 20 detik dan mendukung format input MP3, WAV, AAC, M4A, dan FLAC.
Dapatkah suara kloning berbicara dalam bahasa lain?
Terkadang. Itu bergantung pada model penyedia, bahasa yang didukungnya, dan kemampuan suara untuk ditransfer antar bahasa. Verifikasi kombinasi suara-bahasa yang tepat alih-alih mengasumsikan setiap kloning bekerja sama baiknya di mana saja.
Dapatkah saya menggunakan suara kloning untuk AI dubbing?
Ya, ketika penyedia menghubungkan kloning dengan dubbing. Kami memungkinkan suara kustom digunakan dalam proyek AI Dubbing dengan mereferensikan ID suara.
Apakah voice cloning legal?
Teknologi itu sendiri tidak otomatis ilegal, tetapi menggunakan suara seseorang tanpa izin dapat menimbulkan masalah privasi, hak publisitas, kontrak, penipuan, dan perlindungan konsumen. Dapatkan izin, patuhi hukum yang berlaku, dan hindari peniruan yang menyesatkan.