Memilih antara tts vs voice cloning untuk narasi bermuara pada satu pertanyaan jujur: apakah Anda membutuhkan suara yang andal untuk konten, atau identitas pembicara tertentu di dalamnya? Text to speech standar memberi Anda narasi yang cepat dan fleksibel dari pustaka siap pakai. Voice cloning menciptakan ulang suara yang dapat dikenali sehingga orang yang sama tampak berbicara di seluruh skrip, video, dan bahasa baru. Bagi banyak kreator dan tim, langkah cerdasnya adalah keduanya: buat prototipe dengan suara stok untuk kecepatan, lalu alihkan pekerjaan yang disetujui ke tiruan yang berizin begitu identitas merek atau kesinambungan pembicara mulai menjadi penting. Sisa panduan ini menunjukkan dengan tepat di mana masing-masing unggul.
Daftar isi
Cara tercepat untuk berhenti berputar-putar pada pilihan ini adalah memisahkan dua hal yang terus-menerus dikaburkan orang: gaya sebuah suara dan identitas di baliknya. Suara TTS standar memberi Anda gaya yang siap produksi. Ia bisa membaca dengan hangat, berwibawa, energik, santai, atau netral, dan Anda memilihnya karena cocok dengan skrip. Suara tiruan memberi Anda kesinambungan dengan orang tertentu. Pendengar mengenalinya sebagai kreator, instruktur, pendiri, atau narator, dan Anda memilihnya karena identitas itu adalah bagian dari produk.
Perbedaan itu mengubah lebih dari sekadar bagaimana sebuah klip terdengar. Ia mengubah beban operasional Anda. Gaya adalah sesuatu yang bisa Anda tukar dengan bebas; identitas adalah sesuatu yang Anda lindungi, dokumentasikan, dan jaga konsistensinya di setiap file baru. Ingatlah pembagian itu dan sebagian besar keputusan di bawah akan terjawab dengan sendirinya.
Bagaimana narasi text to speech sebenarnya bekerja
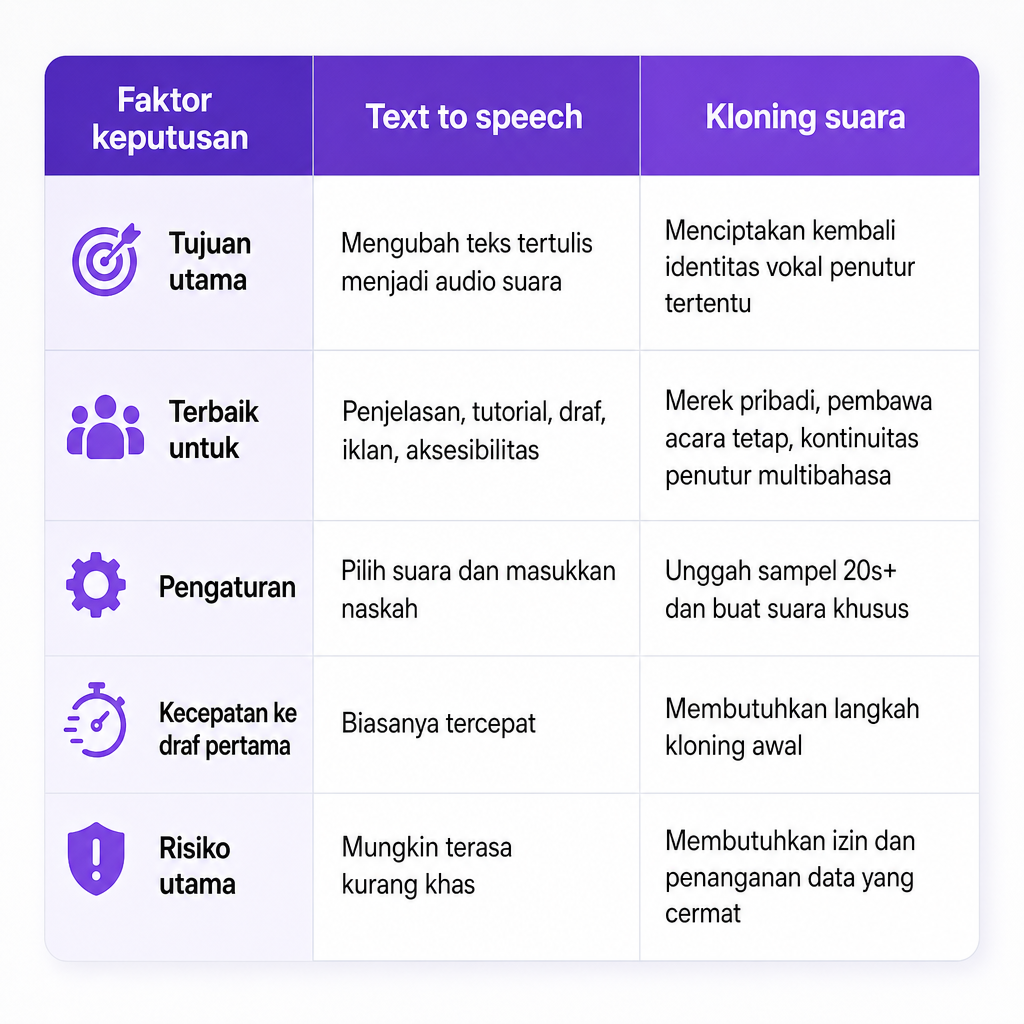
Text to speech mengubah teks tertulis menjadi ucapan tersintesis. Sistem membaca skrip Anda, menafsirkan pelafalan dan struktur kalimat, lalu merender trek audio dalam suara yang Anda pilih dari katalog. Anda tidak menangkap orang tertentu yang membaca kata-kata itu; Anda menghasilkan ucapan baru dalam gaya suara yang sudah dibuat sebelumnya.
Dalam praktiknya Anda mengendalikan sejumlah kecil tuas: bahasa, aksen, profil vokal, nada, kecepatan bicara, dan gaya penyampaian. Fleksibilitas itulah intinya. Ketika harga, nama produk, statistik, atau pelajaran berubah, Anda mengedit teks dan menghasilkan ulang hanya bagian yang terpengaruh alih-alih memesan studio lagi. Alat Text to Speech kami menjalankan loop itu dari awal hingga akhir: masukkan teks, pilih pembicara dari 300+ suara AI, hasilkan, edit proyek, dan unduh, dengan kontrol kecepatan bicara dan isyarat teks untuk penekanan.
Gunakan TTS standar ketika suara itu sendiri tidak harus dapat dikenali. Ia cocok untuk draf pertama dan versi uji, saluran yang sering menerbitkan dan membutuhkan pembaruan cepat, alur kerja di mana beberapa orang menulis atau mengelola skrip, serta konten yang membutuhkan suara berbeda untuk karakter atau bagian yang berbeda. Ia juga pilihan alami ketika Anda ingin menjajaki beberapa bahasa, aksen, atau gaya penyampaian, atau ketika Anda memproduksi materi instruksional, informasional, dan yang berfokus pada aksesibilitas. Misalnya, usaha kecil yang merilis tutorial produk mingguan dapat mempertahankan satu suara stok yang konsisten dan memperbarui fitur serta ajakan bertindak tanpa pernah mengoordinasikan rekaman.
Bagaimana narasi voice cloning sebenarnya bekerja
Voice cloning membangun ucapan sintetis yang menyerupai orang tertentu. Sistem menganalisis sampel untuk pelafalan, nada, ritme, intonasi, dan gaya bicara, lalu menggunakan karakteristik tersebut untuk menghasilkan ucapan baru dari teks. Ini bukan memotong voiceover yang sudah jadi ke dalam timeline. Ia menghasilkan model suara yang dapat digunakan kembali yang bisa membacakan skrip yang tidak pernah direkam oleh pembicara.
Sampel melakukan sebagian besar pekerjaan berat. Halaman Voice Cloning kami mencatat bahwa Anda dapat membuat suara kustom dari file audio minimal 20 detik, dan rekaman bersih tanpa kebisingan latar memberikan hasil yang lebih baik. Gaya bicara dalam unggahan itu terbawa: referensi monoton cenderung menghasilkan narasi yang lebih datar, sementara sampel dengan energi dan emosi yang benar-benar Anda inginkan memberi model target yang lebih kuat. Setelah dibuat, suara tersebut dapat digunakan kembali dalam proyek Text to Speech maupun AI Dubbing.
Pilih cloning ketika identitas pembicara adalah bagian dari merek atau produk. Ia cocok untuk host YouTube yang perlu menerbitkan lebih sering tanpa merekam setiap baris, podcaster yang mengoreksi bagian kecil alih-alih merekam ulang satu episode, perusahaan yang menginginkan satu suara pendiri atau instruktur yang konsisten, dan kursus yang harus membawa instruktur yang sama di berbagai bahasa. Seorang guru online dapat merekam sampel bersih sekali, lalu menggunakan tiruan yang berizin untuk menyegarkan pelajaran, memperbaiki fakta yang usang, atau membuat versi untuk pelajar internasional. Untuk tinjauan lebih mendalam tentang penggunaan ulang identitas di berbagai format, lihat panduan kami tentang AI dubbing vs voice cloning untuk menggunakan ulang konten.
Pembagian inti: gaya suara atau identitas suara
Jika Anda tidak mengingat apa pun yang lain, ingatlah kerangka ini, karena ia menyelesaikan sebagian besar kasus pelik lebih cepat daripada bagan fitur mana pun. TTS standar adalah masalah pemilihan: Anda memilih gaya dari rak, dan Anda bisa berubah pikiran minggu depan tanpa biaya. Cloning adalah komitmen kesinambungan: Anda mengunci diri pada satu identitas dan setuju untuk memelihara, mengatur, dan mempertahankannya dari waktu ke waktu.
Itulah sebabnya merek yang dipimpin pendiri berperilaku berbeda dari saluran penjelas tanpa wajah bahkan ketika skripnya tampak identik. Penjelas hanya membutuhkan suara yang kompeten, jadi TTS mengerjakannya. Merek pendiri bergantung pada pengenalan, jadi suara tiruan menjadi aset yang sepadan dengan penyiapan dan dokumen tambahan. Ketika Anda merasa buntu, tanyakan apakah menukar suara bulan depan akan merugikan hubungan audiens dengan konten. Jika ya, Anda berada di wilayah cloning. Untuk perbandingan dua jalur ini secara langsung, penjelasan kami tentang memilih antara suara tiruan dan suara TTS stok menguraikan kriterianya secara lebih mendalam.
Mana yang digunakan, berdasarkan tujuan produksi
Jawaban yang tepat berubah sesuai dengan apa yang sebenarnya Anda buat. Berikut bagaimana pilihan tersebut diterapkan pada pekerjaan narasi yang paling umum.
Kreator YouTube. TTS cocok untuk saluran tanpa wajah, penjelas, video daftar, dan konten bergaya berita di mana tidak ada identitas host yang dipertaruhkan. Cloning cocok untuk saluran yang penontonnya mengaitkan dengan presenter tertentu, memungkinkan Anda mempertahankan suara yang dapat dikenali sambil melewati perekaman ulang untuk koreksi, intro, dan variasi bentuk pendek. Untuk ekspansi multibahasa, pasangkan suara kustom dengan AI Dubbing alih-alih menciptakan identitas narasi terpisah per bahasa.
Usaha kecil dan tim pemasaran. Andalkan TTS untuk variasi kampanye, penjelas produk, iklan sosial, dan perubahan teks yang sering. Gunakan cloning ketika seorang pendiri, duta, atau juru bicara menjadi pusat kepercayaan. Tiruan dapat menyuarakan variasi skrip yang disetujui, tetapi ia tidak pernah menggantikan peninjauan klaim, pelafalan, dan nada merek.
E-learning dan pelatihan korporat. TTS bersinar ketika kursus mencakup banyak modul, subjek, atau pembaruan yang sering, karena suara stok memudahkan penugasan suara berbeda ke kursus atau peran yang berbeda. Cloning cocok untuk program di mana pelajar mengharapkan satu instruktur sepanjang kursus, atau di mana Anda menyegarkan kursus yang ada tanpa kehilangan identitas vokal yang familiar. Bagaimanapun juga, peninjauan manusia terhadap nama, istilah teknis, singkatan, dan angka tetap penting.
Podcast dan film independen. Gunakan TTS untuk trek awal, uji narasi, dan pekerjaan sementara sebelum pembicara akhir dikunci. Gunakan cloning untuk pengambilan tambahan yang konsisten, versi alternatif, atau pelokalan yang disetujui dari host atau pemeran, dengan hak dan tujuan penggunaan didokumentasikan sebelum produksi dimulai.
Pengembang dan agensi. TTS biasanya merupakan titik masuk API yang lebih sederhana: kirim teks, pilih suara, terima ucapan. Cloning cocok untuk aplikasi yang membutuhkan suara kustom yang persisten per klien, merek, atau karakter. Voice Cloning API kami menerima unggahan dalam format MP3, WAV, AAC, M4A, dan FLAC, mengembalikan suara kustom yang dapat Anda referensikan dalam TTS atau AI Dubbing, dan menyediakan operasi untuk membuat daftar dan menghapus suara kustom.
Mana yang terdengar lebih alami
Tidak ada opsi yang secara otomatis menjadi yang alami. Suara stok berkualitas tinggi bisa dengan mudah mengalahkan tiruan yang dibangun dari audio berisik, dan sampel yang buruk mereproduksi kekurangannya sendiri: dengung latar, penyampaian yang tidak merata, nada emosional yang tidak cocok dengan skrip. Kealamian adalah keluaran yang Anda uji, bukan label yang Anda asumsikan.
Nilai hasilnya terhadap kriteria konkret daripada kesan pertama:
- Pelafalan: apakah ia benar dalam mengucapkan nama, akronim, angka, dan istilah teknis?
- Prosodi: apakah ritmenya sesuai dengan skrip?
- Konsistensi: apakah suaranya tetap stabil di berbagai klip dan bahasa?
- Emosi: apakah penyampaiannya sesuai dengan tujuan narasi?
- Kejelasan: apakah ia dapat dipahami di ponsel, laptop, dan headphone?
- Kemampuan mengedit: dapatkah Anda menghasilkan ulang satu kalimat tanpa membuat seluruh trek melenceng?
- Pelokalan: apakah ia tetap cocok ketika diadaptasi untuk pasar lain?
Untuk TTS, jalankan beberapa suara stok pada paragraf yang sama dan bandingkan. Untuk cloning, uji skrip representatif dengan kata-kata sulit, rentang emosi, dan tempo proyek yang sudah jadi, bukan hanya sapaan singkat. Sapaan hampir selalu terdengar baik; pekerjaan sesungguhnya adalah di mana tiruan menunjukkan kelemahannya.
Hak, izin, dan pengungkapan yang tidak boleh dilewati
Cloning membawa tanggung jawab yang tidak dimiliki TTS biasa, karena ia dapat mereproduksi suara orang yang dapat diidentifikasi. Hanya tiru suara ketika Anda memiliki izin dan hak untuk tujuan penggunaan yang dimaksud, dan buat izin itu spesifik. Izin yang baik mencakup siapa yang memiliki rekaman sumber, di mana suara sintetis boleh muncul, apakah penggunaan komersial diizinkan, bahasa dan wilayah mana yang disertakan, apakah periklanan atau dubbing diizinkan, berapa lama izin berlaku, bagaimana model dan file sumber disimpan, serta apa yang terjadi ketika lisensi berakhir.
Kami memperlakukan izin dan penggunaan etis sebagai bagian dari pendekatan voice cloning kami, dan API kami mendukung penghapusan suara kustom beserta data audio terkaitnya. Konfirmasi ketentuan terkini yang berlaku untuk akun dan proyek Anda sebelum mengunggah sampel. Latar belakang hukumnya juga masih berubah: Kantor Hak Cipta A.S. telah mengidentifikasi replika suara realistis sebagai replika digital dan merekomendasikan perlindungan federal tambahan terhadap replika yang tidak sah, sebagaimana diuraikan dalam laporannya tentang hak cipta dan replika digital.
Ada juga lapisan pengungkapan. Panduan YouTube tentang pengungkapan konten yang dihasilkan AI menyebut penghasilan suara seseorang secara sintetis untuk menarasikan sebuah video sebagai konten yang diubah atau sintetis yang realistis yang harus diungkapkan oleh kreator. Jadi jangan menyajikan suara tiruan sebagai rekaman yang tidak diubah jika hal itu bisa menyesatkan penonton. FTC secara terpisah telah memperingatkan bahwa voice cloning membuat penipuan peniruan identitas lebih meyakinkan, yang persis mengapa otorisasi dan penggunaan yang transparan bukanlah kemewahan opsional.
Aturan keputusan yang bisa Anda terapkan hari ini
Jika audiens membutuhkan suara yang bagus, pilih TTS. Jika audiens membutuhkan pembicara tertentu ini, pilih voice cloning.
Mulailah dengan TTS ketika kecepatan, variasi, eksperimen, dan perubahan skrip yang sering mendominasi. Ia lebih cepat untuk diuji, lebih mudah untuk direvisi, dan membuka beragam suara tanpa memerlukan sampel. Beralihlah ke cloning ketika pengenalan, kesinambungan, dan identitas pembicara adalah intinya, seperti saluran yang dipimpin kreator, kursus yang dipimpin instruktur, merek yang dipimpin pendiri, host podcast, atau juru bicara multibahasa. Gunakan hanya sampel yang resmi, tinjau audio yang dihasilkan dengan saksama, dan ikuti aturan pengungkapan di mana aturan itu berlaku.
Banyak tim akhirnya memilih keduanya, dan secara sengaja: buat prototipe dengan suara stok, lalu migrasikan konten berulang yang disetujui ke suara kustom begitu produksi membenarkan penyiapan tersebut. Hibrida itu sangat efektif untuk saluran YouTube, kursus online, kampanye bermerek, dan pustaka multibahasa. Kami menyatukan keduanya ke dalam satu alur kerja, sehingga Anda dapat memulai dengan narasi fleksibel dari 300+ suara, membuat suara kustom dari sampel audio, dan menggunakannya kembali di TTS atau AI Dubbing seiring proyek berkembang.
Pertanyaan yang sering diajukan
Apakah voice cloning sama dengan TTS?
Tidak. TTS mengubah teks tertulis menjadi ucapan menggunakan suara sintetis yang dipilih. Voice cloning membuat model suara kustom yang dimaksudkan untuk menyerupai pembicara tertentu, yang kemudian dapat menghasilkan narasi TTS.
Apakah TTS lebih baik daripada voice cloning?
Tidak secara universal. TTS biasanya unggul dalam hal kecepatan, variasi suara, pengujian, dan pembaruan yang sering. Cloning unggul ketika identitas pembicara tertentu harus tetap konsisten di seluruh konten baru.
Berapa banyak audio yang dibutuhkan untuk meniru suara dengan DubSmart?
Halaman Voice Cloning kami menyebutkan bahwa unggahan harus berisi audio minimal 20 detik. Rekaman bersih tanpa kebisingan latar direkomendasikan untuk hasil yang lebih baik.
Dapatkah saya menggunakan suara tiruan untuk narasi multibahasa?
Ya. Suara tiruan dapat digunakan kembali dalam AI Dubbing di seluruh bahasa yang kami dukung. Uji pelafalan dan kesesuaian budaya di setiap pasar sasaran sebelum menerbitkan.
Haruskah kreator YouTube mengungkapkan narasi AI?
Periksa kontrol pengungkapan YouTube saat ini. YouTube mengidentifikasi penghasilan suara seseorang secara sintetis untuk narasi sebagai konten yang diubah atau sintetis yang realistis yang mungkin memerlukan pengungkapan.