Cara tercepat untuk mentranskripsi video menjadi teks adalah membiarkan alat AI speech-to-text melakukan percobaan pertama: unggah file video atau tempel tautan YouTube, biarkan sistem mengubah audio ucapan menjadi transkrip yang dapat diedit, lalu tinjau bagian yang paling mungkin salah. Langkah terakhir itu lebih penting daripada yang diperkirakan kebanyakan orang, karena "cepat" seharusnya berarti transkrip percobaan pertama yang cepat ditambah penyapuan kendali mutu yang singkat, bukan kesempurnaan instan. Pengetikan manual, sebaliknya, berarti berhenti, memutar ulang, dan mengetik ulang setiap baris, dan di situlah waktu berjam-jam menghilang.
Jika Anda ingin versi praktis tentang cara mentranskripsi video menjadi teks, alur kerja Speech to Text kami menerima unggahan video dan tautan YouTube, memungkinkan Anda mengedit proyek yang dihasilkan, mendukung lebih dari 60 bahasa, dan menangani file hingga 5 GB tanpa batas durasi video yang dinyatakan. Sisa panduan ini menjelaskan mekanisme di baliknya, cara memilih output yang tepat, dan cara menjaga akurasi tetap tinggi saat audio sulit ditangani.
Daftar isi
Apa arti sebenarnya mentranskripsi video menjadi teks
Transkripsi video mengubah audio ucapan di dalam video menjadi kata-kata tertulis. Satu output itu dapat melayani banyak pekerjaan: transkrip video lengkap, subtitle atau closed caption, naskah pengeditan, draf blog atau buletin, catatan rapat dan kuliah yang dapat dicari, atau teks sumber yang kemudian Anda terjemahkan untuk audiens baru.
Membantu untuk memisahkan tiga istilah yang sering dikaburkan. Transkripsi mempertahankan bahasa lisan asli dalam bentuk teks. Terjemahan mengubah konten tersebut ke bahasa lain. Dubbing mengganti atau menambahkan audio ucapan dalam bahasa yang berbeda. Anda mentranskripsi terlebih dahulu, lalu memutuskan apakah terjemahan atau dubbing adalah langkah berikutnya. Jika Anda ingin definisi yang lebih mendalam tentang teknologi pengenalan di balik semua ini, panduan kami tentang cara kerja speech-to-text membahas dasar-dasarnya.
Cara kerja transkripsi video AI di balik layar
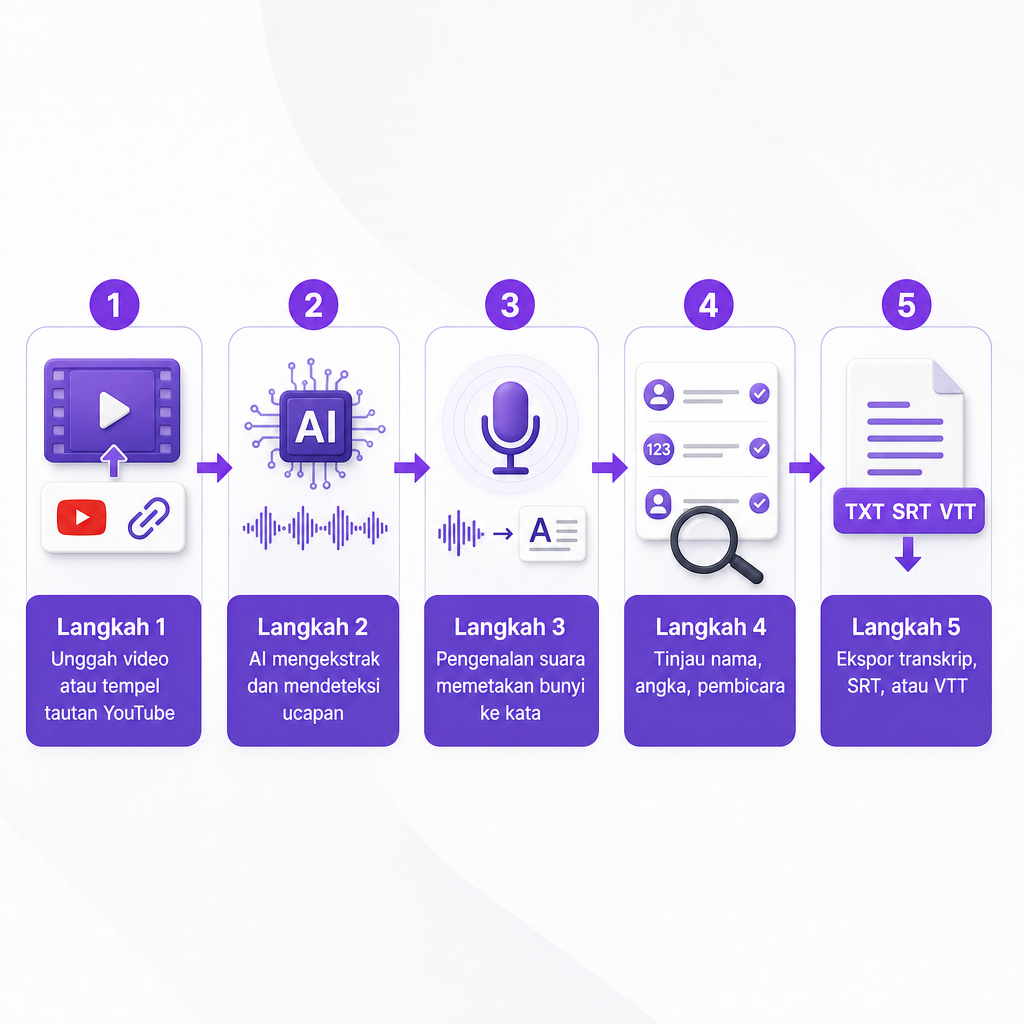
Mengetahui alurnya membantu Anda memprediksi dari mana kesalahan berasal. Sebagian besar sistem transkripsi otomatis melewati tahapan yang sama. Pertama, sistem membaca trek audio di dalam video. Selanjutnya, ia mendeteksi bagian mana yang benar-benar berisi ucapan. Model pengenalan kemudian memetakan pola suara ke kata-kata, dan langkah pemrosesan bahasa menggunakan konteks sekitarnya untuk meningkatkan prediksi tersebut. Kata-kata yang dikenali dirangkai menjadi kalimat atau segmen berwaktu, dan akhirnya Anda mengoreksi serta mengekspor hasilnya.
Model pengenalan hanyalah sebagian dari persamaan kualitas. Kualitas mikrofon, pembicara yang tumpang tindih, aksen, musik latar, gema ruangan, kosakata teknis, dan interupsi semuanya membentuk output. Sistem Speech to Text kami dibangun untuk menangani lingkungan berisik, beberapa pembicara, serta berbagai bahasa dan dialek, dengan catatan jujur bahwa akurasi bervariasi tergantung kualitas audio dan keragaman aksen. Catatan itu adalah alasan mengapa langkah peninjauan ada, bukan cacat yang harus disembunyikan.
Transkrip, caption, atau subtitle: pilih output yang tepat
Format ekspor terbaik sepenuhnya bergantung pada untuk apa teks itu dibuat, dan memilih yang salah akan membuang waktu nanti.
Transkrip biasa adalah teks yang dapat dibaca tanpa penentuan waktu yang diperlukan. Gunakan itu saat Anda membutuhkan catatan riset, rekaman rapat, naskah video, draf blog atau buletin, atau konten untuk digunakan ulang. Timestamp bersifat opsional di sini, meskipun membantu editor untuk melompat-lompat.
Caption menyinkronkan teks dengan video dan dapat membawa informasi non-ucapan yang relevan seperti musik, tepuk tangan, atau pintu yang tertutup. Hal ini penting untuk aksesibilitas dan bagi siapa saja yang menonton tanpa suara. Subtitle biasanya menampilkan dialog yang diucapkan untuk pemirsa yang tidak memahami bahasanya. Saat Anda membutuhkan subtitle dalam bahasa lain, transkripsi bahasa aslinya terlebih dahulu, lalu terjemahkan dan tentukan waktu teks terjemahannya.
Untuk format berwaktu, WebVTT adalah standar web untuk trek teks yang selaras waktu; spesifikasi W3C WebVTT mendeskripsikannya sebagai format untuk caption, subtitle, bab, deskripsi, dan metadata lain yang disinkronkan dengan audio atau video. Untuk unggahan YouTube, SubRip .srt dan .vtt keduanya termasuk di antara format subtitle yang didukung, dan YouTube mencatat bahwa file .srt dasar harus menggunakan pengodean UTF-8 biasa.
Bersihkan audio sebelum Anda mentranskripsi video berisik
Kebisingan latar belakang adalah salah satu penyebab paling umum kesalahan transkripsi. Suara jalanan, AC, umpan balik mikrofon, musik yang bersaing, dan gema ruangan semuanya mengaburkan batas antar kata, dan model pengenalan memiliki sinyal yang lebih sedikit untuk diproses.
Solusinya adalah mengisolasi ucapan sebelum transkripsi. Speech Separator kami menghilangkan kebisingan latar belakang dan memisahkan kata-kata yang diucapkan dari audio sekitarnya, mendukung format utama seperti MP3, WAV, dan AAC serta file video. Ia mendapatkan tempatnya dalam alur kerja untuk wawancara yang direkam di luar ruangan, podcast yang diambil di ruangan tanpa perlakuan akustik, video dengan musik latar yang kuat, diskusi panel dengan tingkat mikrofon yang tidak merata, dan rekaman arsip yang membawa dengungan atau kebisingan ambien.
Satu peringatan untuk pekerjaan aksesibilitas: jangan menghilangkan setiap suara secara refleks. Jika suatu kebisingan membawa makna, seperti sirene, alarm, atau pengumuman pengeras suara, hal itu mungkin masih perlu diwakili dalam caption meskipun dikecualikan dari trek ucapan bersih yang Anda kirim untuk transkripsi.
Cara meningkatkan akurasi transkripsi
Perlakukan transkripsi AI sebagai draf pertama yang kuat, lalu terapkan kontrol yang ditargetkan alih-alih membaca ulang semuanya secara membuta.
Mulailah dengan file sumber yang paling jernih. Unggah rekaman asli daripada unduhan media sosial yang terkompresi, karena sinyal ucapan yang lebih bersih memberi model lebih banyak untuk diproses. Kurangi audio yang bersaing dengan menurunkan atau menghilangkan musik latar, dan gunakan trek ucapan yang paling bersih yang tersedia jika video memiliki trek terpisah. Pilih bahasa atau dialek yang cocok dengan rekaman saat opsi itu ada, yang membantu sistem menafsirkan pelafalan, ejaan, dan struktur kalimat.
Kemudian atasi titik-titik kegagalan yang dapat diprediksi. Cari transkrip untuk kata benda khusus seperti nama, merek, lokasi, istilah produk, dan jargon alih-alih memercayai pembacaan umum. Tinjau perubahan pembicara, dan tambahkan label pembicara secara manual saat transkrip akan digunakan untuk tujuan hukum, pendidikan, riset, atau editorial. Verifikasi item singkat yang kritis maknanya: tanggal, harga, persentase, pengukuran, URL, akronim, negasi seperti "tidak," dan kata-kata yang terdengar mirip, karena satu kesalahan saja dapat membalikkan makna sebuah kalimat.
Metode yang paling andal adalah memutar video sambil mengikuti transkrip. Untuk rekaman yang panjang, loncat terlebih dahulu ke bagian dengan nama, angka, audio yang tidak jelas, atau suara yang tumpang tindih. Hal ini mencerminkan peringatan yang layak diinternalisasi: caption otomatis dapat salah mewakili ucapan karena kesalahan pelafalan, aksen, dialek, dan kebisingan latar belakang.
Menyesuaikan alur kerja dengan jenis konten Anda
Format yang berbeda membebani bagian proses yang berbeda, jadi sesuaikan di mana Anda menghabiskan waktu peninjauan.
Untuk video YouTube, transkrip menjadi sumber untuk caption, deskripsi, bab, pemilihan klip, dan penggunaan ulang yang berfokus pada pencarian; gunakan unggahan asli atau sumber berkualitas tinggi saat Anda memiliki video. Wawancara dan podcast biasanya membutuhkan label pembicara dan penanganan kebisingan yang lebih kuat, jadi bersihkan audio lingkungan yang ramai terlebih dahulu dan jaga konsistensi identitas pembicara. Video e-learning dan pelatihan harus memprioritaskan akurasi dalam instruksi, terminologi, angka, dan referensi di layar, dengan caption yang disinkronkan cukup dekat agar pembelajar mengikuti penjelasan dan layar secara bersamaan.
Rapat bisnis berubah menjadi rekaman yang dapat dicari dan item tindakan, tetapi percakapan sensitif memerlukan perhatian ekstra: verifikasi nama, keputusan, tanggal, dan tanggung jawab yang ditetapkan sebelum berbagi. Video sosial format pendek sering mengubah transkrip menjadi caption di layar, deskripsi postingan, atau versi terjemahan, jadi jaga agar jeda baris tetap pendek untuk perangkat seluler dan pastikan caption tidak menutupi visual penting.
Cara memilih alat video-ke-teks
Evaluasi seluruh alur kerja, bukan sekadar angka akurasi yang diiklankan. Tabel di bawah ini memetakan kriteria yang benar-benar mengubah waktu penyelesaian dan kualitas output Anda.
| Kriteria keputusan | Apa yang harus diperiksa |
|---|---|
| Dukungan input | Apakah menerima video, audio, atau URL YouTube Anda? |
| Batasan file | Berapa ukuran file maksimum dan durasi video? |
| Cakupan bahasa | Apakah mendukung bahasa, dialek, dan aksen Anda? |
| Penanganan pembicara | Dapatkah Anda mengidentifikasi atau memisahkan beberapa pembicara? |
| Format output | Dapatkah Anda mengekspor teks biasa, SRT, atau VTT? |
| Integrasi | Apakah ada API untuk memproses video dalam skala besar? |
Halaman Speech to Text publik kami mengonfirmasi input video dan tautan YouTube, proyek yang dapat diedit, unduhan, dukungan untuk lebih dari 60 bahasa, dan batas ukuran 5 GB. Kami tidak menyatakan di halaman tersebut apakah setiap output menyertakan timestamp, berapa lama file disimpan, atau apakah identifikasi pembicara bersifat otomatis, jadi konfirmasikan spesifik tersebut untuk alur kerja Anda sendiri sebelum mengirimkan konten sensitif atau bervolume tinggi. Jika salah satu jawaban tersebut menentukan bagi Anda, beri tahu kami jenis file, bahasa, jumlah pembicara, dan output yang Anda inginkan, dan kami dapat mengarahkan Anda ke konfigurasi yang tepat.
Privasi, hak, dan standar peninjauan yang masuk akal
Transkrip dapat berisi informasi bisnis rahasia, data pribadi, percakapan pelanggan, konten yang belum dirilis, atau materi berhak cipta. Sebelum mengunggah, pastikan Anda memiliki izin untuk memproses rekaman, bahwa persetujuan pembicara yang diperlukan ada, dan apakah video berisi informasi rahasia atau yang diatur. Periksa bagaimana penyedia menyimpan dan menghapus file yang diunggah dan transkrip yang dihasilkan, siapa yang dapat mengakses proyek dan ekspor, dan apakah file dapat digunakan untuk pelatihan model. Ingat bahwa mentranskripsi rekaman berhak cipta secara teknis mudah tetapi tidak memberikan izin untuk mendistribusikan ulang kontennya; Anda tetap memerlukan hak untuk memublikasikan sumber, transkrip, caption, atau terjemahan.
Kalibrasikan kedalaman peninjauan sesuai dengan risikonya. Peninjauan ringan cocok untuk klip sosial, catatan internal, dan ide kasar: pindai kesalahan yang jelas, nama, angka, dan kalimat yang hilang. Peninjauan penuh cocok untuk kursus, caption publik, wawancara, rekaman pelanggan, materi hukum, dan apa pun yang dipublikasikan: dengarkan rekaman lengkap, koreksi kata-kata, verifikasi label pembicara, periksa timestamp, dan konfirmasikan caption memenuhi aturan format platform tujuan. Untuk aksesibilitas, tinjau melampaui dialog, karena efek suara penting, perubahan pembicara, dan isyarat bermakna mungkin perlu diwakili dalam caption.
Jalur yang efisien selalu sama setiap kali: mulai dengan video paling bersih yang Anda miliki, isolasi ucapan saat audio sulit, hasilkan transkrip yang dapat diedit, verifikasi nama dan angka, dan ekspor format yang diperlukan platform Anda. Bagi tim yang bekerja lintas bahasa, transkrip itu juga merupakan titik awal alami untuk terjemahan dan dubbing nantinya.
Pertanyaan yang sering diajukan
Apa cara tercepat untuk mentranskripsi video menjadi teks?
Gunakan alat speech-to-text otomatis yang menerima video secara langsung atau mendukung tautan YouTube. Unggah sumber paling jernih, pilih bahasa yang benar, hasilkan transkrip, lalu tinjau bagian yang paling rawan kesalahan terlebih dahulu.
Dapatkah saya mentranskripsi video tanpa mengetik manual?
Ya. Alat AI speech-to-text mengubah audio ucapan menjadi teks yang dapat diedit secara otomatis. Anda tetap harus meninjau outputnya, karena akurasi dapat bervariasi tergantung kebisingan, aksen, ucapan yang tumpang tindih, dan kosakata khusus.
Dapatkah DubSmart mentranskripsi video yang panjang?
Ya. Alat Speech to Text kami menerima audio atau video yang diunggah dan tautan YouTube, mendukung pengeditan, dan memungkinkan Anda mengunduh proyek yang selesai. Kami menyatakan dukungan untuk lebih dari 60 bahasa dan batas file 5 GB, tanpa batas durasi video yang dinyatakan; waktu pemrosesan sebenarnya bervariasi tergantung file dan audio.
Apa yang harus saya lakukan jika transkrip memiliki banyak kesalahan?
Tingkatkan audio sumber terlebih dahulu. Hilangkan kebisingan yang bersaing dengan alat pemisah ucapan, konfirmasikan bahasa yang dipilih, lalu hasilkan ulang atau edit transkrip, dengan perhatian khusus pada nama khusus, angka, aksen, dan pembicara yang tumpang tindih.
Format subtitle mana yang harus saya gunakan?
Gunakan format yang diperlukan platform Anda. SRT didukung secara luas, sementara WebVTT adalah format teks berwaktu yang berorientasi web, dan YouTube mendukung keduanya di antara format subtitle-nya.