Jawaban jujur atas berapa banyak audio untuk mengkloning suara lebih singkat daripada yang diperkirakan kebanyakan orang: dengan DubSmart AI, Anda membutuhkan setidaknya 20 detik rekaman bersih dari satu pembicara. Minimum itu membuat klon yang dapat digunakan mulai berjalan, tetapi jarang menceritakan keseluruhan ceritanya. Panjang yang sebenarnya harus Anda rekam bergantung pada di mana suara itu akan digunakan—klip sosial tunggal, narator saluran berulang, perpustakaan kursus multibahasa, atau juru bicara merek yang harus terdengar identik di lusinan video. Di bawah ini, kami memisahkan minimum keras dari target praktis, menjelaskan apa yang sebenarnya didengarkan oleh model, dan memberi Anda aturan keputusan yang dapat Anda terapkan sebelum menekan rekam.
Daftar isi
Minimum versus target praktis
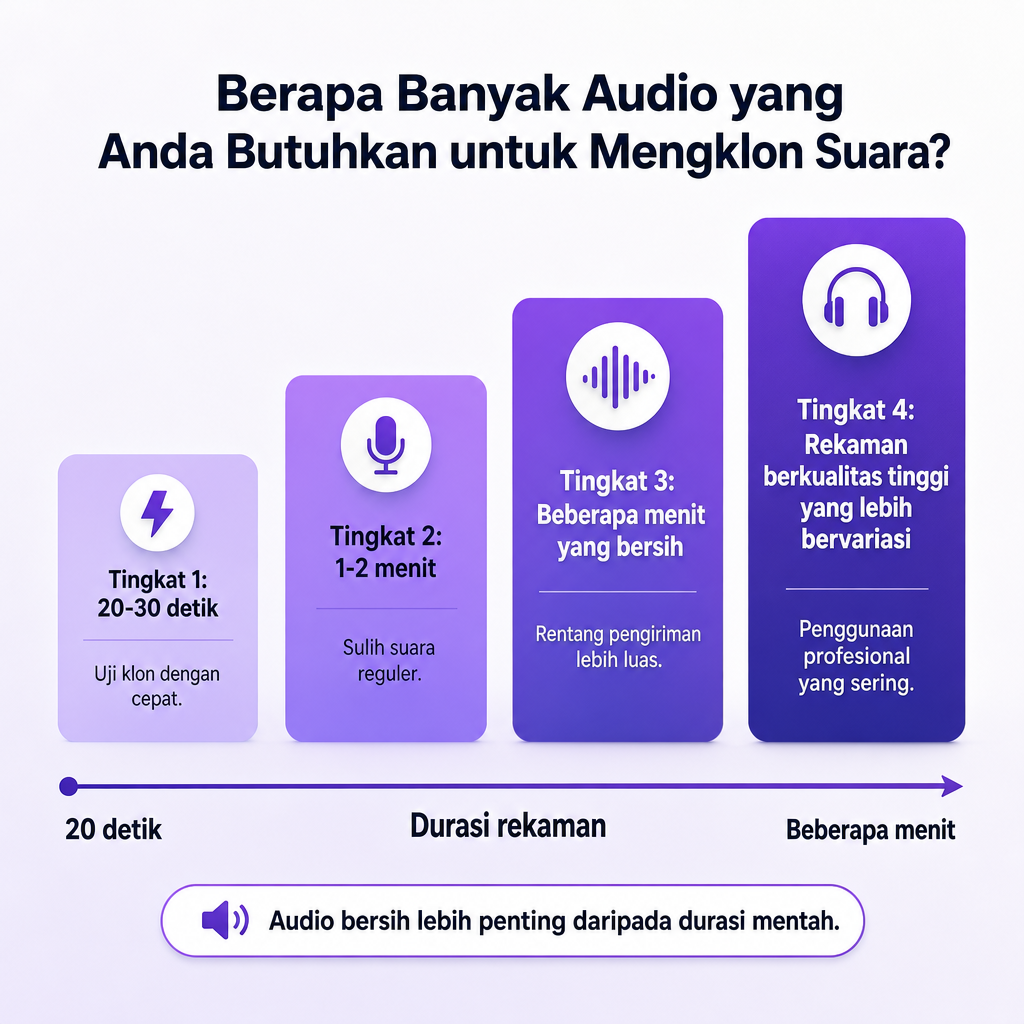
Dua puluh detik adalah batas bawah, bukan garis akhir. Sampel dengan panjang minimum menangkap identitas dasar seorang pembicara, yang seringkali cukup untuk pengujian cepat atau klip sekali pakai. Tetapi jumlah materi yang Anda berikan kepada model secara langsung membentuk seberapa baik klon menangani skrip yang bervariasi. Target yang tepat menyesuaikan dengan seberapa menuntut dan berulangnya keluaran tersebut.
| Tujuan Anda | Target audio praktis |
|---|---|
| Menguji klon dengan cepat | 20–30 detik |
| Membuat sulih suara rutin | 1–2 menit |
| Menangkap rentang penyampaian yang lebih luas | Beberapa menit bersih |
| Membangun suara untuk penggunaan profesional yang sering | Rekaman yang lebih bervariasi dan berkualitas tinggi |
Prinsip di balik seluruh tabel ini terus terang: audio yang bersih dan konsisten biasanya lebih berharga daripada rekaman panjang yang penuh dengan kebisingan, gema, musik, atau banyak pembicara. Klip 30 detik yang rapi dapat mengalahkan klip 10 menit yang berantakan. Jika Anda ingin memahami mekanisme yang lebih luas tentang bagaimana sampel menjadi suara yang dapat digunakan kembali, penjelasan kami tentang bagaimana kloning suara menciptakan kembali suara mencakup keseluruhan alurnya.
Apa arti sebenarnya dari “audio yang cukup”
“Cukup” sebenarnya bukan angka stopwatch—ini adalah pertanyaan tentang apakah model memiliki cukup ucapan yang berguna untuk merekonstruksi suara yang Anda inginkan. Saat Anda mengkloning suara, AI menganalisis rekaman untuk mengidentifikasi serangkaian karakteristik dan kemudian menggunakannya untuk menghasilkan ucapan baru dari teks atau dialog yang diterjemahkan.
Karakteristik tersebut meliputi:
- Nada dan timbre vokal
- Tinggi nada dan ritme berbicara
- Pengucapan dan aksen
- Jeda dan irama
- Energi, penekanan, dan penyampaian emosional
Sampel pendek menetapkan identitas inti pembicara. Sampel yang lebih panjang dan bervariasi menambahkan informasi tentang bagaimana orang itu terdengar saat menjelaskan, bertanya, menekankan, berhenti, atau mengubah nada emosional. Jadi target sebenarnya adalah audio yang representatif: materi yang menunjukkan kepada model suara yang melakukan jenis-jenis hal yang nantinya akan diminta untuk dilakukan.
Kapan merekam lebih dari 20 detik
Lampaui minimum kapan pun suara yang dikloning akan muncul berulang kali, mewakili suatu merek, atau membawa konten berformat lebih panjang. Untuk kasus-kasus tersebut, titik awal yang praktis adalah satu hingga dua menit ucapan bersih, dengan tambahan jika Anda membutuhkan suara untuk mereproduksi rentang gaya penyampaian yang lebih luas.
Sampel yang lebih panjang membuahkan hasil untuk pekerjaan yang padat narasi: video YouTube, podcast, kursus daring, pelatihan perusahaan, konten gaya buku audio, penjelasan produk, sulih suara multibahasa, dialog karakter, dan kampanye pemasaran yang berulang. Seorang kreator yang hanya merekam perkenalan yang tenang cenderung mendapatkan klon yang bekerja paling baik dalam satu register tenang itu. Seorang kreator yang merekam penjelasan, pertanyaan, penekanan, dan jeda alami memberikan model lebih banyak contoh suara dalam aksi. Tujuannya tidak pernah untuk membuang jumlah menit maksimum—melainkan untuk menyediakan audio yang mewakili bagaimana suara itu benar-benar berperilaku.
Mengapa audio bersih mengalahkan audio panjang
Lebih banyak audio hanya membantu jika materi tambahan berkualitas tinggi dan relevan. Rekaman 10 menit dengan gema ruangan, ketukan keyboard, musik latar, mikrofon yang berpindah-pindah, atau beberapa pembicara bisa kurang berguna daripada klip pendek yang bersih. Kebisingan yang lebih keras tetaplah kebisingan, jadi menaikkan gain tidak pernah menyelamatkan sampel yang buruk.
Audio tambahan memperoleh tempatnya ketika audio tersebut:
- Diucapkan dengan jelas oleh satu orang
- Konsisten dalam volume dan jarak mikrofon
- Bebas dari musik, efek suara, dan suara yang tumpang tindih
- Direkam di lingkungan yang tenang dan rendah gema
- Disampaikan dengan kecepatan alami
- Mewakili gaya yang ingin Anda hasilkan
Beberapa kebiasaan merekam melindungi kualitas lebih dari target panjang apa pun. Jaga satu pembicara dalam klip; suara lain membingungkan analisis. Pilih ruangan kecil berperabot daripada ruangan kosong besar untuk mengurangi pantulan, dan jaga jarak mikrofon yang stabil sepanjang waktu. Jangan merekam satu bagian dari jarak dekat dan bagian lain dari seberang ruangan, dan hindari mengisi file dengan keheningan panjang atau audio yang tidak terkait. Jika satu-satunya sumber Anda adalah video yang bising, bersihkan dulu daripada berharap panjang dapat mengimbangi—panduan kami tentang menghapus musik latar dari audio menjelaskan pembersihan tersebut.
Apa yang sebenarnya harus dikatakan sampel Anda
Konten sama pentingnya dengan kondisi. Rekaman harus berisi ucapan yang jelas dan alami daripada suara terisolasi atau frasa yang terpotong-potong. Sampel yang kuat memadukan kalimat pendek dan panjang, rentang bunyi vokal dan konsonan, angka dan tanggal, nama dan istilah umum, pertanyaan, pernyataan tegas, dan jeda alami—idealnya dalam jenis bahasa yang sama dengan yang akan digunakan konten akhir.
Seperti apa hal itu dalam praktiknya bervariasi menurut kreator. Seorang YouTuber mungkin merekam perkenalan singkat, penjelasan, ajakan bertindak, dan beberapa baris pada tingkat penekanan yang berbeda. Seorang produser e-learning dapat menyertakan frasa instruksional, definisi, daftar, dan transisi. Seorang juru bicara bisnis diuntungkan dengan memasukkan terminologi merek dan gaya percakapan yang digunakan dalam konten yang menghadap pelanggan. Memutuskan apakah Anda benar-benar membutuhkan klon di sini adalah pertanyaan yang wajar; uraian kami tentang suara kloning vs suara TTS stok membantu ketika suara perpustakaan dapat melakukan pekerjaan lebih cepat.
Kloning multibahasa dan audio sumber yang bising
Untuk proyek multibahasa, persyaratan awalnya tetap kualitas sampel suara asli. Menerjemahkan ucapan yang dihasilkan ke dalam bahasa lain tidak menghilangkan kebutuhan akan rekaman sumber yang jelas—klip bahasa Inggris yang keruh menghasilkan klon yang keruh di setiap bahasa target.
Saat Anda berencana melokalkan, perhatikan kejelasan suara asli, pengucapan nama dan istilah merek, nada yang dimaksudkan dalam setiap bahasa, apakah gaya pembicara harus tetap formal, ramah, energik, atau percakapan, dan apakah skrip yang diterjemahkan telah ditinjau sebelum sulih suara. Pada proyek lokalisasi yang lebih besar, uji bagian singkat di setiap bahasa target sebelum memproses video penuh; itu memunculkan masalah pengucapan, tempo, dan adaptasi budaya sejak dini. Alur kerja AI Dubbing DubSmart dapat menggunakan suara kloning untuk konten yang diterjemahkan, dan suara kloning dapat digunakan baik dalam Text to Speech maupun AI Dubbing.
Kualitas sumber adalah separuh lainnya dari masalah ini. Anda sering dapat mengekstrak ucapan dari video, tetapi musik latar, efek suara, suasana ruangan, angin, kebisingan penonton, ucapan yang tumpang tindih, dan artefak kompresi semuanya membuat klip menjadi titik awal yang buruk. Jika sumber berharga tetapi bising, isolasikan ucapannya terlebih dahulu. Speech Separator kami menarik trek suara dari elemen audio lainnya, dan semakin bersih trek itu, semakin andal klonnya.
Persetujuan dan hak untuk mengkloning suara
Anda hanya dapat mengkloning suara orang lain ketika Anda memiliki izin dan hak yang sesuai. Kloning suara membawa risiko hukum, etika, privasi, dan peniruan identitas yang nyata, jadi sebelum mengunggah rekaman orang lain, dapatkan persetujuan mereka yang terinformasi dan konfirmasikan bagaimana suara itu dapat digunakan, didistribusikan, dan disimpan. Aturan Voice Cloning Challenge dari Komisi Perdagangan Federal AS mengharuskan peserta untuk mengkloning suara hanya dengan persetujuan orang yang suaranya dikloning.
Untuk pekerjaan komersial, dokumentasikan siapa yang memiliki atau mengendalikan suara, rekaman mana yang boleh digunakan, jenis konten dan bahasa apa yang diizinkan, apakah penggunaan komersial diperbolehkan, berapa lama izin berlaku, apakah orang tersebut dapat menariknya, dan bagaimana konten sintetis akan diungkapkan jika sesuai. Jangan mengkloning tokoh publik, karyawan, pelanggan, aktor, atau anggota keluarga hanya karena Anda dapat mengakses rekaman mereka. Akses bukanlah izin.
Berapa banyak merekam berdasarkan jenis kreator
Minimum yang sama berlaku untuk semua orang, tetapi target praktis bergeser sesuai risiko produksi. Gunakan minimum ketika kecepatan penting—pengujian kreatif awal, klip berformat pendek, prototipe internal, pengumuman sederhana—dan rekam lebih banyak kapan pun suara harus tetap konsisten di banyak video atau bahasa.
| Kreator | Sampel yang direkomendasikan |
|---|---|
| Kreator YouTube | 20 dtk untuk menguji; 1–2 menit yang bersih dan ekspresif untuk narator berulang |
| Bisnis kecil / pemasaran | Klip juru bicara yang konsisten dengan terminologi dan energi kampanye; uji sulih suara singkat terlebih dahulu |
| E-learning / pelatihan | Sampel yang lebih panjang dan bervariasi mencakup definisi, instruksi, pertanyaan, transisi |
| Podcaster | Sampel yang mencerminkan tempo normal pembawa acara; periksa pengucapan nama dan sponsor |
| Pembuat film | Sampel yang sesuai dengan arahan karakter, termasuk bisikan, intensitas, atau kualitas dramatis lainnya |
| Pengembang / agensi | Standar audio yang dapat diulang yang diterapkan sebelum menerima sampel klien |
Dua catatan praktis berada di balik tabel itu. Sampel netral tidak akan mereproduksi penampilan yang bergantung pada bisikan, ironi, atau ketakutan, jadi pembuat film harus menangkap karakter, bukan hanya suaranya. Dan untuk alur yang digerakkan API, standar penerimaan tetap mencegah hasil yang tidak konsisten di seluruh klien; Voice Cloning API kami membuat suara khusus dari sampel audio dan membuatnya tersedia untuk Text to Speech dan AI Dubbing.
Pemeriksaan singkat sebelum mengunggah menjaga hasil tetap dapat diprediksi. Pastikan sampel berjalan setidaknya 20 detik, menampilkan satu pembicara, tidak membawa musik atau suara yang tumpang tindih, memiliki gema dan kebisingan latar belakang minimal, menjaga posisi dan tingkat mikrofon yang stabil, berisi ucapan alami daripada keheningan panjang, cocok dengan gaya yang dimaksudkan, dan berasal dari pembicara yang telah menyetujui penggunaan yang dimaksudkan.
Gunakan 20 detik untuk menguji konsep, satu hingga dua menit untuk narasi sehari-hari yang andal, dan lebih banyak audio bersih yang bervariasi ketika suara harus tampil secara konsisten di seluruh konten berformat panjang atau multibahasa.
Minimum membuat Anda memulai. Kualitas rekaman, konsistensi pembicara, rentang ekspresif, dan izin menentukan apakah hasilnya siap untuk dipublikasikan.
Pertanyaan yang sering diajukan
Berapa banyak audio yang Anda butuhkan untuk mengkloning suara?
Dengan DubSmart, Anda membutuhkan setidaknya 20 detik audio. Untuk cakupan penyampaian pembicara yang lebih baik, targetkan satu hingga dua menit ucapan yang bersih dan alami.
Apakah 10 detik cukup untuk mengkloning suara?
Mungkin cukup untuk beberapa sistem, tetapi itu berada di bawah minimum yang dinyatakan DubSmart. Unggah setidaknya 20 detik untuk klon DubSmart.
Apakah satu menit cukup untuk kloning suara?
Sering kali ya, untuk narasi sehari-hari, asalkan bersih, konsisten, dan diucapkan secara alami. Sampel yang lebih besar dan bervariasi membantu untuk penggunaan ekspresif atau profesional.
Apakah rekaman yang lebih panjang membuat klon lebih akurat?
Tidak secara otomatis. Panjang tambahan hanya membantu jika menambahkan contoh suara yang bersih dan relevan. Kebisingan, gema, musik, dan banyak pembicara mengurangi nilai audio tambahan.
Apakah saya perlu izin untuk mengkloning suara?
Ya. Dapatkan persetujuan dan konfirmasikan hak yang berlaku sebelum mengkloning suara orang lain, mencakup penggunaan yang dimaksudkan, distribusi, dan aktivitas komersial. Aturan tantangan kloning suara FTC juga mengharuskan persetujuan dari orang yang suaranya dikloning.
Dapatkah saya menggunakan klon suara untuk AI dubbing?
Ya. Suara yang dibuat dapat digunakan baik dalam Text to Speech maupun AI Dubbing.