Jika Anda tiba di comfyui text to speech dengan harapan ada satu tombol yang mengubah naskah menjadi audio, hal pertama yang perlu diketahui adalah bahwa ComfyUI sama sekali bukan mesin suara. Ini adalah ruang kerja berbasis node tempat Anda menghubungkan teks, suara, model, bahasa, dan keluaran audio menjadi sebuah grafik yang dapat digunakan kembali. Suaranya sendiri berasal dari node TTS apa pun yang Anda sambungkan: penyedia yang di-hosting, integrasi mitra resmi, atau model lokal yang Anda pasang sendiri. Pertanyaan yang sebenarnya penting, karenanya, bukanlah apakah ComfyUI dapat mengucapkan naskah Anda, karena memang bisa, tetapi apakah grafik visual adalah tempat yang tepat untuk pekerjaan yang perlu Anda ulangi.
Pembedaan itu membentuk setiap keputusan lain di halaman ini. ComfyUI memberi manfaat bagi eksperimen dan pipeline multimodal tempat narasi berdampingan dengan pembuatan gambar, video, dan audio. Alat suara khusus memberi manfaat bagi produksi berulang ketika Anda hanya membutuhkan voiceover yang bersih berulang kali. Di bawah ini, kami menguraikan cara kerja alur kerja, jenis opsi apa saja yang ada, cara menilainya, dan di mana sebuah grafik berhenti layak untuk pemeliharaannya.
Daftar isi
Apa sebenarnya ComfyUI text to speech itu
ComfyUI text to speech adalah praktik menggunakan grafik ComfyUI untuk mengubah teks tertulis menjadi keluaran AUDIO. Dokumentasi resmi menggambarkan ComfyUI sebagai aplikasi berbasis node open-source untuk membangun alur kerja di seluruh pembuatan gambar, video, audio, dan 3D, dan node audionya menghubungkan layanan atau model suara eksternal ke kanvas visual yang sama.
Grafik suara yang berfungsi berukuran kecil. Ia membutuhkan input teks atau prompt, node TTS, input suara atau audio referensi, pengaturan bahasa dan penyampaian opsional, serta node pratinjau atau penyimpanan audio. Node TTS mendorong naskah Anda melalui model suara dan mengembalikan audio yang dihasilkan yang dapat digunakan oleh node berikutnya.
Konsekuensi praktisnya adalah bahwa ComfyUI merupakan lapisan alur kerja, bukan modelnya. Suara sesungguhnya mungkin dihasilkan oleh penyedia yang di-hosting, model audio mitra, node kustom pihak ketiga, atau sistem yang dipasang secara lokal. Memahami pembagian itu adalah yang menjaga ekspektasi Anda tetap akurat: Anda sedang merakit sebuah pipeline, dan Anda tetap memilih mesin di dalamnya.
Cara kerja alur kerja empat tahap
Lepaskan nama-nama node dan setiap grafik suara ComfyUI melakukan empat hal yang sama secara berurutan.
Pertama, naskah tiba sebagai teks. Node TTS mungkin mengambil teks biasa secara langsung, atau teks mungkin mengalir masuk dari node lain yang memuat, menerjemahkan, atau menyegmentasi naskah yang lebih panjang. Membagi narasi panjang menjadi bagian-bagian logis memungkinkan Anda membuat ulang satu paragraf tanpa menyusun ulang seluruh voiceover, dan membantu Anda tetap di bawah batas input penyedia.
Kedua, alur kerja memilih suara dan model. Tergantung pada penyedia, itu bisa berupa pembicara preset, suara yang dikloning, ID suara, atau rekaman referensi. Pilihan model juga mengatur kecepatan, kualitas, rentang ekspresif, dan biaya. Node HeyGen milik ComfyUI, misalnya, mengekspos baik heygen-voice-1 maupun heygen-voice-1-turbo yang lebih cepat dan berbiaya lebih rendah, sementara node ElevenLabs menampilkan kontrol seperti stabilitas, kecepatan, dan gaya.
Ketiga, model suara mensintesis audio. Sistem neural modern memperkirakan pengucapan, ritme, jeda, dan pergerakan nada alih-alih menjahit kata-kata yang direkam sebelumnya, dan mereka mengembalikan bentuk gelombang yang dapat Anda arahkan selanjutnya: disimpan ke file, dicampur dengan musik, dimasukkan ke grafik video, atau dipasangkan dengan avatar.
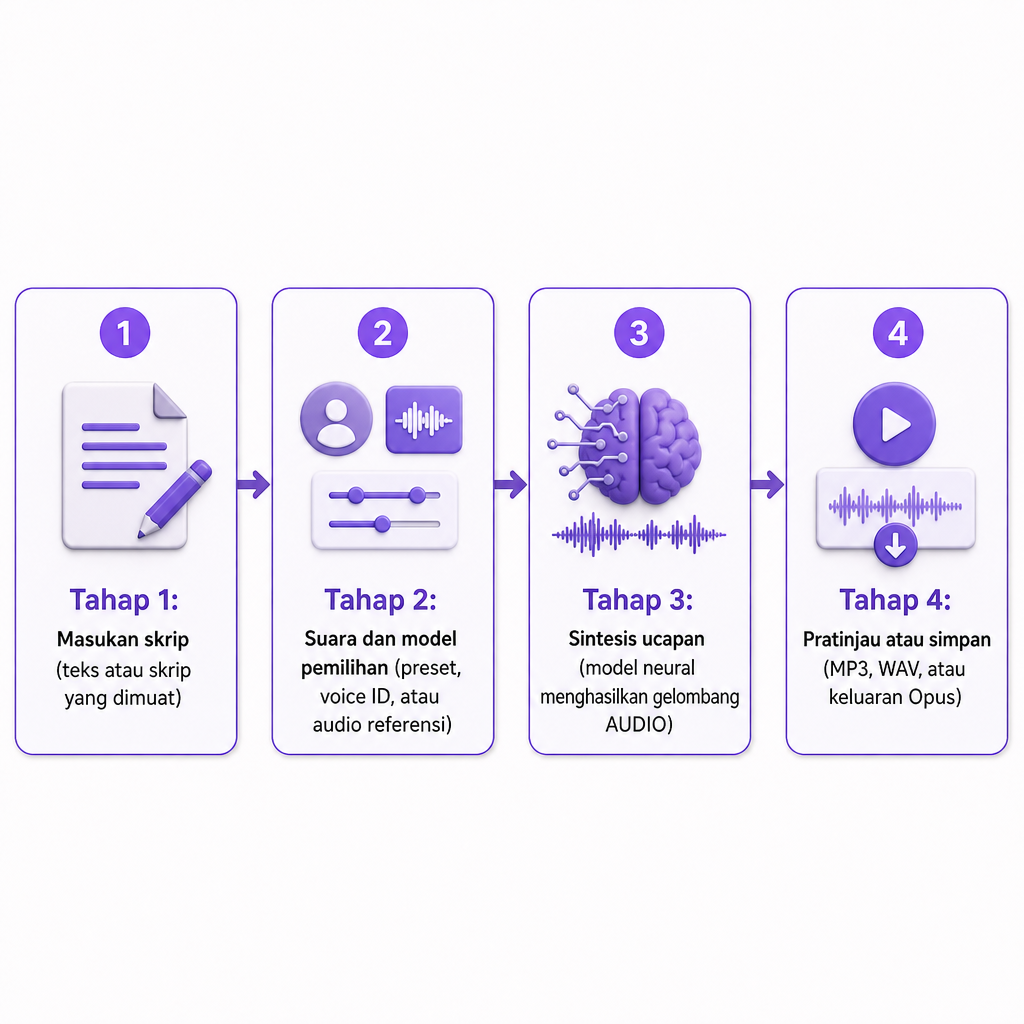
Keempat, audio dipratinjau atau disimpan. Node TTS biasanya menghasilkan objek AUDIO yang terhubung ke node pratinjau atau penyimpanan, dengan format file yang ditentukan oleh node dan penyedia; dokumentasi node ElevenLabs, misalnya, mencantumkan format yang dapat dipilih termasuk varian MP3 dan Opus. Karena grafiknya visual, loopnya mudah dijalankan ulang: ubah naskah, suara, bahasa, atau model, lalu antrikan lagi.
Tiga cara menjalankan TTS di ComfyUI
Tidak ada satu metode suara ComfyUI yang tunggal, dan perbedaannya bermuara pada pengaturan, kontrol, privasi, dan seberapa banyak pemeliharaan yang bersedia Anda tanggung.
Node penyedia yang di-hosting mengirimkan teks dan pengaturan suara Anda ke layanan eksternal dan mengembalikan audio yang sudah jadi. Ini biasanya jalur tercepat menuju suara berkualitas tinggi karena modelnya berjalan di infrastruktur penyedia. Node HeyGen Voice 1.0 menggambarkan polanya: ia membutuhkan ID suara kloning yang valid, mengirimkan teks dan ID ke HeyGen, dan mengembalikan suaranya. Trade-off-nya juga dapat diprediksi, karena akun atau koneksi API mungkin diperlukan, penggunaan dapat menghabiskan kredit penyedia, teks dan audio Anda diproses oleh pihak ketiga, dan batasan atau harga penyedia dapat berubah.
Node audio mitra resmi memperluas ide yang sama ke lebih banyak bagian ruang audio. Dokumentasi audio ComfyUI memisahkan pembuatan teks-ke-audio dari kasus penggunaan suara-dan-ucapan, termasuk ucapan dari teks dan dari audio referensi. Integrasi ini bersinar ketika grafik Anda sudah mengandalkan model media yang di-hosting lainnya, karena mereka mengurangi perpindahan file antar aplikasi terpisah.
Node TTS komunitas dan lokal menghubungkan ComfyUI ke sistem seperti Edge TTS, Kokoro, Index-TTS, dan model lain yang dapat berjalan secara lokal. Alur kerja lokal dapat memberi Anda lebih banyak kontrol atas data dan pilihan model Anda, tetapi meminta lebih banyak sebagai gantinya: instalasi, perangkat keras yang kompatibel, unduhan model, dan pemecahan masalah. Node lokal tidak otomatis lebih baik daripada yang di-hosting. Keunggulan sebenarnya bergantung pada apakah mesin Anda dapat menjalankan model secara efisien, apakah kualitas suaranya bertahan, apakah bahasa Anda didukung, apakah lisensinya mengizinkan penggunaan komersial, dan apakah Anda dapat menjaga alur kerjanya tetap hidup seiring waktu.
Kloning suara dan kontrol yang dapat Anda harapkan
Kloning suara menambahkan identitas referensi ke grafik alih-alih pembicara standar. Strukturnya biasanya terdiri dari dua bagian yang terhubung: node kloning yang membuat atau mengembalikan identitas suara, dan node TTS yang menggunakan identitas itu untuk mengucapkan teks baru. Dokumentasi HeyGen menggambarkannya secara langsung, di mana node Instant Clone menghasilkan voice_id yang mengaliri node Voice 1.0 Text to Speech; alur kerja kloning itu meminta setidaknya 10 detik ucapan yang jernih, dan node TTS menerima hingga 5.000 karakter per permintaan.
Kloning hanya dengan otorisasi. Jangan mereplikasi suara orang sungguhan hanya karena Anda dapat menjangkau sebuah rekaman. Dapatkan izin, simpan buktinya, dan ungkapkan ucapan sintetis atau yang dikloning di mana pun konteksnya dapat menyesatkan audiens.
Di luar suara itu sendiri, kontrol yang akan Anda temui bervariasi menurut node dan model, tetapi serangkaian yang familiar muncul berulang di sebagian besar darinya.
- Suara: identitas pembicara atau preset
- Bahasa: bahasa yang digunakan untuk menafsirkan naskah
- Kecepatan: seberapa cepat narasi disampaikan
- Nada: tinggi atau rendahnya suara yang dirasakan
- Gaya dan ekspresivitas: karakter penyampaian dan seberapa kuat emosi diterapkan
- Stabilitas: seberapa konsisten suara mempertahankan karakteristiknya
- Format keluaran: seperti MP3, WAV, atau Opus
- Audio referensi: rekaman yang digunakan untuk kloning atau transformasi suara
Beberapa model melangkah lebih jauh dengan isyarat inline. Dokumentasi node Fish Audio mendukung isyarat emosi dan tag dialog multi-pembicara dalam model yang didukung. Satu peringatan berlaku di seluruhnya: kontrol-kontrol ini tidak dapat dipertukarkan antar penyedia, dan pengaturan yang disebut gaya di satu node mungkin berperilaku sama sekali berbeda dari gaya di node lain.
ComfyUI versus platform TTS khusus
ComfyUI mendapatkan tempatnya ketika ucapan adalah satu bagian dari pipeline media yang lebih besar. Platform khusus cenderung menang ketika satu-satunya pekerjaan sebenarnya adalah mengubah naskah menjadi narasi yang dipoles tanpa menyusun sebuah grafik.
| Faktor keputusan | ComfyUI | Platform TTS khusus |
|---|---|---|
| Fleksibilitas alur kerja | Tinggi; hubungkan TTS ke node media lain | Biasanya berfokus pada produksi suara |
| Pengaturan | Mungkin membutuhkan node, tautan penyedia, atau pemasangan model | Sering lebih cepat untuk pembuatan pertama |
| Opsi suara | Bergantung pada node yang dipasang atau terhubung | Biasanya satu pustaka suara yang terorganisasi |
| Otomatisasi | Kuat untuk grafik visual yang dapat digunakan kembali | Sering melalui API atau alat batch |
| Pemrosesan lokal | Dimungkinkan dengan node dan model lokal | Biasanya berbasis cloud |
| Kasus penggunaan terbaik | Pipeline eksperimental atau multimodal | Narasi dan produksi yang berulang |
Bagi kreator yang membangun pipeline visual yang memadukan ucapan dengan gambar, video, atau pemrosesan audio, grafiknya membayar dirinya sendiri. Untuk narasi YouTube, voiceover e-learning, podcast, atau tim lokalisasi yang membutuhkan antarmuka yang dapat diprediksi, layanan khusus biasanya menghilangkan beban teknis. Alur kerja Text to Speech kami dibangun di sekitar pembuatan langsung dari naskah ke audio, dengan 300+ suara AI, kloning suara di 33 bahasa, laju ucapan yang dapat disesuaikan, isyarat dialog emosional, dan proyek yang dapat diunduh. Ketika pembuatan harus berada di dalam aplikasi atau pipeline konten otomatis, Text to Speech API kami menangani sisi integrasi, dan AI Dubbing API kami memperluas ide yang sama ke video yang diterjemahkan dan dicocokkan suaranya.
Cara memilih dan mengatasi masalah pengaturan Anda
Sebelum berkomitmen pada sebuah node atau model, jalankan beberapa pemeriksaan yang disengaja daripada memercayai demo singkat.
Nilai kualitas suara pada sampel yang sulit, bukan yang mudah. Hasilkan sebuah bagian yang mencakup nama, angka, akronim, kalimat panjang, pertanyaan, istilah merek, dan setidaknya satu baris emosional dalam bahasa dan aksen target Anda. Suara yang memikat Anda dalam satu kalimat singkat dapat merusak nama produk atau kehilangan ritme di sepanjang paragraf.
Periksa dukungan bahasa dan aksen per bahasa, bukan secara agregat. Beberapa sistem mendeteksi bahasa secara otomatis sementara yang lain mengharuskan Anda mengaturnya, dan dokumentasi node HeyGen merekomendasikan pengaturan bahasa secara manual untuk bahasa-bahasa yang sangat mirip di mana deteksi otomatis bisa tidak dapat diandalkan. Ingat bahwa suara yang fasih tidak dapat menyelamatkan terjemahan yang tidak akurat; kualitas suara dan kualitas terjemahan adalah masalah yang terpisah.
Ukur kontrol pengucapan untuk kata-kata yang sebenarnya membuat mesin tersandung: nama produk, kata benda, singkatan, tanggal, mata uang, dan kosakata teknis. Jika sebuah node tidak menawarkan kamus pengucapan atau kontrol bergaya SSML, rencanakan untuk menulis ulang teks secara fonetik atau mengeja angka. Untuk seri atau channel bermerek, uji juga konsistensi dengan menjalankan suara yang sama di beberapa pembuatan, nada, dan bagian yang dibuat ulang, karena jalannya ComfyUI yang terpisah untuk adegan berbeda dapat menyimpang.
Pertimbangkan latensi, biaya, privasi, dan hak secara bersama. Node yang di-hosting mulai cepat tetapi bergantung pada kecepatan jaringan, ketersediaan penyedia, batasan akun, dan harga per penggunaan, sementara model lokal menghindari biaya per permintaan tetapi menuntut perangkat keras dan pemeliharaan; bandingkan total biaya produksi, bukan tarif yang diiklankan. Tentang privasi, konfirmasikan bagaimana input disimpan, apakah konten melatih model, apakah data suara dapat dihapus, apakah penggunaan komersial diizinkan, siapa yang memiliki keluarannya, dan persetujuan apa yang diperlukan untuk suara yang dikloning.
Ketika sebuah grafik bermasalah, kegagalannya berkelompok menjadi daftar singkat. Node suara-kloning yang mengembalikan kesalahan sering memiliki voice_id yang kosong atau tidak valid; node HeyGen berhenti persis karena alasan itu. Naskah yang terlalu panjang mencapai batas, dan node HeyGen Voice 1.0 yang terdokumentasi menerima hingga 5.000 karakter sambil memperingatkan bahwa ucapan yang sangat panjang dapat gagal, terutama untuk teks Mandarin atau Jepang yang panjang, jadi bagilah narasi menjadi bagian-bagian logis. Pengucapan yang salah biasanya menanggapi penulisan ulang angka dalam kata, penambahan tanda baca, atau pengejaan akronim. Keluaran yang terlalu ekspresif membutuhkan ekspresivitas, gaya, atau variasi nada yang lebih rendah. Dan ketika audio tidak mau terhubung ke hilir, periksa tipenya, karena keluaran AUDIO tidak dapat mengaliri node yang mengharapkan gambar, video, atau teks tanpa langkah konversi. Terakhir, simpan grafik yang bersih dengan node yang dinamai dan pengaturan yang dicatat, karena penyedia, ID suara, bahasa, dan format keluaran yang Anda gunakan adalah detail yang akan dibutuhkan oleh Anda di masa depan.
Pertanyaan yang sering diajukan
Apakah ComfyUI adalah alat text-to-speech?
ComfyUI adalah aplikasi alur kerja berbasis node alih-alih satu mesin TTS tunggal. Ia dapat menghasilkan ucapan melalui node bawaan, integrasi mitra, dan node TTS komunitas atau lokal.
Dapatkah ComfyUI mengkloning suara?
Ya, jika integrasi atau node kustom yang dipilih mendukung kloning. Persyaratan rekaman yang tepat, proses ID suara, batasan, dan ketentuan komersial bergantung pada penyedia.
Apakah ComfyUI text to speech bekerja secara offline?
Bisa, ketika Anda menggunakan model TTS lokal yang kompatibel dan node lokal. Node penyedia yang di-hosting membutuhkan koneksi internet dan mungkin mengirim data teks atau suara ke penyedia.
Apa node TTS ComfyUI terbaik?
Tidak ada node terbaik yang universal. Pilih berdasarkan dukungan bahasa, kualitas suara, kebutuhan kloning, privasi, biaya, latensi, dan kompatibilitas dengan sisa alur kerja Anda.
Dapatkah saya menggunakan ComfyUI TTS untuk video YouTube?
Ya. Hasilkan narasinya, tinjau pengucapan dan hak, ekspor audionya, dan sinkronkan dengan video Anda. Jika Anda menggunakan suara yang dikloning atau sintetis, ikuti persyaratan persetujuan, pengungkapan, dan platform yang berlaku.