Une API de voix IA est la connexion programmable qui permet à votre application de créer, comprendre, transformer ou localiser de l'audio parlé à l'aide de modèles d'IA que vous n'avez pas à développer vous-même. Vous envoyez du texte, de l'audio ou de la vidéo à un point de terminaison et récupérez quelque chose d'utile : une narration synthétisée, une transcription, une voix personnalisée ou une vidéo entièrement doublée. La vraie question au départ n'est pas de savoir si vous avez besoin d'une « voix IA » — c'est de savoir quelle capacité vocale votre produit requiert réellement, car la génération de parole, la reconnaissance vocale, le clonage de voix et le doublage sont des produits distincts qui se trouvent partager un nom de catégorie.
Ce guide passe en revue ce que signifie le terme, les principaux types d'API et leurs différences, comment une requête traverse le pipeline, les critères de décision qui séparent un bon choix d'une erreur coûteuse, et les risques à gérer avant de vous lancer. C'est le point central de notre série développeurs et API, vous y trouverez donc des liens vers les guides d'intégration plus approfondis là où ils sont utiles.
Table des matières
Ce que signifie réellement « API de voix IA »
L'expression regroupe trois idées. La voix IA est l'intelligence artificielle qui travaille avec la parole humaine ou génère de la parole synthétique. L'API est une interface de programmation d'application — une manière définie pour deux systèmes logiciels d'échanger des requêtes et des réponses. La combinaison signifie que le traitement lourd du modèle se déroule du côté du fournisseur, tandis que votre application gère l'expérience utilisateur, vos règles métier et le contenu final.
Une requête peut être aussi simple qu'une courte charge utile JSON contenant le texte que vous voulez prononcer, un identifiant de voix et un code de langue. La réponse renvoie généralement un identifiant de projet, un statut de traitement et une URL vers l'audio généré une fois prêt. Pour la localisation vidéo, la requête fait plutôt référence à un fichier téléversé et à une liste de langues cibles.
Cette structure est ce qui distingue une API d'un générateur de voix basé sur navigateur. Une application web est conçue pour être utilisée manuellement par une personne, une tâche à la fois. Une API est conçue pour être appelée par un logiciel de manière répétée, automatique et à grande échelle. Si vous produisez une voix off occasionnelle, l'outil web est souvent plus rapide. Si vous localisez chaque vidéo que vous publiez, l'API prend tout son sens.
Les cinq principaux types d'API de voix IA
« API de voix IA » est une catégorie, pas une technologie unique. Les cinq types courants prennent des entrées différentes et renvoient des sorties différentes, et choisir le mauvais fait perdre du temps d'intégration. Le tableau ci-dessous les cartographie afin que vous puissiez faire correspondre votre matériau de départ au résultat souhaité.
| Type d'API | Entrée | Sortie | Usage typique |
|---|---|---|---|
| Synthèse vocale | Texte écrit | Audio de parole synthétique | Narration, accessibilité, invites d'application, formation |
| Reconnaissance vocale | Parole ou vidéo | Transcription écrite | Sous-titres, recherche, comptes-rendus de réunion, réutilisation |
| Clonage de voix | Échantillon vocal autorisé | Voix synthétique personnalisée | Voix de marque, présentateurs récurrents, narration multilingue |
| Doublage IA | Vidéo ou audio | Média traduit et doublé | Localisation YouTube, cours, films, podcasts |
| Parole à parole | Parole enregistrée | Parole transformée ou traduite | Conversion de voix, production multilingue |
La règle de sélection est simple. Si vous avez déjà un script, la synthèse vocale est généralement le chemin le plus simple. Si vous avez un enregistrement qui nécessite une transcription, vous avez besoin de la reconnaissance vocale. Si vous voulez la même identité de présentateur à travers plusieurs langues, le clonage de voix ou le doublage est plus approprié. Pour un exposé ciblé uniquement sur la synthèse vocale, notre guide complémentaire sur ce qu'est une API de synthèse vocale approfondit le pipeline de synthèse.
Une distinction importante : le clonage de voix n'est pas un modificateur de voix. Un modificateur de voix transforme une performance existante sur place, tandis que le clonage crée un modèle de voix réutilisable qui génère une nouvelle parole à partir de texte ou d'une autre entrée contrôlée.
Comment une requête traverse le pipeline
Les implémentations varient, mais la plupart des API de voix suivent les mêmes quatre étapes. Comprendre la forme du flux évite des heures de tâtonnement lorsqu'une requête renvoie un statut inattendu.
Premièrement, votre application s'authentifie. Elle envoie une clé API ou un jeton bearer dans l'en-tête de la requête. L'API TTS de DubSmart, par exemple, utilise un point de terminaison REST avec authentification par jeton bearer et des requêtes JSON contre l'URL de base https://dubsmart.ai/api/v1. Une règle plus importante qu'il n'y paraît : ne placez jamais de clé privée dans du JavaScript côté navigateur ou dans une application mobile distribuée. Stockez-la sur un serveur sécurisé et faites en sorte que votre client appelle ce serveur.
Deuxièmement, votre application envoie le contenu et les paramètres. Une requête transporte généralement un mélange de texte ou une référence de fichier, la langue source et cible, un ID de voix, la vitesse ou la hauteur, les informations sur le locuteur, les préférences de sortie et les métadonnées du projet. Pour une synthèse vocale simple, le contenu est du texte. Pour le doublage, l'API nécessite souvent d'abord un téléversement de vidéo, puis une requête séparée pour créer le projet.
Troisièmement, le service traite le contenu. Selon la tâche, cela peut signifier normaliser et interpréter le texte, prédire la prononciation et la prosodie, traduire le contenu parlé, séparer les locuteurs ou isoler la parole de l'audio de fond, générer de l'audio avec une voix standard ou personnalisée, et synchroniser le résultat sur une timeline vidéo. Les tâches plus longues s'exécutent de manière asynchrone : au lieu de renvoyer un fichier terminé, l'API renvoie un ID de projet.
Quatrièmement, votre application récupère le résultat — une URL audio ou vidéo, des URL de segments individuels, une transcription, du texte traduit, des données de synchronisation et des champs de statut ou d'erreur. L'API TTS de DubSmart documente les états de projet tels que pending, processing, completed et failed, et les projets terminés peuvent renvoyer des URL MP3 au niveau du projet ou du segment.
Synchrone versus asynchrone : la distinction qui façonne votre développement
La manière dont une API renvoie les résultats détermine comment vous concevez votre architecture autour d'elle, alors décidez-en avant d'écrire du code d'intégration.
Une API synchrone maintient la requête ouverte jusqu'à ce que le traitement se termine, puis renvoie le résultat. Cela fonctionne bien pour du texte court, de brèves invites vocales, de petits extraits audio et des fonctionnalités interactives à faible latence. Sa faiblesse est que les tâches longues peuvent dépasser les délais d'expiration de la requête.
Une API asynchrone renvoie immédiatement un ID de projet ou de tâche. Votre application interroge ensuite un point de terminaison de statut ou reçoit un webhook lorsque la tâche se termine. Ce modèle convient à la narration longue, au doublage vidéo, aux multiples langues cibles, à la génération par lots et aux fichiers volumineux. Les flux de travail TTS et de doublage documentés de DubSmart utilisent des états de projet et la récupération de résultats, ce qui est un modèle asynchrone conçu pour les tâches média.
Lorsque vous évaluez une option, vérifiez si elle prend en charge les webhooks. Interroger toutes les quelques secondes est trivial à implémenter, mais les webhooks réduisent les requêtes inutiles et passent mieux à l'échelle une fois que vous exécutez de nombreuses tâches en même temps.
Ce qu'il faut évaluer avant de vous engager
La bonne API dépend de la tâche, mais une poignée de critères s'appliquent à presque tous les projets. Passez-les en revue délibérément plutôt que de faire confiance à une courte démo.
Adéquation des capacités. Confirmez que l'API prend en charge la tâche exacte — synthèse vocale, reconnaissance vocale, clonage de voix, doublage, multiples locuteurs, sortie audio seule ou vidéo, temps réel ou par lots. Ne supposez pas que tout ce qui est commercialisé comme « voix IA » inclut toutes ces fonctions.
Couverture linguistique. Vérifiez les langues source et cible. « Prend en charge 30 langues » peut signifier 30 voix TTS, 30 cibles de traduction, ou un mélange de langues et de dialectes. Pour une chaîne multilingue, pesez aussi la qualité de l'accent, la prononciation des noms et des lieux, le vocabulaire régional, la disponibilité des voix par langue, et si une seule voix clonée fonctionne à travers les langues.
Prise en charge de la sortie et des médias. Vérifiez les formats audio, les conteneurs vidéo, la fréquence d'échantillonnage et le débit binaire, les téléchargements au niveau des segments, la vidéo rendue complète, la disponibilité des transcriptions ou des sous-titres, et la taille maximale de fichier. Ces éléments façonnent votre flux de travail d'édition et vos coûts de stockage.
Qualité et contrôlabilité. Écoutez les pauses naturelles, la prononciation correcte, le volume stable, l'identité cohérente du locuteur, l'emphase appropriée et la synchronisation précise. Une voix peut paraître impeccable dans un échantillon de dix secondes et trébucher sur des termes techniques, de longs paragraphes, des chiffres ou des noms inhabituels. Testez un contenu représentatif, pas l'extrait soigneusement choisi du fournisseur.
Latence et débit. Mesurez le temps par rapport à votre charge de travail réelle. Une courte voix off et des centaines de vidéos localisées sont des problèmes différents. Demandez si le traitement est en temps réel ou asynchrone, quelles sont les limites de débit, si les tâches s'exécutent en parallèle, s'il existe un traitement prioritaire, et comment les échecs sont relancés. DubSmart indique qu'une vidéo typique de cinq minutes prend environ une minute à traiter, en précisant que la durée dépend de la longueur et de la taille du fichier.
Modèle de tarification. Les API de voix peuvent facturer par caractères, mots, durée audio ou vidéo, crédits, requêtes, stockage ou tâches simultanées. Pour le doublage, le nombre de langues cibles multiplie le coût effectif. Calculez un flux de travail complet — relances, segments régénérés, relecture de traduction, stockage — pas seulement le premier appel. Notre analyse de la tarification des API de voix IA détaille le calcul des crédits.
Risques à gérer tôt
La voix IA introduit des modes de défaillance qui n'existent pas dans les outils média ordinaires. Les traiter dès la conception coûte bien moins cher qu'après une erreur publique.
Utilisation non autorisée de voix. Cloner la voix d'une personne sans permission crée une exposition juridique, éthique et réputationnelle. Utilisez un processus de consentement écrit qui précise qui possède l'enregistrement, ce qui peut être généré, où la voix peut être utilisée, si l'usage commercial est autorisé, comment la voix est supprimée, et ce qui se passe à la fin de l'accord.
Traduction ou prononciation incorrecte. La parole générée peut mal gérer les noms, acronymes, adresses et termes de l'industrie. Gardez une relecture humaine dans la boucle pour le contenu destiné au public : une lecture du script traduit, une écoute par un locuteur natif, des vérifications ponctuelles de prononciation, un contrôle de la synchronisation et du mouvement des lèvres, et une relecture finale du média exporté.
Usurpation d'identité et fraude. Les voix synthétiques peuvent être détournées pour des arnaques ou de fausses recommandations. Évitez de générer quoi que ce soit qui pourrait amener un auditeur raisonnable à croire qu'une personne réelle a dit quelque chose qu'elle n'a pas dit. Pour les communications sensibles, ajoutez une divulgation, des contrôles d'approbation et des journaux d'audit.
Confidentialité de la voix et des données. Les échantillons peuvent contenir des données personnelles. Avant le téléversement, réglez le consentement, les règles de conservation, les restrictions d'accès, les procédures de suppression, les conditions de traitement des données du fournisseur, et toute politique d'usage secondaire. DubSmart indique que les fichiers de clonage téléversés sont chiffrés et que les utilisateurs peuvent supprimer les voix personnalisées et les données audio associées, bien que les équipes devraient tout de même confirmer les conditions et contrôles actuels de leur forfait spécifique.
Changements de fournisseur et de modèle. Les ID de voix, la prise en charge des langues, les formats de sortie et les limites de débit peuvent évoluer. Traitez l'API comme une dépendance externe : fixez la configuration là où vous le pouvez, stockez les scripts source, sauvegardez l'audio approuvé, surveillez les taux d'erreur, gardez un flux de travail de secours, et effectuez de nouveaux tests après les mises à jour majeures du fournisseur. Pour les équipes qui veulent moins de pièces mobiles, notre récapitulatif des outils vidéo IA tout-en-un explique les compromis de la consolidation de ces capacités.
Quand une API l'emporte sur un flux de travail manuel
Une API de voix IA justifie son coût d'intégration lorsque vous avez besoin d'une production reproductible et programmatique. C'est un choix solide lorsqu'un créateur publie des versions localisées de chaque vidéo, qu'une petite entreprise génère une narration de produit dans plusieurs langues, qu'une société de e-learning met à jour des centaines de leçons, qu'un podcast diffuse des éditions traduites, qu'un produit logiciel ajoute une accessibilité parlée, ou qu'une agence intègre la génération de voix dans son système de gestion de contenu.
Un flux de travail de studio manuel peut encore l'emporter dans des cas spécifiques : lorsqu'un projet repose sur une performance humaine très nuancée, lorsque l'approbation juridique exige un acteur professionnel, lorsque le contenu comporte des affirmations sensibles, lorsqu'un enregistrement ponctuel est plus rapide que la création d'une intégration, ou lorsque le résultat nécessite une direction artistique poussée. Le but n'est pas de remplacer chaque voix humaine. C'est d'automatiser les parties où la cohérence, la rapidité, l'échelle ou la sortie multilingue comptent le plus.
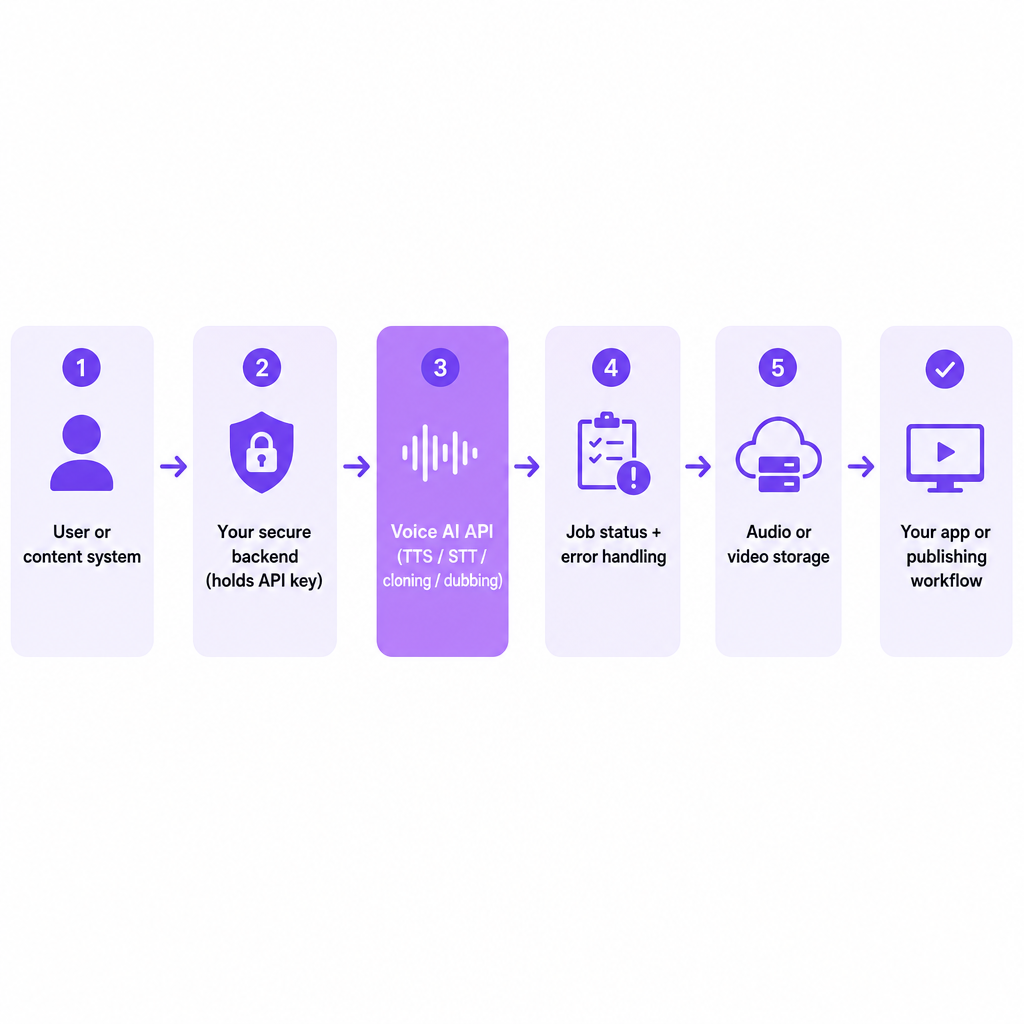
Pour un petit développement, gardez l'architecture simple. Un backend sécurisé se place entre votre utilisateur ou système de contenu et l'API de voix. Ce backend garde les identifiants privés, valide les entrées, crée les projets, stocke les ID de tâches, interroge le statut ou reçoit des webhooks, relance les échecs temporaires, sauvegarde les URL de résultats et les métadonnées, applique les limites d'usage, et enregistre le consentement pour toute voix clonée. Une version destinée aux créateurs pourrait accepter une vidéo anglaise terminée, l'envoyer à un point de terminaison de doublage pour les langues choisies, attendre la fin, acheminer les résultats vers un dossier de relecture, et publier uniquement après approbation.
La place de DubSmart
Nous intégrons plusieurs capacités d'API liées à la voix dans une seule plateforme média IA, ce qui compte le plus lorsque vous voulez connecter la génération et la localisation à un flux de travail existant plutôt que d'exécuter chaque tâche manuellement.
Notre API de synthèse vocale fournit une génération de parole programmatique avec des voix neuronales, du clonage de voix, un support multilingue, un suivi du statut des projets et des résultats MP3 — sa requête d'exemple utilise des segments de texte avec un ID de voix, une langue, une vitesse et une hauteur. Notre API de clonage de voix suit un schéma en trois étapes : demander une URL de téléversement présignée, téléverser un échantillon audio, puis créer une voix personnalisée à partir de la clé du fichier téléversé ; elle accepte MP3, WAV, AAC, M4A et FLAC, et nous recommandons au moins 20 secondes d'audio propre pour de meilleurs résultats. Notre API de doublage IA gère la localisation vidéo avec la création de projets multilingues, les paramètres de locuteur, les segments traduits et une sortie doublée téléchargeable, acceptant des entrées telles que MP4, MOV, AVI, MKV et WebM jusqu'à 5 Go.
Si vous vous demandez par quel point de terminaison commencer, faites-le correspondre à votre contenu : une narration scriptée oriente vers la synthèse vocale, une voix récurrente autorisée oriente vers le clonage, et une vidéo multilingue oriente vers le doublage.
Questions fréquentes
Qu'est-ce qu'une API de voix IA en termes simples ?
C'est une connexion qui permet à un logiciel de générer, reconnaître, cloner, traduire ou transformer la parole sans construire son propre système de voix IA. Votre application envoie une requête et reçoit de l'audio, du texte ou de la vidéo traité.
Une API de voix IA est-elle la même chose que la synthèse vocale ?
Non. La synthèse vocale est un type d'API de voix IA. La catégorie inclut aussi la reconnaissance vocale, le clonage de voix, le doublage et les fonctions de parole à parole.
Ai-je besoin d'une expérience en programmation pour en utiliser une ?
Généralement un peu, car les API impliquent l'authentification, les requêtes HTTP, le JSON, les téléversements de fichiers et la gestion des statuts. Pour des tâches manuelles occasionnelles, une application web sans code est souvent plus facile.
Une API de voix IA peut-elle traduire une vidéo YouTube ?
Une API de doublage peut traduire et générer un nouvel audio pour une vidéo lorsqu'elle prend en charge les langues source et cible requises, le format de fichier et le flux de travail de sortie. Relisez le résultat avant de publier.
Puis-je cloner la voix de n'importe quelle personne ?
Techniquement possible n'est pas la même chose que légalement ou éthiquement autorisé. Ne clonez une voix qu'avec une permission appropriée, et suivez les règles du fournisseur, vos contrats, et les exigences applicables en matière de confidentialité et de droit à l'image.