La façon la plus rapide de transcrire une vidéo en texte est de laisser un outil de reconnaissance vocale par IA faire la première passe : téléverser le fichier vidéo ou coller un lien YouTube, laisser le système convertir l'audio parlé en une transcription modifiable, puis relire les parties les plus susceptibles d'être erronées. Cette dernière étape compte plus que la plupart des gens ne le pensent, car « rapide » devrait signifier une transcription de première passe rapide plus un bref contrôle qualité, et non une perfection instantanée. La saisie manuelle, en revanche, implique de s'arrêter, de rembobiner et de retaper chaque ligne, ce qui est là où les heures s'envolent.
Si vous voulez la version pratique de la façon de transcrire une vidéo en texte, notre flux de travail Reconnaissance Vocale accepte les téléversements de vidéos et les liens YouTube, vous permet de modifier le projet obtenu, prend en charge plus de 60 langues et gère des fichiers jusqu'à 5 Go sans limite de durée vidéo indiquée. Le reste de ce guide explique le mécanisme derrière cela, comment choisir la bonne sortie et comment maintenir une précision élevée lorsque l'audio pose problème.
Table des matières
Ce que signifie réellement transcrire une vidéo en texte
La transcription vidéo convertit l'audio parlé à l'intérieur d'une vidéo en mots écrits. Cette seule sortie peut servir à de nombreuses tâches : une transcription vidéo complète, des sous-titres ou des sous-titres codés, un script de montage, un brouillon de blog ou de newsletter, des archives consultables de réunions et de cours, ou un texte source que vous traduisez ensuite pour de nouveaux publics.
Il est utile de distinguer trois termes souvent confondus. La transcription conserve la langue parlée d'origine sous forme de texte. La traduction convertit ce contenu dans une autre langue. Le doublage remplace ou ajoute de l'audio parlé dans une langue différente. On transcrit d'abord, puis on décide si la traduction ou le doublage est la prochaine étape. Si vous voulez la définition plus approfondie de la technologie de reconnaissance derrière tout cela, notre guide sur le fonctionnement de la reconnaissance vocale couvre les bases.
Comment fonctionne la transcription vidéo par IA en coulisses
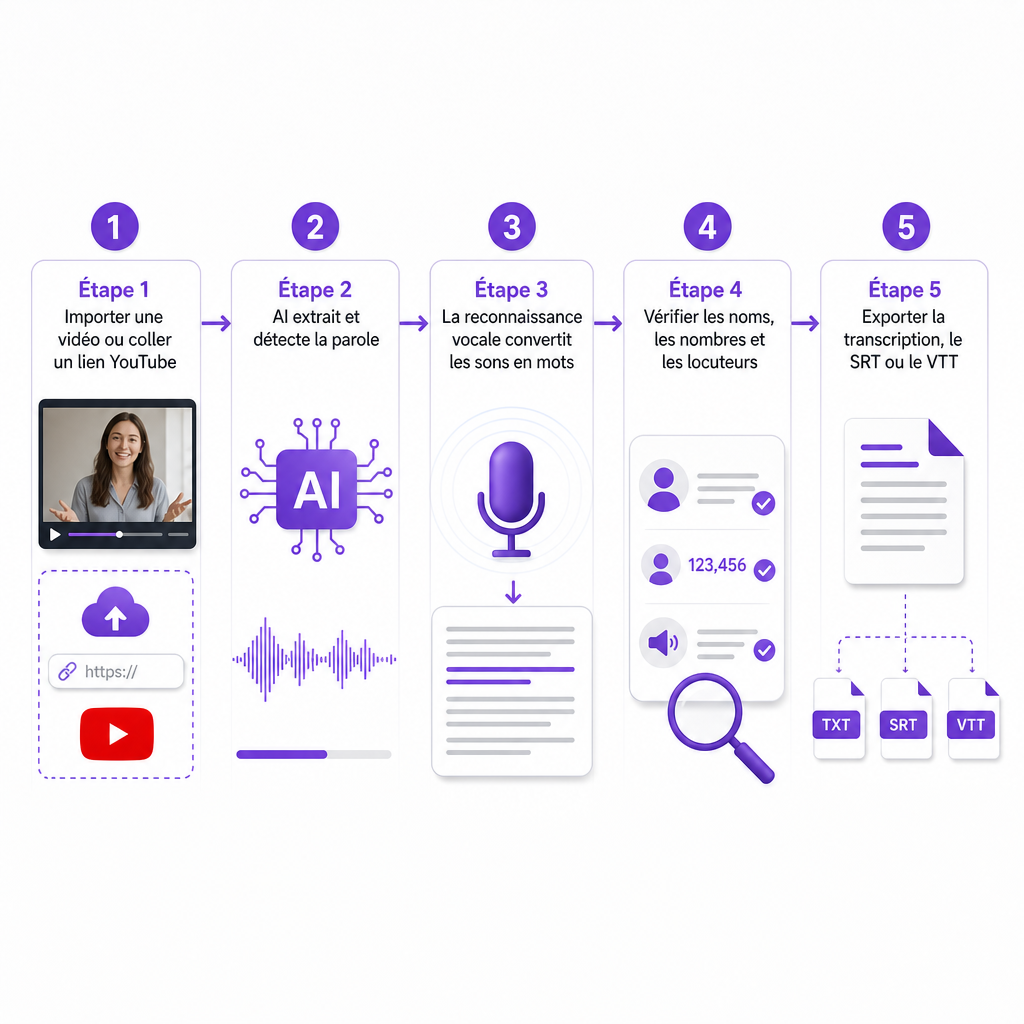
Connaître le pipeline vous aide à prédire d'où viennent les erreurs. La plupart des systèmes de transcription automatique passent par les mêmes étapes. D'abord, le système lit la piste audio à l'intérieur de la vidéo. Ensuite, il détecte quelles sections contiennent réellement de la parole. Un modèle de reconnaissance associe alors les motifs sonores à des mots, et une étape de traitement du langage utilise le contexte environnant pour améliorer ces prédictions. Les mots reconnus sont assemblés en phrases ou en segments chronométrés, et enfin vous corrigez et exportez le résultat.
Le modèle de reconnaissance n'est qu'une partie de l'équation de la qualité. La qualité du microphone, les locuteurs qui se chevauchent, les accents, la musique de fond, l'écho de la pièce, le vocabulaire technique et les interruptions façonnent tous la sortie. Notre système de Reconnaissance Vocale est conçu pour gérer les environnements bruyants, les locuteurs multiples et différentes langues et dialectes, avec la réserve honnête que la précision varie selon la qualité audio et la diversité des accents. Cette réserve est la raison pour laquelle la passe de relecture existe, plutôt qu'un défaut à cacher.
Transcription, sous-titres pour sourds ou sous-titres : choisir la bonne sortie
Le meilleur format d'exportation dépend entièrement de l'usage prévu du texte, et un mauvais choix fait perdre du temps par la suite.
Une transcription simple est un texte lisible sans synchronisation requise. Privilégiez-la lorsque vous avez besoin de notes de recherche, de comptes rendus de réunion, d'un script vidéo, d'un brouillon de blog ou de newsletter, ou de contenu à réutiliser. Les horodatages sont facultatifs ici, bien qu'ils aident les monteurs à se déplacer dans le texte.
Les sous-titres codés synchronisent le texte avec la vidéo et peuvent transmettre des informations non verbales pertinentes telles que la musique, les applaudissements ou une porte qui se ferme. Ils sont importants pour l'accessibilité et pour quiconque regarde sans le son. Les sous-titres affichent généralement les dialogues parlés pour les spectateurs qui ne comprennent pas la langue. Lorsque vous avez besoin de sous-titres dans une autre langue, transcrivez d'abord l'original, puis traduisez et synchronisez le texte traduit.
Pour les formats chronométrés, WebVTT est une norme web pour les pistes de texte synchronisées ; la spécification W3C WebVTT le décrit comme un format pour les sous-titres codés, les sous-titres, les chapitres, les descriptions et d'autres métadonnées synchronisées avec l'audio ou la vidéo. Pour les téléversements sur YouTube, SubRip .srt et .vtt font tous deux partie des formats de sous-titres pris en charge, et YouTube précise que les fichiers .srt de base doivent utiliser un encodage UTF-8 simple.
Nettoyer l'audio avant de transcrire une vidéo bruyante
Le bruit de fond est l'une des causes les plus courantes d'erreurs de transcription. Les bruits de rue, la climatisation, le retour de microphone, la musique concurrente et l'écho de la pièce brouillent tous les frontières entre les mots, et le modèle de reconnaissance dispose de moins de signal pour travailler.
La solution consiste à isoler la parole avant la transcription. Notre Séparateur Vocal supprime le bruit de fond et sépare les mots parlés de l'audio environnant, prenant en charge les principaux formats tels que MP3, WAV et AAC ainsi que les fichiers vidéo. Il mérite sa place dans le flux de travail pour les interviews enregistrées en extérieur, les podcasts captés dans des pièces non traitées acoustiquement, les vidéos avec une forte musique de fond, les tables rondes avec des niveaux de microphone inégaux et les séquences d'archives comportant du ronflement ou du bruit ambiant.
Une mise en garde pour le travail d'accessibilité : ne supprimez pas tous les sons par réflexe. Si un bruit a un sens, comme une sirène, une alarme ou une annonce au haut-parleur, il peut encore être nécessaire de le représenter dans les sous-titres codés, même s'il est exclu de la piste vocale nettoyée que vous envoyez pour transcription.
Comment améliorer la précision de la transcription
Considérez la transcription par IA comme un solide premier jet, puis appliquez des contrôles ciblés au lieu de tout relire aveuglément.
Commencez avec le fichier source le plus clair. Téléversez l'enregistrement original plutôt qu'un téléchargement compressé issu des réseaux sociaux, car un signal vocal plus propre donne plus de matière au modèle. Réduisez l'audio concurrent en baissant ou en supprimant la musique de fond, et utilisez la piste vocale la plus propre disponible si la vidéo en possède plusieurs. Sélectionnez la langue ou le dialecte qui correspond à l'enregistrement lorsque l'option existe, ce qui aide le système à interpréter la prononciation, l'orthographe et la structure des phrases.
Attaquez-vous ensuite aux points de défaillance prévisibles. Recherchez dans la transcription les noms propres tels que les noms, les marques, les lieux, les termes de produits et le jargon plutôt que de faire confiance à une lecture générale. Relisez les changements de locuteur, et ajoutez manuellement des étiquettes de locuteur lorsque la transcription sera utilisée à des fins juridiques, éducatives, de recherche ou éditoriales. Vérifiez les éléments courts et cruciaux pour le sens : dates, prix, pourcentages, mesures, URL, acronymes, négations comme « ne... pas », et les mots qui se ressemblent, car un seul faux pas peut inverser une phrase.
La méthode la plus fiable consiste à lire la vidéo tout en suivant la transcription. Pour un long enregistrement, allez d'abord aux sections comportant des noms, des chiffres, un audio peu clair ou des voix qui se chevauchent. Cela reflète une mise en garde à intérioriser : les sous-titres automatiques peuvent déformer la parole à cause des erreurs de prononciation, des accents, des dialectes et du bruit de fond.
Adapter le flux de travail à votre type de contenu
Différents formats sollicitent différentes parties du processus, alors ajustez l'endroit où vous consacrez du temps à la relecture.
Pour les vidéos YouTube, une transcription alimente les sous-titres, les descriptions, les chapitres, la sélection d'extraits et la réutilisation axée sur la recherche ; utilisez le fichier original téléversé ou une source de haute qualité lorsque vous possédez la vidéo. Les interviews et podcasts nécessitent généralement des étiquettes de locuteur et une meilleure gestion du bruit, alors nettoyez d'abord l'audio d'environnements chargés et maintenez l'identité des locuteurs cohérente. Les vidéos de formation en ligne et d'apprentissage doivent privilégier la précision des instructions, de la terminologie, des chiffres et des références à l'écran, avec des sous-titres synchronisés d'assez près pour que les apprenants suivent l'explication et l'écran ensemble.
Les réunions professionnelles se transforment en comptes rendus consultables et en points d'action, mais les conversations sensibles exigent un soin particulier : vérifiez les noms, les décisions, les dates et les responsabilités attribuées avant de partager. Les vidéos courtes pour les réseaux sociaux convertissent souvent la transcription en sous-titres à l'écran, en description de publication ou en versions traduites, alors gardez des retours à la ligne courts pour le mobile et assurez-vous que les sous-titres ne recouvrent pas de visuels importants.
Comment choisir un outil de vidéo vers texte
Évaluez l'ensemble du flux de travail, pas seulement un chiffre de précision affiché. Le tableau ci-dessous présente les critères qui modifient réellement votre délai d'exécution et la qualité de la sortie.
| Critère de décision | Ce qu'il faut vérifier |
|---|---|
| Prise en charge des entrées | Accepte-t-il votre vidéo, votre audio ou une URL YouTube ? |
| Limites de fichiers | Quelle est la taille de fichier et la durée vidéo maximales ? |
| Couverture linguistique | Prend-il en charge votre langue, votre dialecte et vos accents ? |
| Gestion des locuteurs | Pouvez-vous identifier ou séparer plusieurs locuteurs ? |
| Formats de sortie | Pouvez-vous exporter en texte brut, SRT ou VTT ? |
| Intégration | Existe-t-il une API pour traiter des vidéos à grande échelle ? |
Notre page publique Reconnaissance Vocale confirme l'entrée par vidéo et par lien YouTube, les projets modifiables, les téléchargements, la prise en charge de plus de 60 langues et une limite de taille de 5 Go. Nous ne précisons pas sur cette page si chaque sortie inclut des horodatages, combien de temps les fichiers sont conservés, ou si l'identification des locuteurs est automatique, alors confirmez ces détails pour votre propre flux de travail avant de confier du contenu sensible ou volumineux. Si l'une de ces réponses est décisive pour vous, indiquez-nous votre type de fichier, votre langue, votre nombre de locuteurs et la sortie souhaitée, et nous pourrons vous orienter vers la bonne configuration.
Confidentialité, droits et une norme de relecture raisonnable
Une transcription peut contenir des informations commerciales confidentielles, des données personnelles, des conversations avec des clients, du contenu inédit ou du matériel protégé par le droit d'auteur. Avant de téléverser, confirmez que vous avez la permission de traiter l'enregistrement, que tout consentement requis des locuteurs existe, et si la vidéo contient des informations confidentielles ou réglementées. Vérifiez comment un fournisseur stocke et supprime les fichiers téléversés et les transcriptions générées, qui peut accéder au projet et aux exportations, et si les fichiers peuvent être utilisés pour l'entraînement de modèles. Rappelez-vous que transcrire un enregistrement protégé par le droit d'auteur est techniquement facile mais ne confère pas la permission d'en redistribuer le contenu ; vous avez toujours besoin des droits pour publier la source, la transcription, les sous-titres ou les traductions.
Calibrez la profondeur de la relecture selon les enjeux. Une relecture légère convient aux clips pour les réseaux sociaux, aux notes internes et aux ébauches : repérez les erreurs évidentes, les noms, les chiffres et les phrases manquantes. Une relecture complète convient aux cours, aux sous-titres publics, aux interviews, aux dossiers clients, au matériel juridique et à tout ce qui est publié : écoutez l'enregistrement complet, corrigez la formulation, vérifiez les étiquettes de locuteur, contrôlez les horodatages et confirmez que les sous-titres respectent les règles de format de la plateforme de destination. Pour l'accessibilité, relisez au-delà du dialogue, car des effets sonores importants, des changements de locuteur et des indices significatifs peuvent nécessiter d'être représentés dans les sous-titres codés.
Le chemin efficace est le même à chaque fois : commencez avec la vidéo la plus propre dont vous disposez, isolez la parole lorsque l'audio est difficile, générez une transcription modifiable, vérifiez les noms et les chiffres, et exportez le format requis par votre plateforme. Pour les équipes travaillant dans plusieurs langues, cette transcription est aussi le point de départ naturel pour la traduction et le doublage ultérieurs.
Foire aux questions
Quelle est la façon la plus rapide de transcrire une vidéo en texte ?
Utilisez un outil de reconnaissance vocale automatique qui accepte directement la vidéo ou prend en charge un lien YouTube. Téléversez la source la plus claire, sélectionnez la bonne langue, générez la transcription, puis relisez d'abord les sections les plus sujettes aux erreurs.
Puis-je transcrire une vidéo sans saisie manuelle ?
Oui. Les outils de reconnaissance vocale par IA convertissent automatiquement l'audio parlé en texte modifiable. Vous devez tout de même relire la sortie, car la précision peut varier selon le bruit, les accents, les chevauchements de parole et le vocabulaire spécialisé.
DubSmart peut-il transcrire une longue vidéo ?
Oui. Notre outil de Reconnaissance Vocale accepte l'audio ou la vidéo téléversés ainsi que les liens YouTube, prend en charge l'édition et vous permet de télécharger le projet terminé. Nous indiquons une prise en charge de plus de 60 langues et une limite de fichier de 5 Go, sans limite de durée vidéo indiquée ; le temps de traitement réel varie selon le fichier et l'audio.
Que dois-je faire si la transcription comporte de nombreuses erreurs ?
Améliorez d'abord l'audio source. Supprimez le bruit concurrent avec un outil de séparation vocale, confirmez la langue sélectionnée, puis régénérez ou modifiez la transcription, en portant une attention particulière aux noms propres, aux chiffres, aux accents et aux locuteurs qui se chevauchent.
Quel format de sous-titres dois-je utiliser ?
Utilisez le format requis par votre plateforme. Le SRT est largement pris en charge, tandis que le WebVTT est un format de texte chronométré orienté web, et YouTube prend en charge les deux parmi ses formats de sous-titres.