La réponse honnête à la question de la quantité d'audio nécessaire pour cloner une voix est plus courte que la plupart des gens ne le pensent : avec DubSmart AI, vous avez besoin d'au moins 20 secondes d'enregistrement propre d'un seul locuteur. Ce minimum permet d'obtenir un clone utilisable, mais il ne raconte que rarement toute l'histoire. La durée que vous devriez réellement enregistrer dépend de l'endroit où la voix sera utilisée — un simple clip pour les réseaux sociaux, un narrateur récurrent de chaîne, une bibliothèque de cours multilingue, ou un porte-parole de marque qui doit sembler identique à travers des dizaines de vidéos. Ci-dessous, nous distinguons le minimum strict de l'objectif pratique, expliquons ce que le modèle écoute réellement, et vous donnons une règle de décision à appliquer avant d'appuyer sur enregistrer.
Table des matières
Le minimum face à l'objectif pratique
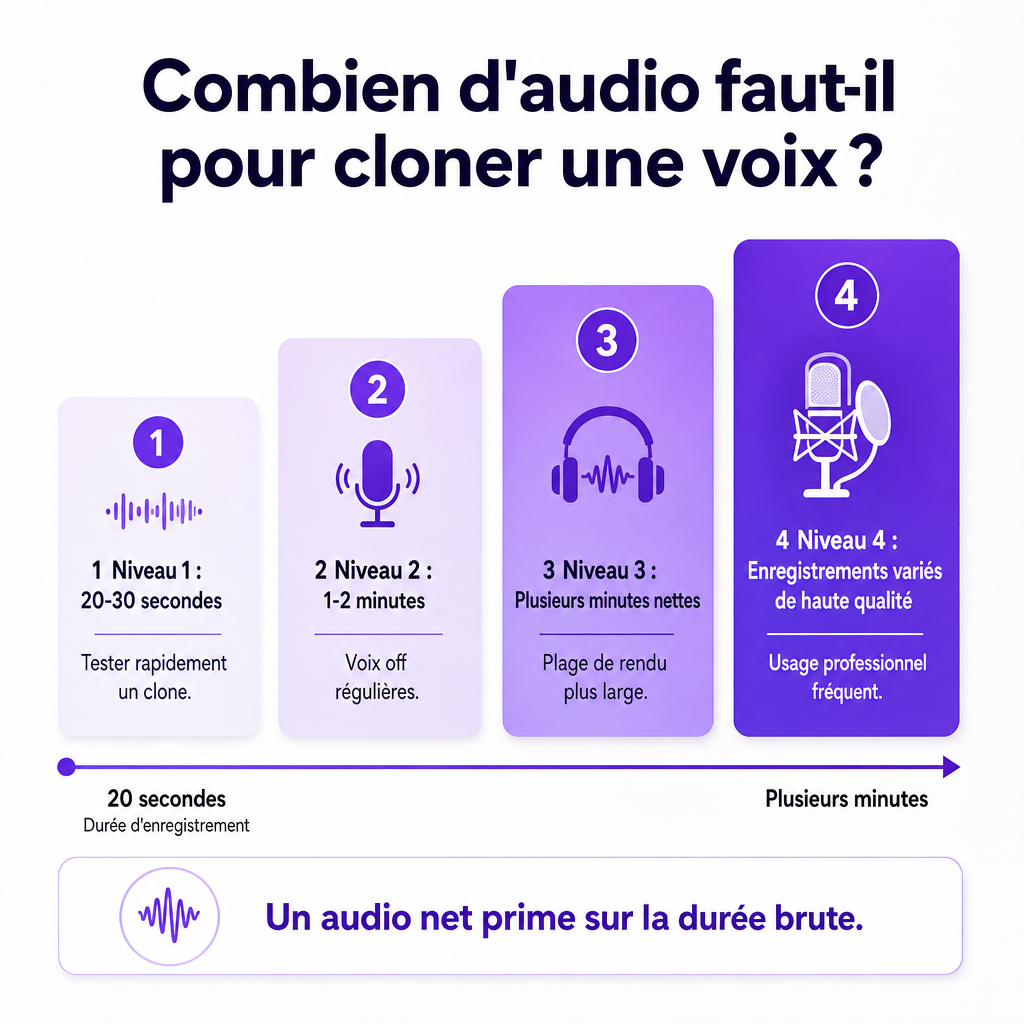
Vingt secondes constituent le plancher, pas la ligne d'arrivée. Un échantillon de durée minimale capture l'identité de base d'un locuteur, ce qui est souvent suffisant pour un test rapide ou un clip ponctuel. Mais la quantité de matériel que vous fournissez au modèle façonne directement la manière dont le clone gère des scripts variés. Le bon objectif évolue selon l'exigence et la répétition de la production.
| Votre objectif | Objectif audio pratique |
|---|---|
| Tester un clone rapidement | 20 à 30 secondes |
| Créer des voix off régulières | 1 à 2 minutes |
| Capturer une plage de diction plus large | Plusieurs minutes propres |
| Construire une voix pour un usage professionnel fréquent | Des enregistrements plus variés et de haute qualité |
Le principe qui sous-tend tout ce tableau est sans détour : un audio propre et cohérent vaut généralement plus qu'un enregistrement plus long rempli de bruit, d'écho, de musique ou de plusieurs locuteurs. Un clip soigné de 30 secondes peut surpasser un clip désordonné de 10 minutes. Si vous voulez comprendre plus largement comment un échantillon devient une voix réutilisable, notre article explicatif sur comment le clonage vocal recrée une voix couvre l'ensemble du processus.
Ce que signifie réellement « suffisamment d'audio »
« Suffisamment » n'est pas vraiment un chiffre au chronomètre — c'est la question de savoir si le modèle dispose d'assez de parole utile pour reconstruire la voix que vous souhaitez. Lorsque vous clonez une voix, l'IA analyse l'enregistrement pour identifier un ensemble de caractéristiques, puis les utilise pour générer une nouvelle parole à partir d'un texte ou d'un dialogue traduit.
Ces caractéristiques comprennent :
- Le ton et le timbre vocaux
- La hauteur et le rythme de parole
- La prononciation et l'accent
- Les pauses et la cadence
- L'énergie, l'emphase et la diction émotionnelle
Un échantillon court fixe l'identité fondamentale du locuteur. Un échantillon plus long et plus varié ajoute des informations sur la manière dont cette personne sonne lorsqu'elle explique, questionne, insiste, fait une pause ou change de ton émotionnel. Le véritable objectif est donc un audio représentatif : du matériel qui montre au modèle la voix en train de faire les choses qu'on lui demandera plus tard.
Quand enregistrer plus de 20 secondes
Dépassez le minimum chaque fois que la voix clonée apparaîtra de façon répétée, représentera une marque ou portera du contenu de format long. Pour ces cas, un point de départ pratique est une à deux minutes de parole propre, avec davantage si vous avez besoin que la voix reproduise une plage plus large de styles de diction.
Les échantillons plus longs sont payants pour les travaux riches en narration : vidéos YouTube, podcasts, cours en ligne, formations d'entreprise, contenu de type livre audio, explications de produits, doublage multilingue, dialogues de personnages et campagnes marketing répétées. Un créateur qui n'enregistre qu'une introduction calme a tendance à obtenir un clone qui fonctionne le mieux dans ce seul registre calme. Un créateur qui enregistre des explications, des questions, des emphases et des pauses naturelles fournit au modèle bien plus d'exemples de la voix en action. Le but n'est jamais de déverser le maximum de minutes — c'est de fournir un audio qui représente la façon dont la voix se comporte réellement.
Pourquoi un audio propre vaut mieux qu'un audio long
Davantage d'audio n'aide que lorsque le matériel supplémentaire est de haute qualité et pertinent. Un enregistrement de 10 minutes avec de l'écho de pièce, du cliquetis de clavier, de la musique de fond, des microphones changeants ou plusieurs locuteurs peut être moins utile qu'un clip court et propre. Un bruit plus fort reste du bruit, donc augmenter le gain ne sauve jamais un mauvais échantillon.
L'audio supplémentaire mérite sa place lorsqu'il est :
- Clairement prononcé par une seule personne
- Cohérent en volume et en distance du microphone
- Exempt de musique, d'effets sonores et de voix qui se chevauchent
- Enregistré dans un environnement calme et à faible écho
- Prononcé à un rythme naturel
- Représentatif du style que vous souhaitez générer
Quelques habitudes d'enregistrement protègent la qualité plus que n'importe quel objectif de durée. Gardez un seul locuteur dans le clip ; d'autres voix perturbent l'analyse. Privilégiez une petite pièce meublée plutôt qu'une grande pièce vide pour réduire les réflexions, et maintenez une distance constante du micro tout au long. N'enregistrez pas une section de près et une autre depuis l'autre bout de la pièce, et évitez de remplir le fichier de longs silences ou d'audio sans rapport. Si votre seule source est une vidéo bruyante, nettoyez-la d'abord plutôt que d'espérer que la durée compense — notre guide sur la suppression de la musique de fond de l'audio détaille ce nettoyage.
Ce que votre échantillon devrait réellement dire
Le contenu compte autant que la condition. L'enregistrement devrait contenir une parole claire et naturelle plutôt que des sons isolés ou des phrases fortement découpées. Un bon échantillon mélange phrases courtes et longues, une gamme de sons de voyelles et de consonnes, des nombres et des dates, des noms et des termes courants, des questions, des affirmations emphatiques et des pauses naturelles — idéalement dans le même type de langage que celui qu'utilisera le contenu final.
Ce à quoi cela ressemble en pratique varie selon le créateur. Un YouTubeur pourrait enregistrer une courte introduction, une explication, un appel à l'action et quelques phrases à différents niveaux d'emphase. Un producteur d'e-learning pourrait inclure des formulations pédagogiques, des définitions, des listes et des transitions. Un porte-parole d'entreprise bénéficie d'intégrer la terminologie de marque et le style conversationnel utilisé dans le contenu destiné aux clients. Se demander si vous avez même besoin d'un clone ici est une question légitime ; notre analyse voix clonée vs voix TTS de bibliothèque vous aide lorsqu'une voix de bibliothèque ferait le travail plus rapidement.
Clonage multilingue et audio source bruité
Pour les projets multilingues, l'exigence de départ reste la qualité de l'échantillon vocal d'origine. Traduire la parole générée dans d'autres langues n'élimine pas le besoin d'un enregistrement source clair — un clip anglais brouillon produit un clone brouillon dans chaque langue cible.
Lorsque vous prévoyez de localiser, prêtez attention à la clarté de la voix d'origine, à la prononciation des noms et des termes de marque, au ton visé dans chaque langue, à la question de savoir si le style du locuteur doit rester formel, amical, énergique ou conversationnel, et à la question de savoir si les scripts traduits ont été relus avant le doublage. Pour un projet de localisation plus important, testez une courte section dans chaque langue cible avant de traiter la vidéo complète ; cela fait apparaître tôt les problèmes de prononciation, de rythme et d'adaptation culturelle. Le flux de travail AI Dubbing de DubSmart peut utiliser une voix clonée pour le contenu traduit, et les voix clonées peuvent être utilisées à la fois dans la synthèse vocale (Text to Speech) et l'AI Dubbing.
La qualité de la source est l'autre moitié de ce problème. Vous pouvez souvent extraire la parole d'une vidéo, mais la musique de fond, les effets sonores, l'ambiance de la pièce, le vent, le bruit du public, la parole qui se chevauche et les artefacts de compression font tous d'un clip un mauvais point de départ. Si la source est précieuse mais bruitée, isolez d'abord la parole. Notre Séparateur de parole extrait une piste vocale des autres éléments audio, et plus cette piste est propre, plus le clone est fiable.
Consentement et droit de cloner une voix
Vous ne pouvez cloner la voix d'une autre personne que lorsque vous disposez de l'autorisation et des droits appropriés. Le clonage vocal comporte de réels risques juridiques, éthiques, de confidentialité et d'usurpation d'identité, alors avant de téléverser l'enregistrement de quelqu'un d'autre, obtenez son consentement éclairé et confirmez comment la voix peut être utilisée, distribuée et conservée. Les règles du Voice Cloning Challenge de la Federal Trade Commission des États-Unis exigeaient des participants qu'ils ne clonent des voix qu'avec le consentement de la personne dont la voix était clonée.
Pour un travail commercial, documentez qui possède ou contrôle la voix, quels enregistrements peuvent être utilisés, quels types de contenu et quelles langues sont autorisés, si l'usage commercial est permis, combien de temps dure l'autorisation, si la personne peut la retirer, et comment le contenu synthétique sera divulgué le cas échéant. Ne clonez pas une personnalité publique, un employé, un client, un acteur ou un membre de votre famille simplement parce que vous pouvez accéder à un enregistrement de leur voix. L'accès n'est pas une autorisation.
Combien enregistrer selon le type de créateur
Le même minimum s'applique à tout le monde, mais l'objectif pratique évolue avec le risque de production. Utilisez le minimum lorsque la vitesse compte — tests créatifs précoces, clips de format court, prototypes internes, annonces simples — et enregistrez davantage chaque fois que la voix doit rester cohérente à travers de nombreuses vidéos ou langues.
| Créateur | Échantillon recommandé |
|---|---|
| Créateurs YouTube | 20 s pour tester ; 1 à 2 minutes propres et expressives pour un narrateur récurrent |
| Petite entreprise / marketing | Clip de porte-parole cohérent avec la terminologie et l'énergie de la campagne ; testez d'abord une courte voix off |
| E-learning / formation | Échantillon plus long et varié couvrant définitions, instructions, questions, transitions |
| Podcasteurs | Échantillon reflétant le rythme normal de l'animateur ; vérifiez la prononciation des noms et des sponsors |
| Cinéastes | Échantillon correspondant à la direction du personnage, y compris chuchotement, intensité ou autres qualités dramatiques |
| Développeurs / agences | Une norme audio reproductible appliquée avant d'accepter les échantillons clients |
Deux notes pratiques sous-tendent ce tableau. Un échantillon neutre ne reproduira pas une performance qui dépend du chuchotement, de l'ironie ou de la peur, donc les cinéastes devraient capturer le personnage, pas seulement la voix. Et pour les pipelines pilotés par API, une norme d'admission fixe empêche des résultats incohérents d'un client à l'autre ; notre API de clonage vocal crée des voix personnalisées à partir d'échantillons audio et les rend disponibles pour la synthèse vocale (Text to Speech) et l'AI Dubbing.
Une courte vérification avant le téléversement rend les résultats prévisibles. Confirmez que l'échantillon dure au moins 20 secondes, présente un seul locuteur, ne contient ni musique ni voix qui se chevauchent, comporte un minimum d'écho et de bruit de fond, maintient une position et un niveau de micro constants, contient une parole naturelle plutôt que de longs silences, correspond au style visé, et provient d'un locuteur qui a consenti à l'usage prévu.
Utilisez 20 secondes pour tester le concept, une à deux minutes pour une narration quotidienne fiable, et un audio propre plus varié lorsque la voix doit performer de façon cohérente à travers du contenu de format long ou multilingue.
Le minimum vous permet de démarrer. La qualité de l'enregistrement, la cohérence du locuteur, la plage expressive et l'autorisation décident si le résultat est prêt à être publié.
Questions fréquemment posées
De combien d'audio avez-vous besoin pour cloner une voix ?
Avec DubSmart, vous avez besoin d'au moins 20 secondes d'audio. Pour une meilleure couverture de la diction du locuteur, visez une à deux minutes de parole propre et naturelle.
10 secondes suffisent-elles pour cloner une voix ?
Cela peut suffire pour certains systèmes, mais c'est en dessous du minimum indiqué par DubSmart. Téléversez au moins 20 secondes pour un clone DubSmart.
Une minute suffit-elle pour le clonage vocal ?
Souvent oui, pour une narration quotidienne, à condition qu'elle soit propre, cohérente et prononcée naturellement. Un échantillon plus large et plus varié aide pour un usage expressif ou professionnel.
Un enregistrement plus long rend-il le clone plus précis ?
Pas automatiquement. La durée supplémentaire n'aide que lorsqu'elle ajoute des exemples propres et pertinents de la voix. Le bruit, l'écho, la musique et plusieurs locuteurs réduisent la valeur de l'audio ajouté.
Ai-je besoin d'une autorisation pour cloner une voix ?
Oui. Obtenez le consentement et confirmez les droits applicables avant de cloner la voix d'une autre personne, en couvrant l'usage prévu, la distribution et l'activité commerciale. Les règles du challenge de clonage vocal de la FTC exigeaient également le consentement de la personne dont la voix était clonée.
Puis-je utiliser un clone vocal pour l'AI dubbing ?
Oui. Les voix créées peuvent être utilisées à la fois dans la synthèse vocale (Text to Speech) et l'AI Dubbing.