Si vous avez atterri sur comfyui text to speech en espérant trouver un seul bouton qui transforme un script en audio, la première chose à savoir est que ComfyUI n'est pas du tout un moteur vocal. C'est un espace de travail basé sur des nœuds où vous reliez le texte, une voix, un modèle, une langue et une sortie audio dans un graphe réutilisable. La parole elle-même provient de n'importe quel nœud TTS que vous connectez : un fournisseur hébergé, une intégration de partenaire officiel ou un modèle local que vous installez vous-même. La question qui compte réellement n'est donc pas de savoir si ComfyUI peut lire votre script à voix haute, car c'est le cas, mais si un graphe visuel est le bon endroit pour le travail que vous devez répéter.
Cette distinction façonne toutes les autres décisions de cette page. ComfyUI récompense l'expérimentation et les pipelines multimodaux où la narration côtoie la génération d'images, de vidéos et d'audio. Un outil vocal dédié récompense une production répétable où vous avez simplement besoin de voix off propres encore et encore. Ci-dessous, nous détaillons le fonctionnement du flux de travail, les types d'options disponibles, comment les évaluer et le moment où un graphe cesse de valoir la maintenance qu'il exige.
Table des matières
Ce qu'est réellement ComfyUI text to speech
ComfyUI text to speech consiste à utiliser un graphe ComfyUI pour convertir du texte écrit en une sortie AUDIO. La documentation officielle décrit ComfyUI comme une application open source basée sur des nœuds pour construire des flux de travail couvrant la génération d'images, de vidéos, d'audio et de contenus 3D, et ses nœuds audio connectent des services ou des modèles vocaux externes à ce même canevas visuel.
Un graphe vocal fonctionnel est petit. Il lui faut une entrée de texte ou de prompt, un nœud TTS, une entrée de voix ou d'audio de référence, des réglages facultatifs de langue et de diction, et un nœud d'aperçu ou de sauvegarde audio. Le nœud TTS fait passer votre script à travers un modèle vocal et renvoie l'audio généré que les nœuds suivants peuvent utiliser.
La conséquence pratique est que ComfyUI est la couche du flux de travail, pas le modèle. La voix réelle peut être produite par un fournisseur hébergé, un modèle audio partenaire, un nœud personnalisé tiers ou un système installé localement. Comprendre cette séparation permet de garder des attentes justes : vous assemblez un pipeline, et vous choisissez toujours le moteur à l'intérieur.
Comment fonctionne le flux de travail en quatre étapes
Mettez de côté les noms de nœuds et chaque graphe vocal ComfyUI fait les mêmes quatre choses en séquence.
D'abord, le script arrive sous forme de texte. Le nœud TTS peut prendre directement du texte brut, ou le texte peut provenir d'un autre nœud qui charge, traduit ou segmente un script plus long. Découper une longue narration en sections logiques vous permet de régénérer un paragraphe sans reconstruire toute la voix off, et cela vous aide à rester sous le plafond d'entrée d'un fournisseur.
Ensuite, le flux de travail sélectionne une voix et un modèle. Selon le fournisseur, cela peut être un locuteur prédéfini, une voix clonée, un identifiant de voix ou un enregistrement de référence. Le choix du modèle gouverne aussi la vitesse, la qualité, la gamme expressive et le coût. Le nœud HeyGen de ComfyUI, par exemple, propose à la fois heygen-voice-1 et une version plus rapide et moins coûteuse heygen-voice-1-turbo, tandis que le nœud ElevenLabs met en avant des contrôles tels que la stabilité, la vitesse et le style.
Troisièmement, le modèle vocal synthétise l'audio. Les systèmes neuronaux modernes estiment la prononciation, le rythme, les pauses et les variations de hauteur plutôt que d'assembler des mots préenregistrés, et ils renvoient une forme d'onde que vous pouvez acheminer ensuite : enregistrée dans un fichier, mixée avec de la musique, insérée dans un graphe vidéo ou associée à un avatar.
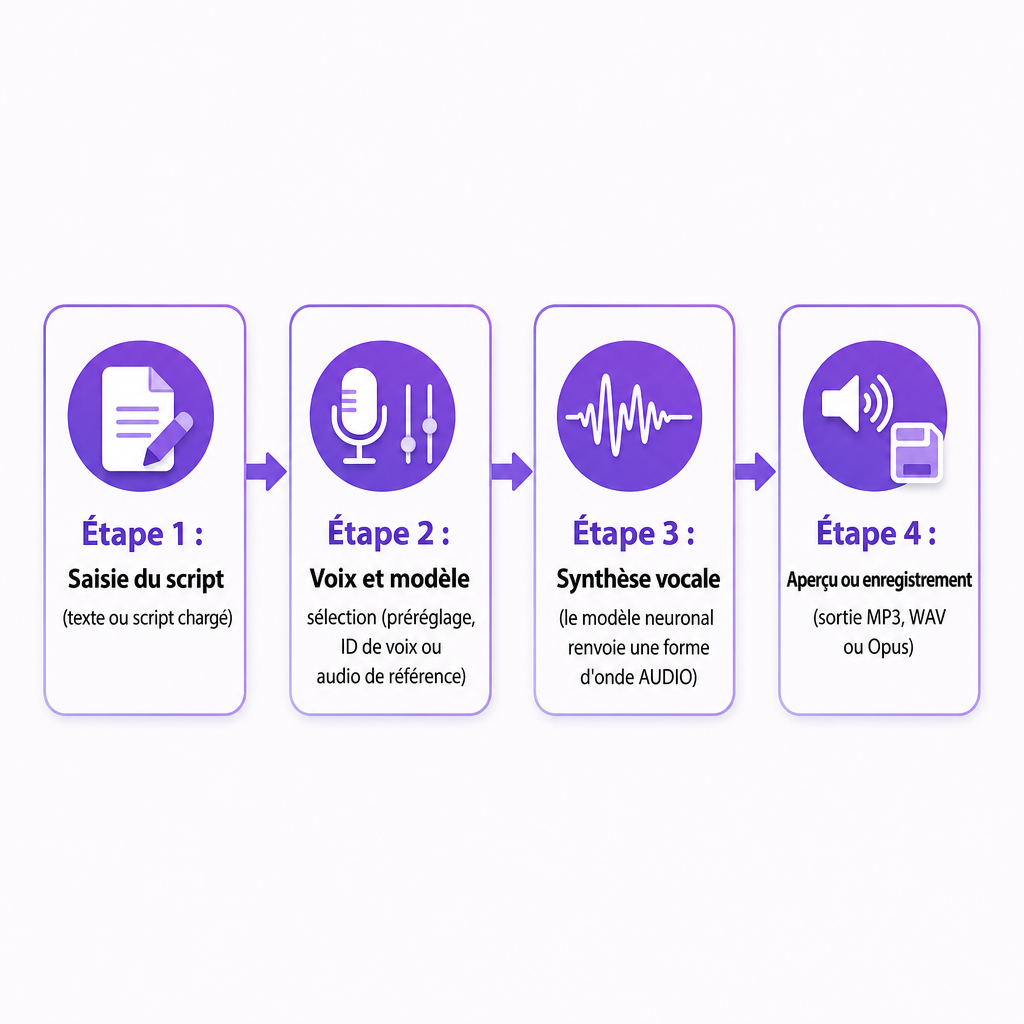
Quatrièmement, l'audio est prévisualisé ou sauvegardé. Les nœuds TTS émettent généralement un objet AUDIO qui se connecte à un nœud d'aperçu ou de sauvegarde, le format de fichier étant défini par le nœud et le fournisseur ; la documentation du nœud ElevenLabs, par exemple, répertorie des formats sélectionnables, dont le MP3 et des variantes Opus. Parce que le graphe est visuel, la boucle est facile à relancer : changez le script, la voix, la langue ou le modèle, puis mettez-le à nouveau en file d'attente.
Les trois façons d'exécuter le TTS dans ComfyUI
Il n'existe pas de méthode vocale unique dans ComfyUI, et les différences se résument à la configuration, au contrôle, à la confidentialité et à la quantité de maintenance que vous êtes prêt à assumer.
Les nœuds de fournisseurs hébergés envoient votre texte et vos réglages vocaux à un service externe et renvoient l'audio fini. C'est généralement le chemin le plus rapide vers une voix de haute qualité, car le modèle s'exécute sur l'infrastructure du fournisseur. Le nœud HeyGen Voice 1.0 illustre ce schéma : il nécessite un identifiant de voix clonée valide, envoie le texte et l'identifiant à HeyGen et renvoie la parole. Les compromis sont également prévisibles, car un compte ou une connexion API peut être requis, l'utilisation peut consommer des crédits du fournisseur, votre texte et votre audio sont traités par un tiers, et les limites ou les tarifs du fournisseur peuvent changer.
Les nœuds audio de partenaires officiels étendent la même idée à une plus grande partie de l'espace audio. La documentation audio de ComfyUI distingue la génération de texte vers audio des cas d'usage vocaux et de parole, y compris la parole à partir de texte et à partir d'audio de référence. Ces intégrations brillent lorsque votre graphe repose déjà sur d'autres modèles médias hébergés, car elles réduisent le transfert de fichiers entre applications distinctes.
Les nœuds TTS communautaires et locaux connectent ComfyUI à des systèmes tels que Edge TTS, Kokoro, Index-TTS et d'autres modèles qui peuvent s'exécuter localement. Les flux de travail locaux peuvent vous donner plus de contrôle sur vos données et votre choix de modèle, mais ils exigent davantage en retour : installation, matériel compatible, téléchargements de modèles et dépannage. Un nœud local n'est pas automatiquement meilleur qu'un nœud hébergé. Son véritable avantage dépend de la capacité de votre machine à exécuter le modèle efficacement, de la qualité de la voix, de la prise en charge de votre langue, de la licence autorisant un usage commercial, et de votre capacité à maintenir le flux de travail en vie au fil du temps.
Le clonage vocal et les contrôles auxquels vous pouvez vous attendre
Le clonage vocal ajoute une identité de référence au graphe au lieu d'un locuteur standard. La structure comprend généralement deux parties connectées : un nœud de clonage qui crée ou renvoie une identité vocale, et un nœud TTS qui utilise cette identité pour prononcer un nouveau texte. La documentation HeyGen le décrit directement, où un nœud Instant Clone produit un voice_id qui alimente le nœud Voice 1.0 Text to Speech ; ce flux de travail de clonage demande au moins 10 secondes de parole claire, et le nœud TTS accepte jusqu'à 5 000 caractères par requête.
Ne clonez qu'avec autorisation. Ne reproduisez pas la voix d'une personne réelle simplement parce que vous avez accès à un enregistrement. Obtenez une permission, conservez-en la preuve, et signalez toute parole synthétique ou clonée partout où le contexte pourrait induire un public en erreur.
Au-delà de la voix elle-même, les contrôles que vous rencontrerez varient selon le nœud et le modèle, mais un ensemble familier revient dans la plupart d'entre eux.
- Voix : l'identité du locuteur ou le préréglage
- Langue : la langue utilisée pour interpréter le script
- Vitesse : la rapidité avec laquelle la narration est prononcée
- Hauteur : le caractère plus ou moins aigu ou grave de la voix
- Style et expressivité : le caractère de la diction et l'intensité avec laquelle l'émotion est appliquée
- Stabilité : la constance avec laquelle la voix conserve ses caractéristiques
- Format de sortie : tel que MP3, WAV ou Opus
- Audio de référence : un enregistrement utilisé pour le clonage ou la transformation de la parole
Certains modèles vont plus loin avec des indications en ligne. La documentation du nœud Fish Audio prend en charge les indications d'émotion et les balises de dialogue multi-locuteurs dans les modèles compatibles. Une mise en garde s'applique à tous : ces contrôles ne sont pas interchangeables entre les fournisseurs, et un réglage appelé style dans un nœud peut se comporter très différemment du style dans un autre.
ComfyUI face à une plateforme TTS dédiée
ComfyUI mérite sa place lorsque la parole fait partie d'un pipeline média plus vaste. Une plateforme dédiée tend à l'emporter lorsque la seule vraie tâche consiste à transformer des scripts en narration soignée sans assembler de graphe.
| Facteur de décision | ComfyUI | Plateforme TTS dédiée |
|---|---|---|
| Flexibilité du flux de travail | Élevée ; connectez le TTS à d'autres nœuds média | Généralement axée sur la production vocale |
| Configuration | Peut nécessiter des nœuds, des liens de fournisseur ou des installations de modèles | Souvent plus rapide pour la première génération |
| Options vocales | Dépend des nœuds installés ou connectés | Généralement une bibliothèque de voix organisée |
| Automatisation | Puissante pour les graphes visuels réutilisables | Souvent via API ou outils de traitement par lots |
| Traitement local | Possible avec des nœuds et modèles locaux | Généralement basée sur le cloud |
| Meilleur cas d'usage | Pipelines expérimentaux ou multimodaux | Narration et production répétables |
Pour les créateurs construisant un pipeline visuel qui mêle la parole aux images, à la vidéo ou au traitement audio, le graphe est rentable. Pour la narration YouTube, les voix off d'e-learning, les podcasts ou les équipes de localisation qui ont besoin d'une interface prévisible, un service spécialisé élimine généralement la charge technique. Notre flux de travail Text to Speech est conçu autour de la génération directe de script vers audio, avec plus de 300 voix IA, le clonage vocal dans 33 langues, un débit de parole ajustable, des indications de dialogue émotionnel et des projets téléchargeables. Lorsque la génération doit vivre à l'intérieur d'une application ou d'un pipeline de contenu automatisé, notre Text to Speech API gère le volet intégration, et notre AI Dubbing API étend la même idée à la vidéo traduite et synchronisée vocalement.
Comment choisir et dépanner votre configuration
Avant de vous engager sur un nœud ou un modèle, effectuez quelques vérifications délibérées plutôt que de vous fier à une courte démo.
Jugez la qualité de la voix sur un échantillon difficile, pas sur un échantillon facile. Générez un passage qui inclut des noms, des chiffres, des acronymes, de longues phrases, des questions, des termes de marque et au moins une réplique émotionnelle dans votre langue et votre accent cibles. Une voix qui vous séduit dans une phrase courte peut écorcher un nom de produit ou perdre le rythme au fil d'un paragraphe.
Vérifiez la prise en charge de la langue et de l'accent langue par langue, et non dans l'ensemble. Certains systèmes détectent la langue automatiquement tandis que d'autres exigent que vous la définissiez, et la documentation du nœud HeyGen recommande de définir la langue manuellement pour les langues proches où la détection automatique peut être peu fiable. Rappelez-vous qu'une voix fluide ne peut pas sauver une traduction inexacte ; la qualité de la voix et la qualité de la traduction sont des problèmes distincts.
Mesurez le contrôle de la prononciation pour les mots qui font réellement trébucher les moteurs : noms de produits, noms propres, abréviations, dates, devises et vocabulaire technique. Si un nœud n'offre aucun dictionnaire de prononciation ni de contrôles de type SSML, prévoyez de réécrire le texte phonétiquement ou d'écrire les chiffres en toutes lettres. Pour une série ou une chaîne de marque, testez aussi la cohérence en utilisant la même voix sur plusieurs générations, tonalités et sections régénérées, car des exécutions ComfyUI distinctes pour différentes scènes peuvent dériver.
Pesez ensemble la latence, le coût, la confidentialité et les droits. Les nœuds hébergés démarrent rapidement mais dépendent de la vitesse du réseau, de la disponibilité du fournisseur, des limites de compte et de la tarification à l'usage, tandis que les modèles locaux évitent les frais par requête mais exigent du matériel et de l'entretien ; comparez le coût total de production, pas le tarif affiché. En matière de confidentialité, vérifiez comment l'entrée est stockée, si le contenu entraîne le modèle, si les données vocales peuvent être supprimées, si l'usage commercial est autorisé, qui détient la sortie, et quel consentement les voix clonées exigent.
Lorsqu'un graphe se comporte mal, les défaillances se regroupent en une courte liste. Un nœud de voix clonée qui renvoie une erreur a souvent un voice_id vide ou invalide ; le nœud HeyGen s'arrête précisément pour cette raison. Les scripts trop longs atteignent les limites, et le nœud documenté HeyGen Voice 1.0 accepte jusqu'à 5 000 caractères tout en avertissant qu'une parole très longue peut échouer, en particulier pour un texte chinois ou japonais étendu, donc divisez la narration en sections logiques. Une mauvaise prononciation se corrige généralement en réécrivant les chiffres en mots, en ajoutant de la ponctuation ou en épelant les acronymes. Une sortie trop expressive appelle une expressivité, un style ou une variation de hauteur réduits. Et lorsque l'audio refuse de se connecter en aval, vérifiez le type, car une sortie AUDIO ne peut pas alimenter un nœud attendant une image, une vidéo ou du texte sans une étape de conversion. Enfin, enregistrez un graphe propre avec des nœuds nommés et des réglages consignés, car le fournisseur, l'identifiant de voix, la langue et le format de sortie que vous avez utilisés sont les détails dont le vous futur aura besoin.
Foire aux questions
ComfyUI est-il un outil de synthèse vocale ?
ComfyUI est une application de flux de travail basée sur des nœuds plutôt qu'un unique moteur TTS. Il peut générer de la parole via des nœuds intégrés, des intégrations de partenaires et des nœuds TTS communautaires ou locaux.
ComfyUI peut-il cloner une voix ?
Oui, si l'intégration ou le nœud personnalisé sélectionné prend en charge le clonage. Les exigences exactes d'enregistrement, le processus d'identifiant de voix, les limites et les conditions commerciales dépendent du fournisseur.
ComfyUI text to speech fonctionne-t-il hors ligne ?
C'est possible lorsque vous utilisez un modèle TTS local compatible et des nœuds locaux. Les nœuds de fournisseurs hébergés nécessitent une connexion Internet et peuvent envoyer du texte ou des données vocales au fournisseur.
Quel est le meilleur nœud TTS pour ComfyUI ?
Il n'existe pas de meilleur nœud universel. Choisissez en fonction de la prise en charge des langues, de la qualité vocale, des besoins de clonage, de la confidentialité, du coût, de la latence et de la compatibilité avec le reste de votre flux de travail.
Puis-je utiliser le TTS de ComfyUI pour des vidéos YouTube ?
Oui. Générez la narration, vérifiez la prononciation et les droits, exportez l'audio, et synchronisez-le avec votre vidéo. Si vous utilisez une voix clonée ou synthétique, respectez les exigences applicables en matière de consentement, de divulgation et de plateforme.