Una voz de texto a voz tipo «wiseguy» (chulo/socarrón) es habla generada por IA diseñada para sonar como un narrador ingenioso, seguro y ligeramente bromista que puedes reutilizar en vídeos, anuncios y contenido de formación. No es una tecnología aparte. Es un estilo de locución que construyes sobre el texto a voz (TTS) común y la clonación de voz: escribes un guion, eliges o creas una voz con esa actitud pícara y callejera, y generas audio que mantiene la misma personalidad de un contenido al siguiente. Con DubSmart AI, ese personaje socarrón puede provenir de una voz predefinida de nuestra biblioteca o de una voz personalizada que clones a partir de tus propias grabaciones.
Esa distinción importa más que la etiqueta. La palabra «wiseguy» describe un tono, no un botón. Todo lo que hace reconocible a la voz proviene de tres palancas que tú controlas: la voz que eliges, cómo escribes el guion y cómo ajustas la interpretación. Esta guía explica en qué consiste realmente el estilo, cómo lo produce nuestro texto a voz, las tres maneras prácticas de utilizarlo y cuándo un narrador desenfadado ayuda frente a cuándo te cuesta discretamente la confianza.
Tabla de contenidos
¿Es una voz socarrona adecuada para tu proyecto?
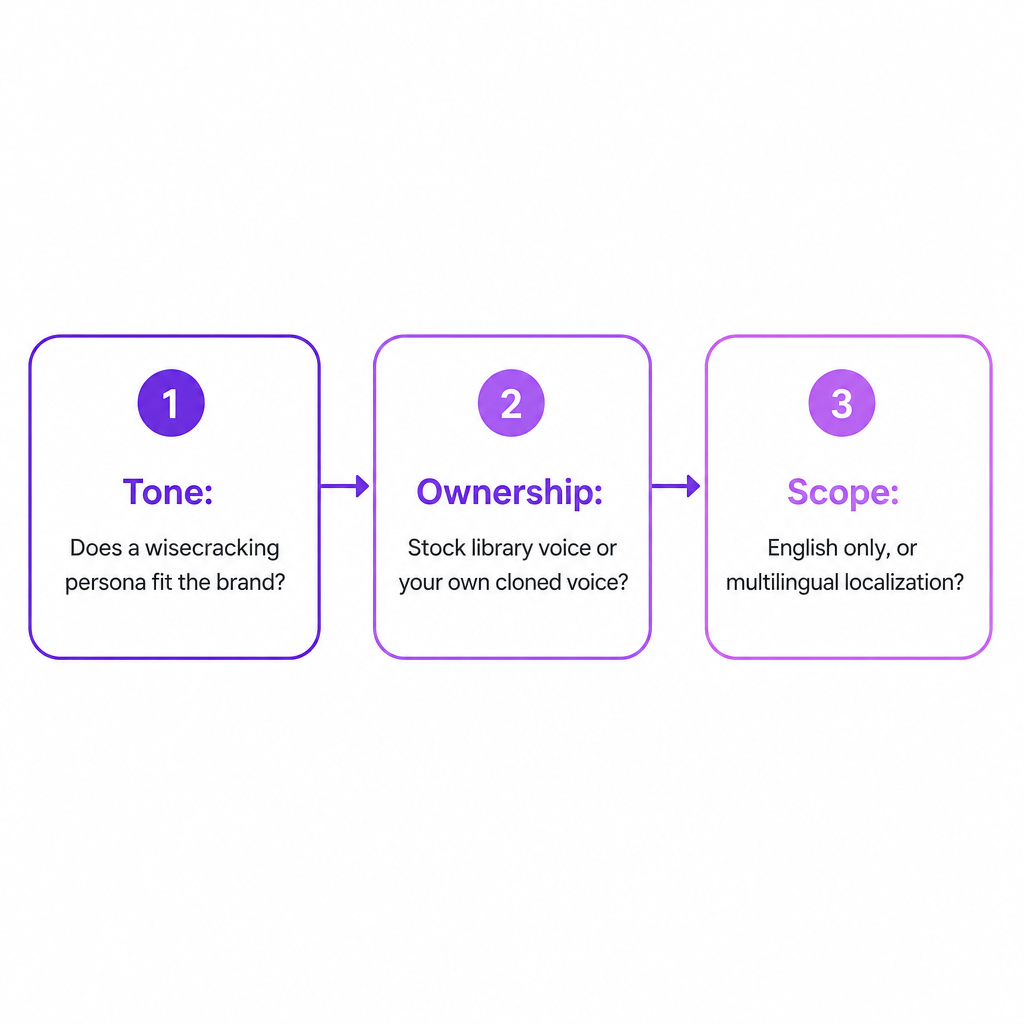
Antes de buscar una voz, resuelve tres preguntas, porque deciden todo lo que viene después.
La primera es el tono. Un personaje ingenioso y bromista puede hacer que el entretenimiento, el contenido de creadores y las explicaciones informales resulten más atractivos. También puede socavar la credibilidad en materiales serios. Si tu contenido se enmarca en salud, finanzas, RR. HH., ámbito legal o cumplimiento normativo, un narrador sabelotodo juega en tu contra.
La segunda es la propiedad. ¿Quieres un personaje de IA genérico que cualquier otra persona también podría seleccionar, o una voz que sea inconfundiblemente tuya? Una voz predefinida se despliega más rápido; una voz clonada te da una identidad vocal que ningún competidor puede tomar del mismo estante.
La tercera es el alcance. Si hoy solo necesitas locución en inglés, una única elección de voz te cubre. Si planeas expandirte a otros idiomas, querrás un personaje que pueda viajar, lo cual te empuja hacia una plataforma que maneje salida multilingüe sin obligarte a cambiar de herramienta.
Cuando las respuestas honestas son «nuestra marca es desenfadada», «queremos un sonido distintivo» y «escalaremos a múltiples idiomas», una estrategia de texto a voz socarrón es una apuesta razonable a largo plazo. Si alguna de esas respuestas cambia, acota el plan antes de invertir en una voz.
Cómo nuestro texto a voz crea una voz de estilo socarrón
En el núcleo de nuestra herramienta de texto a voz, conviertes texto escrito en habla natural y de sonido humano, y eliges entre una biblioteca de más de 300 voces que abarcan más de 33 idiomas. Ese catálogo cubre una amplia gama de acentos, géneros y tonos, que es precisamente por lo que un resultado «socarrón» es posible sin ningún modo especial: simplemente estás seleccionando una voz que ya lleva esa sensación relajada y segura que asocias con ese tipo de narrador.
El flujo práctico es corto. Eliges una voz con la actitud adecuada, introduces tu texto en el idioma que necesites y generas el audio. A partir de ahí puedes ajustar la velocidad, las pausas y, a veces, el tono para que la interpretación se perciba informal y conversacional en lugar de plana. La salida es un archivo de audio que colocas directamente en tu edición, ya sea una subida a YouTube, un módulo de e-learning o un anuncio de marketing.
Lo que hace que esto sea más que un truco puntual es que DubSmart está construido como una plataforma todo en uno. Texto a Voz, Clonación de Voz, Doblaje con IA, Voz a Texto, Separador de Voz, Texto a Imagen e Imagen a Vídeo se encuentran todos en un mismo flujo de trabajo. Así, la misma voz socarrona puede pasar de la narración a una versión doblada del mismo vídeo sin salir de la herramienta ni reconstruir el personaje en otro lugar.
Tres maneras de usar el texto a voz socarrón
Hay tres rutas hacia el mismo estilo, y difieren principalmente en velocidad, propiedad y automatización.
Opción 1: Una voz predefinida de la biblioteca. El camino más rápido es elegir una voz existente de nuestro catálogo de más de 300. Para un personaje socarrón, busca un acento ligeramente informal o urbano, un tono de rango medio que se perciba seguro y un ritmo que se incline hacia lo conversacional. Como la herramienta admite contenido en más de 33 idiomas, puedes usar esa voz en inglés ahora y desplegar otros idiomas a medida que crezca tu canal. Esta ruta te conviene cuando necesitas algo de inmediato, no te importa que otros usuarios puedan elegir la misma voz, y te preocupa más el tono y la cobertura de idiomas que una identidad vocal única.
Opción 2: Clona tu propio personaje. Si quieres que la voz sea verdaderamente tuya, nuestra clonación de voz construye un modelo sintético de un hablante específico para que se pueda generar nuevo habla a partir de texto con esa voz. Grabas unos 20 segundos de habla limpia, idealmente libre de ruido de fondo, y la subes a la herramienta de Clonación de Voz, que la procesa en un perfil de voz personalizada con nombre. Una vez finalizada la clonación, esa voz aparece junto a la biblioteca base tanto en Texto a Voz como en Doblaje con IA, lista para futuros proyectos. Eso significa que un mismo personaje puede llevar tu comentario en inglés, sus versiones dobladas y la narración de personajes dentro de módulos de formación. Elige esto cuando tu marca gire en torno a un anfitrión reconocible, quieras una voz a la que nadie más pueda acceder y puedas grabar audio fuente y gestionar el permiso del hablante.
Opción 3: Automatiza mediante la API. Los desarrolladores y agencias pueden integrar el estilo en aplicaciones y flujos de trabajo con nuestra API de Texto a Voz, un servicio RESTful donde envías una solicitud POST que contiene tu texto y preferencias de voz y recibes habla de sonido natural como archivo de audio. Esas preferencias pueden hacer referencia a un ID de voz específico de la biblioteca o a un perfil de voz clonada que hayas creado antes. Eso permite que un narrador característico impulse resúmenes de vídeo automatizados, locuciones de tutoriales dentro de la app o textos de marketing dinámicos extraídos de tu CMS. Tu back end simplemente pasa el texto y el identificador de voz al endpoint, y la respuesta se transmite o se almacena donde tu producto lo necesite. Si además localizas a escala, la API de Doblaje con IA y la API de Clonación de Voz extienden la misma identidad a vídeo doblado y creación de voz personalizada de forma programática.
Qué ocurre bajo el capó
Ya uses una voz predefinida o clonada, el proceso sigue el mismo patrón básico de IA, y conocerlo te ayuda a obtener mejores resultados.
Primero viene el análisis del texto. El sistema ingiere tu guion, normaliza números y abreviaturas, y predice dónde deben caer el énfasis y las pausas. Por eso la puntuación y la longitud de las frases moldean tanto la interpretación: las líneas cortas y contundentes producen de forma natural el ritmo cortante y seguro del que depende una voz socarrona.
A continuación está el modelado acústico. Una red neuronal usa el perfil de voz que elegiste para predecir cómo debe sonar el audio momento a momento, incluidos el tono, el volumen y el ritmo. Con una voz clonada, ese modelo se ha afinado para reproducir las características de un hablante específico; con una voz predefinida, te apoyas en un perfil preentrenado que ya encaja con un estilo particular.
Finalmente, la generación de forma de onda. Un modelo vocoder convierte esas predicciones en una forma de onda de alta calidad que suena como habla humana natural.
La cualidad «socarrona» no está oculta dentro de esa maquinaria. La diriges a través de tres palancas visibles: la elección de voz (biblioteca frente a clon), la redacción del guion (lenguaje coloquial y frases ajustadas) y los ajustes de interpretación (velocidad, pausas y a veces tono). Cámbialos y cambiarás el personaje.
Criterios de decisión: cuándo apostar por ello y cuándo contenerse
Usa estas pruebas para decidir hasta dónde llevar el personaje.
| Factor | Apostar por una voz socarrona | Elegir una voz neutra |
|---|---|---|
| Encaje con la marca | Entretenimiento, creadores, explicaciones informales | Cumplimiento normativo, medicina, ámbito legal, RR. HH. |
| Audiencia | Espectadores más jóvenes, nativos de redes sociales | Compradores empresariales, formación formal |
| Plan de idiomas | Personaje localizado con cuidado por mercado | Jerga que no se traduce de forma limpia |
| Flujo de trabajo | Una plataforma mantiene la voz en todos los recursos | Múltiples herramientas desconectadas |
| Etapa presupuestaria | Pequeños experimentos antes de escalar | Contenido de alto riesgo sin margen para probar |
Una secuencia sensata es probar primero una voz de estilo socarrón predefinida en un pequeño segmento de tu audiencia. Si la participación mejora y el tono encaja con tu marca, considera clonar tu propio personaje para diferenciarte a largo plazo. Luego usa TTS multilingüe y Doblaje con IA para replicar ese personaje en canales localizados, manteniendo cada guion adaptado culturalmente en lugar de traducido palabra por palabra. Como DubSmart consolida estas herramientas en un solo lugar, mantener una voz de personaje coherente entre narración y doblaje no te obliga a hacer malabares con aplicaciones separadas. Un modelo basado en créditos con un plan gratuito también te da margen para experimentar a pequeña escala antes de aumentar el uso.
Riesgos y salvaguardas que conviene incorporar
Un estilo de voz expresivo conlleva desventajas reales si lo despliegas con descuido.
La falta de alineación con la marca es el fallo más común: una interpretación excesivamente sarcástica erosiona la confianza en temas delicados. Los desaciertos culturales son el siguiente, porque el humor y la actitud «socarrona» rara vez se traducen literalmente; lo que se percibe como desenfadado en un mercado puede sonar grosero en otro. Los derechos de voz importan sobre todo en la clonación. Modela la voz de una persona real solo con permiso claro y documentado, lo cual es crítico para proyectos comerciales. Y las voces sintéticas pueden usarse indebidamente para la suplantación o contenido engañoso cuando ninguna política interna las regula.
Las salvaguardas son sencillas. Redacta directrices de tono de marca para que el personaje tenga límites. Usa voces clonadas solo bajo acuerdos explícitos con el hablante. Revisa los guiones en cuanto a sensibilidad cultural antes de cualquier despliegue multilingüe. Y mantén las voces socarronas fuera del contenido donde la neutralidad y la autoridad son el objetivo central.
Cómo distintos creadores lo ponen en práctica
Para los creadores de YouTube, una voz socarrona funciona bien como narrador recurrente del canal para intros, comentarios y menciones a patrocinadores, mientras que tu presencia frente a cámara queda reservada para los segmentos clave. Esa misma voz puede luego doblarse a otros idiomas usando las herramientas integradas. Si estás planeando esa expansión, nuestro artículo sobre cómo construir un canal de YouTube multilingüe recorre el flujo de trabajo más amplio.
Para pequeñas empresas y equipos de marketing, el personaje aporta a las explicaciones de producto y a los anuncios en redes sociales un giro memorable. Genera locuciones en inglés mediante TTS y luego localiza las campañas reutilizando la misma voz o un equivalente adaptado culturalmente en otros idiomas.
Para los productores de e-learning y formación corporativa, reserva el estilo para módulos informales, consejos rápidos y elementos que aumentan la participación, y mantén las voces neutras para el contenido de cumplimiento y políticas. Esa división retiene la atención sin comprometer la seriedad donde importa. Nuestra visión general de qué implica la localización de medios es una introducción útil si estás montando una biblioteca de formación multilingüe.
Para cineastas y creadores de pódcast, clonar la voz de un personaje específico permite que se convierta en una presencia distintiva en tráileres, teasers y clips del detrás de cámaras. Para desarrolladores y agencias, integrar la API de TTS en tu flujo de trabajo permite que un único narrador lea texto dinámico extraído de bases de datos o contenido generado por usuarios con una identidad coherente en cada ocasión.
Preguntas frecuentes
¿Qué es el texto a voz socarrón en DubSmart?
Es habla generada por IA en la que eliges o clonas una voz que suena como un narrador ingenioso y seguro, y luego usas nuestro texto a voz para convertir guiones en audio con ese personaje. Se apoya en TTS y clonación de voz estándar en lugar de en una tecnología aparte.
¿Puede DubSmart manejar voces socarronas en múltiples idiomas?
Sí. Nuestro texto a voz y las herramientas relacionadas admiten contenido en más de 33 idiomas, así que una voz de estilo socarrón puede usarse en canales internacionales. Localiza la jerga y el humor por mercado en lugar de traducirlos literalmente.
¿Necesito mucho audio para clonar una voz socarrona?
No. La clonación de voz está diseñada para funcionar a partir de grabaciones cortas. Unos 20 segundos de habla limpia bastan para crear un perfil de voz personalizada que puedes reutilizar tanto en texto a voz como en Doblaje con IA.
¿Pueden los desarrolladores activar la narración socarrona de forma programática?
Sí. Nuestra API de Texto a Voz acepta solicitudes POST con texto y preferencias de voz y devuelve habla de sonido natural. Puedes hacer referencia a una voz predefinida o a un personaje clonado mediante su ID.
¿Hay una forma de bajo riesgo de probar esto primero?
Un modelo basado en créditos con un plan gratuito te permite probar el estilo en vídeos o campañas de muestra antes de comprometer presupuestos mayores, lo cual encaja con creadores, pequeñas empresas y agencias que experimentan con personajes de voz.