Una API de voz con IA es la conexión programable que permite a tu aplicación crear, entender, transformar o localizar audio hablado usando modelos de IA que no tienes que construir tú mismo. Envías texto, audio o video a un endpoint y recibes algo útil: narración sintetizada, una transcripción, una voz personalizada o un video completamente doblado. La verdadera pregunta cuando empiezas no es si necesitas "voz con IA"—es qué capacidad de voz requiere realmente tu producto, porque la generación de voz, el reconocimiento de voz, la clonación de voz y el doblaje son productos distintos que casualmente comparten un nombre de categoría.
Esta guía recorre lo que significa el término, los principales tipos de API y en qué se diferencian, cómo una solicitud recorre la canalización, los criterios de decisión que separan una buena elección de un error costoso, y los riesgos que vale la pena gestionar antes de lanzar. Es el eje de nuestra serie para desarrolladores y APIs, así que encontrarás enlaces a las guías de integración más detalladas donde resulten útiles.
Tabla de contenidos
Qué significa realmente "API de voz con IA"
La frase agrupa tres ideas. La voz con IA es inteligencia artificial que trabaja con el habla humana o genera habla sintética. La API es una interfaz de programación de aplicaciones—una forma definida para que dos sistemas de software intercambien solicitudes y respuestas. La combinación significa que el procesamiento pesado del modelo ocurre del lado del proveedor, mientras que tu aplicación maneja la experiencia del usuario, tus reglas de negocio y el contenido final.
Una solicitud puede ser tan simple como una pequeña carga JSON con el texto que quieres que se pronuncie, un identificador de voz y un código de idioma. La respuesta normalmente devuelve un identificador de proyecto, un estado de procesamiento y una URL al audio generado una vez que está listo. Para la localización de video, la solicitud en cambio hace referencia a un archivo subido y a una lista de idiomas de destino.
Esa estructura es lo que separa una API de un generador de voz basado en navegador. Una aplicación web está diseñada para que una persona la opere a mano, un trabajo a la vez. Una API está diseñada para que el software la llame repetidamente, de forma automática y a escala. Si estás produciendo una locución ocasional, la herramienta web suele ser más rápida. Si estás localizando cada video que publicas, la API es el punto clave.
Los cinco tipos principales de API de voz con IA
"API de voz con IA" es una categoría, no una sola tecnología. Los cinco tipos comunes toman diferentes entradas y devuelven diferentes salidas, y elegir el incorrecto desperdicia tiempo de integración. La tabla siguiente los mapea para que puedas emparejar tu material de partida con el resultado que deseas.
| Tipo de API | Entrada | Salida | Uso típico |
|---|---|---|---|
| Texto a voz | Texto escrito | Audio de voz sintética | Narración, accesibilidad, mensajes de app, formación |
| Voz a texto | Voz o video | Transcripción escrita | Subtítulos, búsqueda, notas de reuniones, reutilización |
| Clonación de voz | Muestra de voz autorizada | Voz sintética personalizada | Voces de marca, presentadores recurrentes, narración multilingüe |
| Doblaje con IA | Video o audio | Contenido traducido y con voz | Localización de YouTube, cursos, películas, pódcasts |
| Voz a voz | Habla grabada | Habla transformada o traducida | Conversión de voz, producción multilingüe |
La regla de selección es sencilla. Si ya tienes un guion, texto a voz suele ser el camino más simple. Si tienes una grabación que necesita una transcripción, necesitas voz a texto. Si quieres la misma identidad de presentador en varios idiomas, la clonación de voz o el doblaje es más apropiado. Para una explicación centrada únicamente en el aspecto TTS, nuestra guía complementaria sobre qué es una API de texto a voz profundiza en la canalización de síntesis.
Una distinción que vale la pena: la clonación de voz no es un cambiador de voz. Un cambiador de voz transforma una interpretación existente en el lugar, mientras que la clonación crea un modelo de voz reutilizable que genera nuevo habla a partir de texto u otra entrada controlada.
Cómo una solicitud recorre la canalización
Las implementaciones varían, pero la mayoría de las API de voz siguen las mismas cuatro etapas. Comprender la forma del flujo ahorra horas de conjeturas cuando algo devuelve un estado inesperado.
Primero, tu aplicación se autentica. Envía una clave de API o un token de portador en el encabezado de la solicitud. La API TTS de DubSmart, por ejemplo, usa un endpoint REST con autenticación de token de portador y solicitudes JSON contra la URL base https://dubsmart.ai/api/v1. Una regla que importa más de lo que parece: nunca coloques una clave privada en JavaScript del lado del navegador ni en una aplicación móvil distribuida. Guárdala en un servidor seguro y haz que tu cliente llame a ese servidor.
Segundo, tu aplicación envía contenido y configuraciones. Una solicitud normalmente lleva alguna mezcla de texto o una referencia a un archivo, idioma de origen y destino, un ID de voz, velocidad o tono, información del hablante, preferencias de salida y metadatos del proyecto. Para TTS simple, el contenido es texto. Para el doblaje, la API a menudo requiere primero subir un video, luego una solicitud separada para crear el proyecto.
Tercero, el servicio procesa el contenido. Dependiendo de la tarea, eso puede significar normalizar e interpretar texto, predecir la pronunciación y la prosodia, traducir contenido hablado, separar hablantes o aislar el habla del audio de fondo, generar audio con una voz estándar o personalizada, y sincronizar el resultado con una línea de tiempo de video. Los trabajos más largos se ejecutan de forma asíncrona: en lugar de devolver un archivo terminado, la API devuelve un ID de proyecto.
Cuarto, tu aplicación recupera el resultado—una URL de audio o video, URLs de segmentos individuales, una transcripción, texto traducido, datos de temporización y campos de estado o error. La API TTS de DubSmart documenta estados de proyecto como pending, processing, completed y failed, y los proyectos completados pueden devolver URLs de MP3 a nivel de proyecto o de segmento.
Síncrono versus asíncrono: la distinción que da forma a tu desarrollo
La forma en que una API devuelve resultados determina cómo diseñas tu arquitectura a su alrededor, así que decide esto antes de escribir código de integración.
Una API síncrona mantiene la solicitud abierta hasta que el procesamiento termina, luego devuelve el resultado. Eso funciona bien para texto corto, mensajes de voz breves, pequeños fragmentos de audio y funciones interactivas de baja latencia. Su debilidad es que los trabajos largos pueden exceder los tiempos de espera de la solicitud.
Una API asíncrona devuelve un ID de proyecto o trabajo de inmediato. Tu aplicación luego consulta un endpoint de estado o recibe un webhook cuando el trabajo termina. Este modelo se adapta a narraciones largas, doblaje de video, múltiples idiomas de destino, generación por lotes y archivos grandes. Los flujos de trabajo documentados de TTS y doblaje de DubSmart usan estados de proyecto y recuperación de resultados, que es un patrón asíncrono diseñado para trabajos de medios.
Cuando evalúes una opción, verifica si admite webhooks. Hacer consultas cada pocos segundos es trivial de implementar, pero los webhooks reducen las solicitudes innecesarias y escalan mejor una vez que estás ejecutando muchos trabajos a la vez.
Qué evaluar antes de comprometerte
La API correcta depende del trabajo, pero un puñado de criterios se aplican a casi todos los proyectos. Repásalos deliberadamente en lugar de confiar en una breve demostración.
Ajuste de capacidad. Confirma que la API admite la tarea exacta—texto a voz, voz a texto, clonación de voz, doblaje, múltiples hablantes, salida solo de audio o de video, en tiempo real o por lotes. No asumas que todo lo que se comercializa como "voz con IA" incluye todo esto.
Cobertura de idiomas. Verifica los idiomas de origen y destino. "Admite 30 idiomas" podría significar 30 voces TTS, 30 destinos de traducción o una mezcla de idiomas y dialectos. Para un canal multilingüe, también considera la calidad del acento, la pronunciación de nombres y lugares, el vocabulario regional, la disponibilidad de voces por idioma y si una sola voz clonada se mantiene a través de los idiomas.
Soporte de salida y medios. Verifica los formatos de audio, los contenedores de video, la frecuencia de muestreo y la tasa de bits, las descargas a nivel de segmento, el video renderizado completo, la disponibilidad de transcripciones o subtítulos, y el tamaño máximo de archivo. Estos determinan tu flujo de trabajo de edición y los costos de almacenamiento.
Calidad y controlabilidad. Escucha en busca de pausas naturales, pronunciación correcta, volumen estable, identidad de hablante consistente, énfasis apropiado y temporización precisa. Una voz puede sonar impecable en una muestra de diez segundos y tropezar con términos técnicos, párrafos largos, números o nombres inusuales. Prueba contenido representativo, no el clip seleccionado por el proveedor.
Latencia y rendimiento. Mide el tiempo frente a tu carga de trabajo real. Una locución corta y cientos de videos localizados son problemas diferentes. Pregunta si el procesamiento es en tiempo real o asíncrono, cuáles son los límites de tasa, si los trabajos se ejecutan en paralelo, si existe procesamiento prioritario y cómo se reintentan los fallos. DubSmart indica que un video típico de cinco minutos tarda alrededor de un minuto en procesarse, señalando que el tiempo depende de la duración y el tamaño del archivo.
Modelo de precios. Las API de voz pueden facturar por caracteres, palabras, duración de audio o video, créditos, solicitudes, almacenamiento o trabajos concurrentes. Para el doblaje, el número de idiomas de destino multiplica el costo efectivo. Calcula un flujo de trabajo completo—reintentos, segmentos regenerados, revisión de traducción, almacenamiento—no solo la primera llamada. Nuestro desglose de precios de API de voz con IA recorre el cálculo de créditos en detalle.
Riesgos que vale la pena gestionar temprano
La voz con IA introduce modos de fallo que no existen en las herramientas de medios ordinarias. Abordarlos durante el diseño es mucho más barato que después de un error público.
Uso de voz no autorizado. Clonar la voz de una persona sin permiso crea exposición legal, ética y reputacional. Usa un proceso de consentimiento por escrito que indique quién posee la grabación, qué se puede generar, dónde se puede usar la voz, si se permite el uso comercial, cómo se elimina la voz y qué sucede cuando termina el acuerdo.
Traducción o pronunciación incorrecta. El habla generada puede manejar mal nombres, acrónimos, direcciones y términos del sector. Mantén la revisión humana en el proceso para el contenido de cara al público: una lectura del guion traducido, una escucha por parte de un hablante nativo, verificaciones puntuales de pronunciación, una pasada de temporización y movimiento de labios, y una revisión final del medio exportado.
Suplantación y fraude. Las voces sintéticas pueden ser mal utilizadas para estafas o avales falsos. Evita generar cualquier cosa que pueda hacer que un oyente razonable crea que una persona real dijo algo que no dijo. Para comunicaciones sensibles, agrega divulgación, controles de aprobación y registros de auditoría.
Privacidad de voz y datos. Las muestras pueden contener datos personales. Antes de subir, resuelve el consentimiento, las reglas de retención, las restricciones de acceso, los procedimientos de eliminación, los términos de procesamiento de datos del proveedor y cualquier política de uso secundario. DubSmart afirma que los archivos de clonación subidos están cifrados y que los usuarios pueden eliminar voces personalizadas y los datos de audio asociados, aunque los equipos aún deben confirmar los términos y controles actuales para su plan específico.
Cambios de proveedor y modelo. Los IDs de voz, el soporte de idiomas, los formatos de salida y los límites de tasa pueden cambiar. Trata la API como una dependencia externa: fija la configuración donde puedas, almacena los guiones de origen, guarda el audio aprobado, monitorea las tasas de error, mantén un flujo de trabajo alternativo y vuelve a probar después de grandes actualizaciones del proveedor. Para los equipos que quieren menos piezas móviles, nuestro resumen de herramientas de video con IA todo en uno explica las compensaciones de consolidar estas capacidades.
Cuándo una API supera a un flujo de trabajo manual
Una API de voz con IA justifica su costo de integración cuando necesitas producción repetible y programática. Es una buena opción cuando un creador publica versiones localizadas de cada video, una pequeña empresa genera narración de productos en varios idiomas, una empresa de aprendizaje electrónico actualiza cientos de lecciones, un pódcast lanza ediciones traducidas, un producto de software agrega accesibilidad hablada, o una agencia conecta la generación de voz a su sistema de gestión de contenido.
Un flujo de trabajo de estudio manual todavía puede ganar en casos específicos: cuando un proyecto depende de una interpretación humana altamente matizada, cuando la aprobación legal requiere un actor profesional, cuando el contenido conlleva afirmaciones sensibles, cuando una grabación única es más rápida que construir una integración, o cuando el resultado necesita una fuerte dirección artística. El objetivo no es reemplazar cada voz humana. Es automatizar las partes donde la consistencia, la velocidad, la escala o la salida multilingüe importan más.
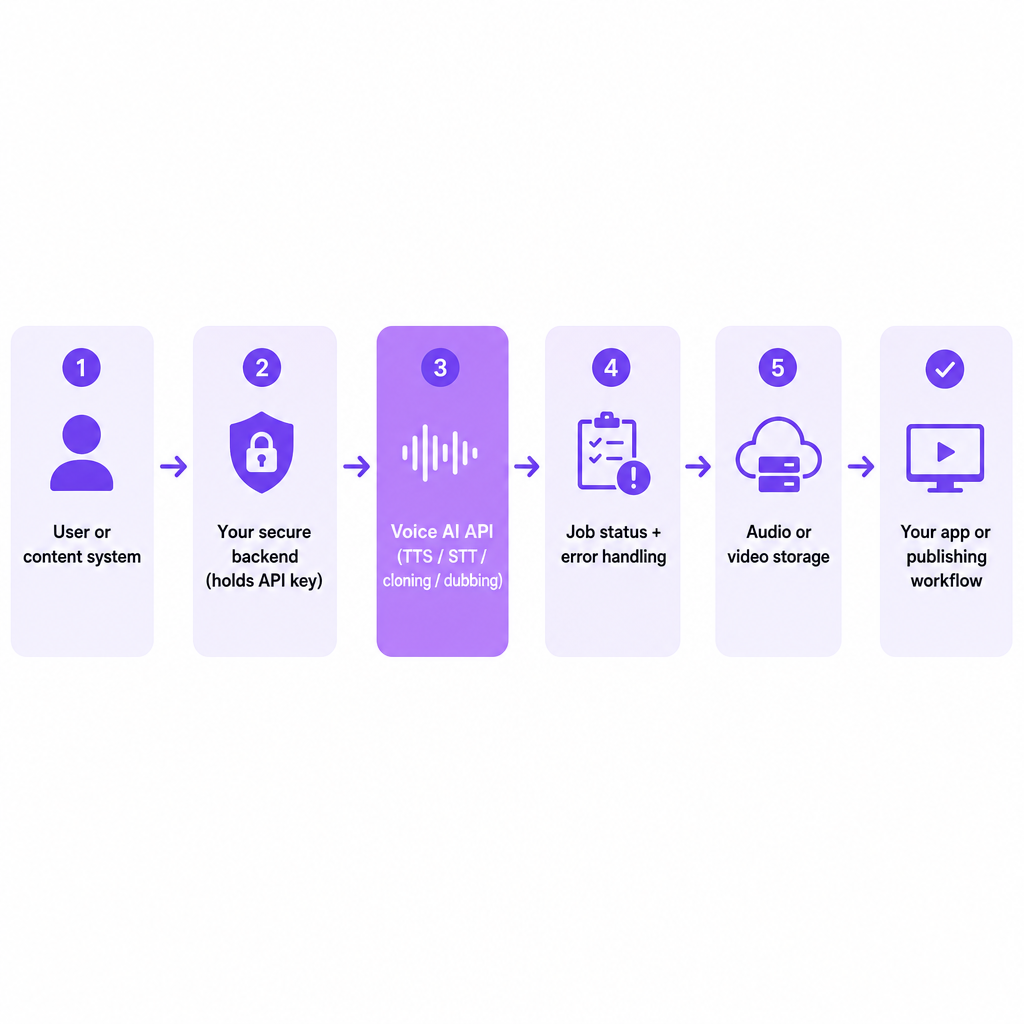
Para un desarrollo pequeño, mantén la arquitectura simple. Un backend seguro se sitúa entre tu usuario o sistema de contenido y la API de voz. Ese backend mantiene las credenciales privadas, valida la entrada, crea proyectos, almacena IDs de trabajos, consulta el estado o recibe webhooks, reintenta fallos temporales, guarda las URLs de resultados y metadatos, aplica límites de uso y registra el consentimiento para cualquier voz clonada. Una versión orientada al creador podría aceptar un video terminado en inglés, enviarlo a un endpoint de doblaje para los idiomas elegidos, esperar a que se complete, enrutar los resultados a una carpeta de revisión y publicar solo después de la aprobación.
Dónde encaja DubSmart
Construimos varias capacidades de API relacionadas con la voz en una plataforma de medios con IA, lo que importa más cuando quieres conectar la generación y la localización a un flujo de trabajo existente en lugar de ejecutar cada trabajo a mano.
Nuestra API de Texto a Voz proporciona generación de voz programática con voces neuronales, clonación de voz, soporte multilingüe, seguimiento del estado del proyecto y resultados en MP3—su solicitud de ejemplo usa segmentos de texto con un ID de voz, idioma, velocidad y tono. Nuestra API de Clonación de Voz sigue un patrón de tres pasos: solicitar una URL de subida prefirmada, subir una muestra de audio, luego crear una voz personalizada a partir de la clave del archivo subido; acepta MP3, WAV, AAC, M4A y FLAC, y recomendamos al menos 20 segundos de audio limpio para mejores resultados. Nuestra API de Doblaje con IA maneja la localización de video con creación de proyectos multilingües, configuraciones de hablantes, segmentos traducidos y salida doblada descargable, aceptando entradas como MP4, MOV, AVI, MKV y WebM hasta 5GB.
Si estás sopesando con qué endpoint comenzar, emparéjalo con tu contenido: la narración con guion apunta a TTS, una voz recurrente autorizada apunta a la clonación, y el video multilingüe apunta al doblaje.
Preguntas frecuentes
¿Qué es una API de voz con IA en términos simples?
Es una conexión que permite al software generar, reconocer, clonar, traducir o transformar el habla sin construir su propio sistema de voz con IA. Tu app envía una solicitud y recibe audio, texto o video procesado.
¿Es una API de voz con IA lo mismo que texto a voz?
No. El texto a voz es un tipo de API de voz con IA. La categoría también incluye reconocimiento de voz, clonación de voz, doblaje y funciones de voz a voz.
¿Necesito experiencia en programación para usar una?
Normalmente algo, porque las API implican autenticación, solicitudes HTTP, JSON, subida de archivos y manejo de estados. Para trabajos manuales ocasionales, una aplicación web sin código suele ser más fácil.
¿Puede una API de voz con IA traducir un video de YouTube?
Una API de doblaje puede traducir y generar nuevo audio para un video cuando admite los idiomas de origen y destino requeridos, el formato de archivo y el flujo de trabajo de salida. Revisa el resultado antes de publicar.
¿Puedo clonar la voz de cualquier persona?
Técnicamente posible no es lo mismo que legal o éticamente permitido. Clona una voz solo con el permiso apropiado, y sigue las reglas del proveedor, tus contratos y los requisitos aplicables de privacidad y derechos de imagen.