La forma más rápida de transcribir un video a texto es dejar que una herramienta de conversión de voz a texto con IA haga la primera pasada: sube el archivo de video o pega un enlace de YouTube, deja que el sistema convierta el audio hablado en una transcripción editable y luego revisa las partes que tienen más probabilidades de estar mal. Ese último paso importa más de lo que la mayoría de la gente espera, porque "rápido" debería significar una transcripción rápida en una primera pasada más un breve repaso de control de calidad, no una perfección instantánea. La escritura manual, en cambio, implica detenerse, rebobinar y volver a escribir cada línea, que es donde se esfuman las horas.
Si quieres la versión práctica de cómo transcribir un video a texto, nuestro flujo de trabajo de Voz a Texto acepta subidas de video y enlaces de YouTube, te permite editar el proyecto resultante, admite más de 60 idiomas y maneja archivos de hasta 5 GB sin un límite declarado de duración de video. El resto de esta guía explica el mecanismo detrás de eso, cómo elegir la salida correcta y cómo mantener una alta precisión cuando el audio se resiste.
Tabla de contenidos
Qué significa realmente transcribir un video a texto
La transcripción de video convierte el audio hablado dentro de un video en palabras escritas. Esa única salida puede cumplir muchas funciones: una transcripción completa del video, subtítulos o subtítulos descriptivos, un guion de edición, un borrador de blog o boletín, registros buscables de reuniones y conferencias, o texto fuente que luego traduces para nuevas audiencias.
Ayuda separar tres términos que a menudo se confunden. La transcripción mantiene el idioma hablado original en forma de texto. La traducción convierte ese contenido a otro idioma. El doblaje reemplaza o añade audio hablado en un idioma diferente. Primero transcribes y luego decides si la traducción o el doblaje es el siguiente paso. Si quieres la definición más profunda de la tecnología de reconocimiento detrás de todo esto, nuestra guía sobre cómo funciona la conversión de voz a texto cubre los fundamentos.
Cómo funciona la transcripción de video con IA por dentro
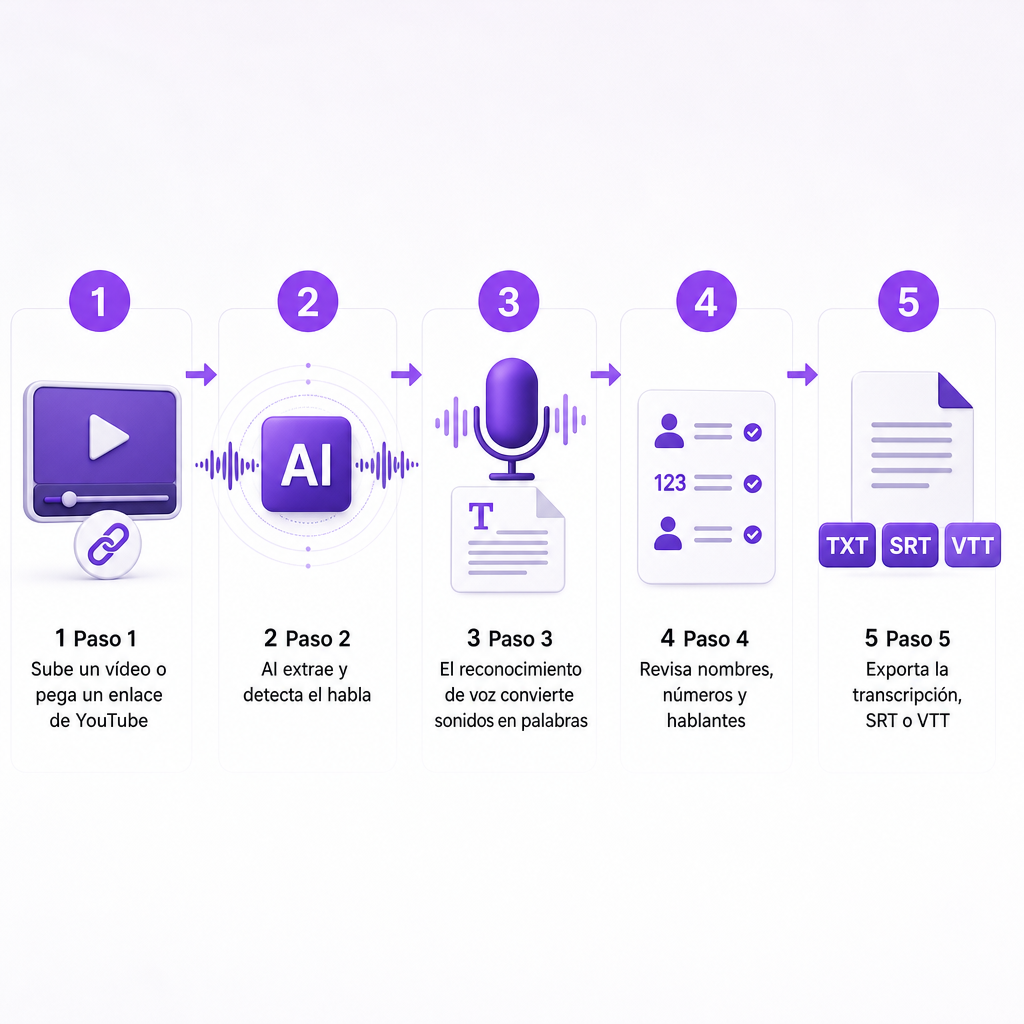
Conocer el proceso te ayuda a predecir de dónde provienen los errores. La mayoría de los sistemas de transcripción automática pasan por las mismas etapas. Primero, el sistema lee la pista de audio dentro del video. Luego, detecta qué secciones realmente contienen voz. Un modelo de reconocimiento mapea entonces los patrones de sonido a palabras, y un paso de procesamiento de lenguaje usa el contexto circundante para mejorar esas predicciones. Las palabras reconocidas se ensamblan en oraciones o segmentos temporizados, y finalmente corriges y exportas el resultado.
El modelo de reconocimiento es solo una parte de la ecuación de calidad. La calidad del micrófono, los hablantes superpuestos, los acentos, la música de fondo, el eco de la sala, el vocabulario técnico y las interrupciones dan forma a la salida. Nuestro sistema de Voz a Texto está diseñado para manejar entornos ruidosos, múltiples hablantes y diferentes idiomas y dialectos, con la advertencia honesta de que la precisión varía según la calidad del audio y la diversidad de acentos. Esa advertencia es la razón por la que existe la pasada de revisión, no un defecto que ocultar.
Transcripción, subtítulos descriptivos o subtítulos: elige la salida correcta
El mejor formato de exportación depende por completo de para qué se usará el texto, y elegir mal hace perder tiempo después.
Una transcripción simple es texto legible sin temporización requerida. Recurre a ella cuando necesites notas de investigación, registros de reuniones, un guion de video, un borrador de blog o boletín, o contenido para reutilizar. Las marcas de tiempo son opcionales aquí, aunque ayudan a los editores a desplazarse.
Los subtítulos descriptivos sincronizan el texto con el video y pueden incluir información relevante que no es habla, como música, aplausos o una puerta que se cierra. Importan para la accesibilidad y para quien mira sin sonido. Los subtítulos normalmente muestran el diálogo hablado para espectadores que no entienden el idioma. Cuando necesites subtítulos en otro idioma, transcribe primero el original, luego traduce y temporiza el texto traducido.
Para formatos temporizados, WebVTT es un estándar web para pistas de texto alineadas en el tiempo; la especificación WebVTT del W3C lo describe como un formato para subtítulos descriptivos, subtítulos, capítulos, descripciones y otros metadatos sincronizados con audio o video. Para subidas a YouTube, SubRip .srt y .vtt están ambos entre los formatos de subtítulos admitidos, y YouTube señala que los archivos básicos .srt deben usar codificación UTF-8 simple.
Limpia el audio antes de transcribir un video ruidoso
El ruido de fondo es una de las causas más comunes de errores de transcripción. Los sonidos de la calle, el aire acondicionado, la retroalimentación del micrófono, la música competidora y el eco de la sala difuminan los límites entre las palabras, y el modelo de reconocimiento tiene menos señal con la que trabajar.
La solución es aislar la voz antes de la transcripción. Nuestro Separador de Voz elimina el ruido de fondo y separa las palabras habladas del audio circundante, admitiendo formatos principales como MP3, WAV y AAC, así como archivos de video. Se gana su lugar en el flujo de trabajo para entrevistas grabadas al aire libre, pódcast capturados en salas sin tratamiento acústico, videos con música de fondo intensa, mesas redondas con niveles de micrófono desiguales y metraje de archivo que lleva zumbido o ruido ambiental.
Una advertencia para el trabajo de accesibilidad: no elimines todos los sonidos por reflejo. Si un ruido tiene significado, como una sirena, una alarma o un anuncio por altavoz, puede que aún deba representarse en los subtítulos descriptivos incluso cuando se excluye de la pista de voz limpia que envías para la transcripción.
Cómo mejorar la precisión de la transcripción
Trata la transcripción con IA como un primer borrador sólido y luego aplica controles específicos en lugar de releerlo todo a ciegas.
Empieza con el archivo fuente más claro. Sube la grabación original en lugar de una descarga comprimida de redes sociales, ya que una señal de voz más limpia le da al modelo más con lo que trabajar. Reduce el audio competidor bajando o eliminando la música de fondo, y usa la pista de voz más limpia disponible si el video tiene varias. Selecciona el idioma o dialecto que coincida con la grabación cuando exista la opción, lo que ayuda al sistema a interpretar la pronunciación, la ortografía y la estructura de las oraciones.
Luego ataca los puntos de fallo predecibles. Busca en la transcripción nombres propios como nombres, marcas, ubicaciones, términos de productos y jerga en lugar de confiar en una lectura general. Revisa los cambios de hablante y añade etiquetas de hablante manualmente cuando la transcripción se use con fines legales, educativos, de investigación o editoriales. Verifica elementos breves y críticos para el significado: fechas, precios, porcentajes, medidas, URLs, acrónimos, negaciones como "no" y palabras de sonido similar, porque un solo desliz puede invertir una oración.
El método más fiable es reproducir el video mientras sigues la transcripción. Para una grabación larga, salta primero a las secciones con nombres, números, audio poco claro o voces superpuestas. Esto refleja una advertencia que vale la pena interiorizar: los subtítulos automáticos pueden tergiversar el habla debido a errores de pronunciación, acentos, dialectos y ruido de fondo.
Adaptar el flujo de trabajo a tu tipo de contenido
Los diferentes formatos exigen distintas partes del proceso, así que ajusta dónde inviertes el tiempo de revisión.
Para videos de YouTube, una transcripción alimenta subtítulos, descripciones, capítulos, selección de clips y reutilización orientada a la búsqueda; usa la subida original o una fuente de alta calidad cuando seas dueño del video. Las entrevistas y pódcast normalmente necesitan etiquetas de hablante y un manejo de ruido más fuerte, así que limpia primero el audio de entornos ruidosos y mantén la identidad del hablante consistente. Los videos de e-learning y formación deben priorizar la precisión en instrucciones, terminología, números y referencias en pantalla, con subtítulos sincronizados lo suficientemente cerca como para que los estudiantes sigan la explicación y la pantalla juntas.
Las reuniones de trabajo se convierten en registros buscables y elementos de acción, pero las conversaciones sensibles requieren cuidado adicional: verifica nombres, decisiones, fechas y responsabilidades asignadas antes de compartir. Los videos sociales de formato corto a menudo convierten la transcripción en subtítulos en pantalla, una descripción de publicación o versiones traducidas, así que mantén los saltos de línea cortos para móviles y asegúrate de que los subtítulos no cubran elementos visuales importantes.
Cómo elegir una herramienta de video a texto
Evalúa todo el flujo de trabajo, no solo un número de precisión anunciado. La tabla a continuación mapea los criterios que realmente cambian tu tiempo de entrega y la calidad de la salida.
| Criterio de decisión | Qué comprobar |
|---|---|
| Compatibilidad de entrada | ¿Acepta tu video, audio o una URL de YouTube? |
| Límites de archivo | ¿Cuál es el tamaño máximo de archivo y la duración del video? |
| Cobertura de idiomas | ¿Admite tu idioma, dialecto y acentos? |
| Manejo de hablantes | ¿Puedes identificar o separar varios hablantes? |
| Formatos de salida | ¿Puedes exportar texto simple, SRT o VTT? |
| Integración | ¿Hay una API para procesar videos a gran escala? |
Nuestra página pública de Voz a Texto confirma la entrada de video y enlaces de YouTube, proyectos editables, descargas, compatibilidad con más de 60 idiomas y un límite de tamaño de 5 GB. No indicamos en esa página si cada salida incluye marcas de tiempo, cuánto tiempo se conservan los archivos ni si la identificación de hablantes es automática, así que confirma esos detalles para tu propio flujo de trabajo antes de comprometer contenido sensible o de gran volumen. Si alguna de esas respuestas es decisiva para ti, dinos tu tipo de archivo, idioma, número de hablantes y salida prevista y podemos indicarte la configuración correcta.
Privacidad, derechos y un estándar de revisión sensato
Una transcripción puede contener información empresarial confidencial, datos personales, conversaciones de clientes, contenido no publicado o material protegido por derechos de autor. Antes de subir, confirma que tienes permiso para procesar la grabación, que existe cualquier consentimiento requerido del hablante y si el video contiene información confidencial o regulada. Comprueba cómo un proveedor almacena y elimina los archivos subidos y las transcripciones generadas, quién puede acceder al proyecto y a las exportaciones, y si los archivos pueden usarse para entrenar modelos. Recuerda que transcribir una grabación con derechos de autor es técnicamente fácil, pero no otorga permiso para redistribuir su contenido; aún necesitas derechos para publicar la fuente, la transcripción, los subtítulos o las traducciones.
Calibra la profundidad de la revisión según lo que está en juego. Una revisión ligera conviene para clips sociales, notas internas y lluvia de ideas preliminar: escanea en busca de errores obvios, nombres, números y oraciones faltantes. Una revisión completa conviene para cursos, subtítulos públicos, entrevistas, registros de clientes, material legal y cualquier cosa publicada: escucha la grabación completa, corrige la redacción, verifica las etiquetas de hablante, revisa las marcas de tiempo y confirma que los subtítulos cumplen las reglas de formato de la plataforma de destino. Para la accesibilidad, revisa más allá del diálogo, ya que efectos de sonido importantes, cambios de hablante y señales significativas pueden necesitar representación en los subtítulos descriptivos.
El camino eficiente es el mismo cada vez: empieza con el video más limpio que tengas, aísla la voz cuando el audio sea difícil, genera una transcripción editable, verifica nombres y números, y exporta el formato que requiere tu plataforma. Para equipos que trabajan en varios idiomas, esa transcripción también es el punto de partida natural para la traducción y el doblaje posteriores.
Preguntas frecuentes
¿Cuál es la forma más rápida de transcribir un video a texto?
Usa una herramienta automática de voz a texto que acepte el video directamente o admita un enlace de YouTube. Sube la fuente más clara, selecciona el idioma correcto, genera la transcripción y luego revisa primero las secciones más propensas a errores.
¿Puedo transcribir un video sin escribir manualmente?
Sí. Las herramientas de voz a texto con IA convierten el audio hablado en texto editable automáticamente. Aun así, deberías revisar la salida, porque la precisión puede variar con el ruido, los acentos, el habla superpuesta y el vocabulario especializado.
¿Puede DubSmart transcribir un video largo?
Sí. Nuestra herramienta de Voz a Texto acepta audio o video subido y enlaces de YouTube, admite edición y te permite descargar el proyecto terminado. Indicamos compatibilidad con más de 60 idiomas y un límite de archivo de 5 GB, sin un límite declarado de duración de video; el tiempo real de procesamiento varía según el archivo y el audio.
¿Qué debo hacer si la transcripción tiene muchos errores?
Mejora primero el audio fuente. Elimina el ruido competidor con una herramienta de separación de voz, confirma el idioma seleccionado, luego regenera o edita la transcripción, prestando especial atención a nombres propios, números, acentos y hablantes superpuestos.
¿Qué formato de subtítulos debo usar?
Usa el formato que requiere tu plataforma. SRT tiene amplia compatibilidad, mientras que WebVTT es un formato de texto temporizado orientado a la web, y YouTube admite ambos entre sus formatos de subtítulos.