Si has llegado a comfyui text to speech esperando un único botón que convierta un guion en audio, lo primero que conviene saber es que ComfyUI no es en absoluto un motor de voz. Es un espacio de trabajo basado en nodos donde conectas texto, una voz, un modelo, un idioma y una salida de audio en un grafo reutilizable. El habla en sí proviene del nodo TTS que conectes: un proveedor alojado, una integración de socio oficial o un modelo local que instalas tú mismo. La pregunta que realmente importa, entonces, no es si ComfyUI puede hablar tu guion, porque puede, sino si un grafo visual es el lugar adecuado para el trabajo que necesitas repetir.
Esa distinción determina todas las demás decisiones de esta página. ComfyUI premia la experimentación y las canalizaciones multimodales donde la narración se sitúa junto a la generación de imagen, vídeo y audio. Una herramienta de habla dedicada premia la producción repetible donde simplemente necesitas voces en off limpias una y otra vez. A continuación, desglosamos cómo funciona el flujo de trabajo, qué tipos de opciones existen, cómo evaluarlas y en qué punto un grafo deja de valer la pena por su mantenimiento.
Tabla de contenidos
Qué es realmente ComfyUI text to speech
ComfyUI text to speech es la práctica de usar un grafo de ComfyUI para convertir texto escrito en una salida de AUDIO. La documentación oficial describe ComfyUI como una aplicación de código abierto basada en nodos para crear flujos de trabajo en generación de imagen, vídeo, audio y 3D, y sus nodos de audio conectan servicios o modelos de habla externos en ese mismo lienzo visual.
Un grafo de habla funcional es pequeño. Necesita una entrada de texto o prompt, un nodo TTS, una entrada de voz o audio de referencia, ajustes opcionales de idioma y entrega, y un nodo de previsualización o guardado de audio. El nodo TTS pasa tu guion a través de un modelo de habla y devuelve el audio generado que los nodos posteriores pueden utilizar.
La consecuencia práctica es que ComfyUI es la capa del flujo de trabajo, no el modelo. La voz real puede ser producida por un proveedor alojado, un modelo de audio de un socio, un nodo personalizado de terceros o un sistema instalado localmente. Comprender esa división es lo que mantiene tus expectativas ajustadas: estás ensamblando una canalización, y aún eliges el motor que va dentro de ella.
Cómo funciona el flujo de trabajo de cuatro etapas
Quita los nombres de los nodos y cada grafo de habla de ComfyUI hace las mismas cuatro cosas en secuencia.
Primero, el guion llega como texto. El nodo TTS puede tomar texto plano directamente, o el texto puede fluir desde otro nodo que carga, traduce o segmenta un guion más largo. Dividir una narración larga en secciones lógicas te permite regenerar un párrafo sin reconstruir toda la voz en off, y te ayuda a mantenerte por debajo del límite de entrada de un proveedor.
Segundo, el flujo de trabajo selecciona una voz y un modelo. Dependiendo del proveedor, eso podría ser un hablante preestablecido, una voz clonada, un ID de voz o una grabación de referencia. La elección del modelo también rige la velocidad, la calidad, el rango expresivo y el costo. El nodo HeyGen de ComfyUI, por ejemplo, expone tanto heygen-voice-1 como un heygen-voice-1-turbo más rápido y de menor costo, mientras que el nodo de ElevenLabs ofrece controles como estabilidad, velocidad y estilo.
Tercero, el modelo de habla sintetiza el audio. Los sistemas neuronales modernos estiman la pronunciación, el ritmo, las pausas y el movimiento del tono en lugar de unir palabras pregrabadas, y devuelven una forma de onda que puedes encaminar: guardada en un archivo, mezclada con música, insertada en un grafo de vídeo o emparejada con un avatar.
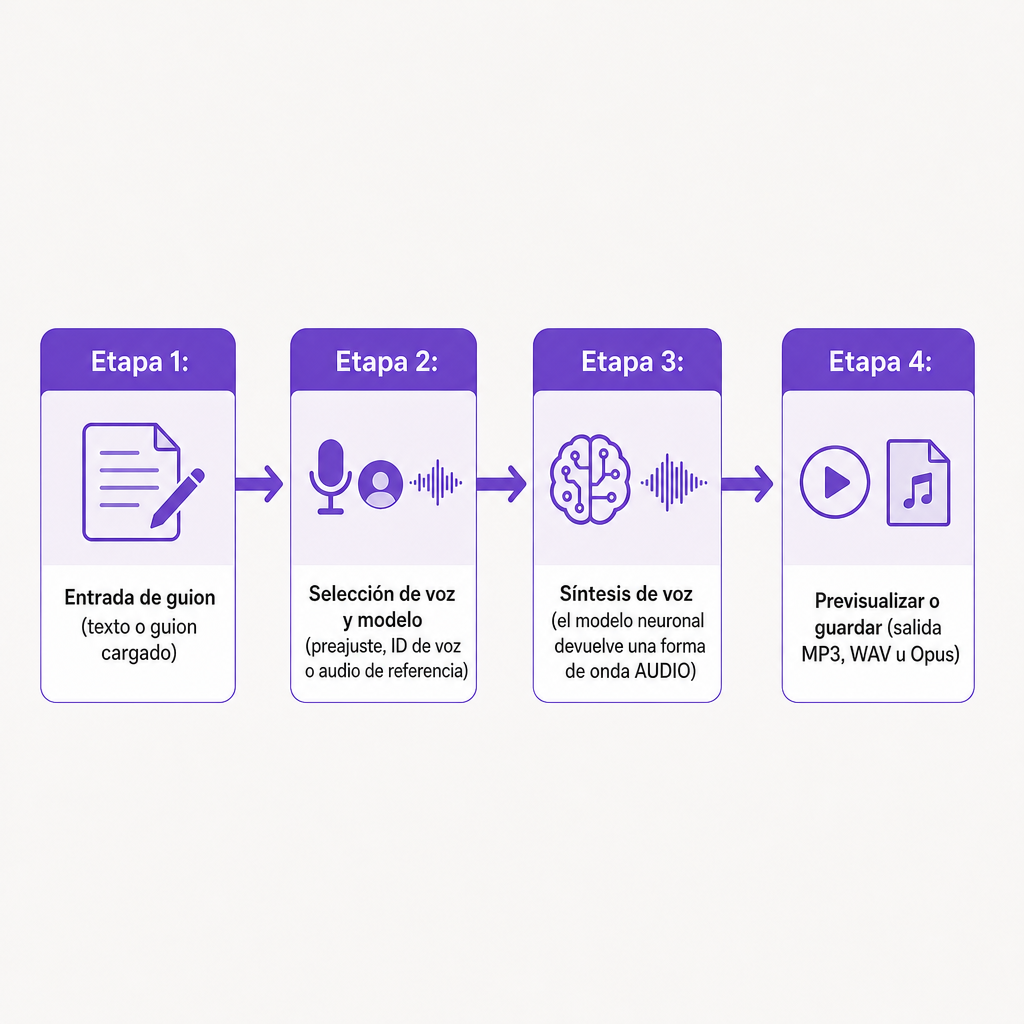
Cuarto, el audio se previsualiza o se guarda. Los nodos TTS normalmente emiten un objeto AUDIO que se conecta a un nodo de previsualización o guardado, con el formato de archivo establecido por el nodo y el proveedor; la documentación del nodo de ElevenLabs, por ejemplo, enumera formatos seleccionables que incluyen variantes de MP3 y Opus. Como el grafo es visual, el bucle es fácil de volver a ejecutar: cambia el guion, la voz, el idioma o el modelo, y luego ponlo de nuevo en cola.
Las tres formas de ejecutar TTS en ComfyUI
No existe un único método de habla en ComfyUI, y las diferencias se reducen a la configuración, el control, la privacidad y cuánto mantenimiento estás dispuesto a asumir.
Los nodos de proveedores alojados envían tu texto y tus ajustes de voz a un servicio externo y devuelven el audio terminado. Esta suele ser la vía más rápida hacia un habla de alta calidad porque el modelo se ejecuta en la infraestructura del proveedor. El nodo HeyGen Voice 1.0 ilustra el patrón: requiere un ID de voz clonada válido, envía el texto y el ID a HeyGen y devuelve el habla. Las contrapartidas también son predecibles, ya que puede requerirse una cuenta o una conexión de API, el uso puede consumir créditos del proveedor, tu texto y audio son procesados por un tercero, y los límites o precios del proveedor pueden cambiar.
Los nodos de audio de socios oficiales extienden la misma idea a una parte mayor del espacio del audio. La documentación de audio de ComfyUI separa la generación de texto a audio de los casos de uso de voz y habla, incluyendo habla a partir de texto y a partir de audio de referencia. Estas integraciones destacan cuando tu grafo ya depende de otros modelos de medios alojados, porque reducen el trajín de mover archivos entre aplicaciones separadas.
Los nodos TTS comunitarios y locales conectan ComfyUI con sistemas como Edge TTS, Kokoro, Index-TTS y otros modelos que pueden ejecutarse localmente. Los flujos de trabajo locales pueden darte más control sobre tus datos y la elección de modelo, pero piden más a cambio: instalación, hardware compatible, descargas de modelos y resolución de problemas. Un nodo local no es automáticamente mejor que uno alojado. Su ventaja real depende de si tu máquina puede ejecutar el modelo de forma eficiente, de si la calidad de voz se mantiene, de si tu idioma es compatible, de si la licencia permite el uso comercial y de si puedes mantener el flujo de trabajo vivo con el tiempo.
Clonación de voz y los controles que puedes esperar
La clonación de voz añade una identidad de referencia al grafo en lugar de un hablante estándar. La estructura suele constar de dos partes conectadas: un nodo de clonación que crea o devuelve una identidad de voz, y un nodo TTS que usa esa identidad para decir texto nuevo. La documentación de HeyGen lo describe directamente, donde un nodo Instant Clone produce un voice_id que alimenta el nodo Voice 1.0 Text to Speech; ese flujo de clonación pide al menos 10 segundos de habla clara, y el nodo TTS acepta hasta 5.000 caracteres por solicitud.
Clona solo con autorización. No repliques la voz de una persona real simplemente porque puedes acceder a una grabación. Obtén permiso, conserva la prueba de ello y revela el habla sintética o clonada siempre que el contexto pueda inducir a error a una audiencia.
Más allá de la voz en sí, los controles que encontrarás varían según el nodo y el modelo, pero un conjunto familiar se repite en la mayoría de ellos.
- Voz: la identidad del hablante o el preajuste
- Idioma: el idioma usado para interpretar el guion
- Velocidad: la rapidez con la que se entrega la narración
- Tono: la altura o gravedad percibida de la voz
- Estilo y expresividad: el carácter de la entrega y con qué fuerza se aplica la emoción
- Estabilidad: con qué consistencia la voz mantiene sus características
- Formato de salida: como MP3, WAV u Opus
- Audio de referencia: una grabación usada para clonación o transformación del habla
Algunos modelos van más allá con señales en línea. La documentación del nodo Fish Audio admite señales de emoción y etiquetas de diálogo multihablante en los modelos compatibles. Una advertencia vale para todos ellos: estos controles no son intercambiables entre proveedores, y un ajuste llamado estilo en un nodo puede comportarse de forma totalmente distinta al estilo en otro.
ComfyUI frente a una plataforma de TTS dedicada
ComfyUI se gana su lugar cuando el habla es una parte de una canalización de medios más grande. Una plataforma dedicada tiende a ganar cuando el único trabajo real es convertir guiones en una narración pulida sin ensamblar un grafo.
| Factor de decisión | ComfyUI | Plataforma de TTS dedicada |
|---|---|---|
| Flexibilidad del flujo de trabajo | Alta; conecta TTS con otros nodos de medios | Normalmente centrada en la producción de habla |
| Configuración | Puede necesitar nodos, enlaces de proveedor o instalaciones de modelos | A menudo más rápida para la primera generación |
| Opciones de voz | Depende de los nodos instalados o conectados | Normalmente una biblioteca de voces organizada |
| Automatización | Potente para grafos visuales reutilizables | A menudo mediante API o herramientas por lotes |
| Procesamiento local | Posible con nodos y modelos locales | Normalmente basada en la nube |
| Mejor caso de uso | Canalizaciones experimentales o multimodales | Narración y producción repetibles |
Para los creadores que construyen una canalización visual que combina habla con procesamiento de imagen, vídeo o audio, el grafo se amortiza por sí solo. Para narración de YouTube, voces en off de e-learning, pódcast o equipos de localización que necesitan una interfaz predecible, un servicio especializado normalmente elimina la sobrecarga técnica. Nuestro flujo de trabajo de Text to Speech está construido en torno a la generación directa de guion a audio, con más de 300 voces de IA, clonación de voz en 33 idiomas, velocidad de habla ajustable, señales de diálogo emocionales y proyectos descargables. Cuando la generación tiene que vivir dentro de una aplicación o de una canalización de contenido automatizada, nuestra API de Text to Speech se encarga del lado de la integración, y nuestra API de Doblaje con IA extiende la misma idea al vídeo traducido con voces coincidentes.
Cómo elegir y solucionar problemas de tu configuración
Antes de comprometerte con un nodo o modelo, realiza algunas comprobaciones deliberadas en lugar de confiar en una demostración corta.
Evalúa la calidad de la voz con una muestra difícil, no con una fácil. Genera un pasaje que incluya nombres, números, siglas, frases largas, preguntas, términos de marca y al menos una línea emocional en tu idioma y acento de destino. Una voz que te encanta en una frase corta puede destrozar el nombre de un producto o perder el ritmo a lo largo de un párrafo.
Comprueba el soporte de idioma y acento por idioma, no en conjunto. Algunos sistemas detectan el idioma automáticamente mientras que otros requieren que lo establezcas, y la documentación del nodo HeyGen recomienda establecer el idioma manualmente para idiomas estrechamente relacionados donde la detección automática puede ser poco fiable. Recuerda que una voz fluida no puede rescatar una traducción inexacta; la calidad de la voz y la calidad de la traducción son problemas distintos.
Mide el control de la pronunciación para las palabras que realmente hacen tropezar a los motores: nombres de productos, nombres propios, abreviaturas, fechas, divisas y vocabulario técnico. Si un nodo no ofrece un diccionario de pronunciación o controles de estilo SSML, prevé reescribir el texto fonéticamente o escribir los números con letras. Para una serie o un canal de marca, prueba también la consistencia ejecutando la misma voz en varias generaciones, tonos y secciones regeneradas, ya que ejecuciones separadas de ComfyUI para distintas escenas pueden desviarse.
Sopesa la latencia, el costo, la privacidad y los derechos en conjunto. Los nodos alojados arrancan rápido pero dependen de la velocidad de red, la disponibilidad del proveedor, los límites de la cuenta y el precio por uso, mientras que los modelos locales evitan los cargos por solicitud pero exigen hardware y mantenimiento; compara el costo total de producción, no la tarifa anunciada. En cuanto a la privacidad, confirma cómo se almacena la entrada, si el contenido entrena el modelo, si los datos de voz pueden eliminarse, si se permite el uso comercial, quién posee la salida y qué consentimiento requieren las voces clonadas.
Cuando un grafo se comporta mal, los fallos se agrupan en una lista corta. Un nodo de voz clonada que devuelve un error a menudo tiene un voice_id vacío o no válido; el nodo HeyGen se detiene exactamente por esa razón. Los guiones demasiado largos alcanzan los límites, y el documentado nodo HeyGen Voice 1.0 acepta hasta 5.000 caracteres mientras advierte de que un habla muy larga puede fallar, particularmente para textos extensos en chino o japonés, así que divide la narración en secciones lógicas. La pronunciación incorrecta suele responder a reescribir los números con palabras, añadir puntuación o escribir las siglas por completo. Una salida demasiado expresiva pide menor expresividad, estilo o variación de tono. Y cuando el audio no se conecta aguas abajo, comprueba el tipo, ya que una salida AUDIO no puede alimentar un nodo que espera una imagen, vídeo o texto sin un paso de conversión. Por último, guarda un grafo limpio con nodos nombrados y ajustes registrados, porque el proveedor, el ID de voz, el idioma y el formato de salida que usaste son los detalles que tu yo futuro necesitará.
Preguntas frecuentes
¿Es ComfyUI una herramienta de texto a voz?
ComfyUI es una aplicación de flujo de trabajo basada en nodos, más que un único motor de TTS. Puede generar habla a través de nodos integrados, integraciones de socios y nodos TTS comunitarios o locales.
¿Puede ComfyUI clonar una voz?
Sí, si la integración o el nodo personalizado seleccionado admite la clonación. Los requisitos exactos de grabación, el proceso de ID de voz, los límites y las condiciones comerciales dependen del proveedor.
¿Funciona ComfyUI text to speech sin conexión?
Puede hacerlo cuando usas un modelo TTS local compatible y nodos locales. Los nodos de proveedores alojados requieren una conexión a internet y pueden enviar datos de texto o de voz al proveedor.
¿Cuál es el mejor nodo TTS de ComfyUI?
No hay un mejor nodo universal. Elige según el soporte de idioma, la calidad de la voz, las necesidades de clonación, la privacidad, el costo, la latencia y la compatibilidad con el resto de tu flujo de trabajo.
¿Puedo usar ComfyUI TTS para vídeos de YouTube?
Sí. Genera la narración, revisa la pronunciación y los derechos, exporta el audio y sincronízalo con tu vídeo. Si usas una voz clonada o sintética, cumple con los requisitos de consentimiento, divulgación y de la plataforma que correspondan.