Eine Wiseguy-Text-to-Speech-Stimme ist KI-generierte Sprache, die so klingen soll wie ein geistreicher, selbstbewusster, leicht schnoddriger Erzähler, den Sie in Videos, Werbespots und Schulungsinhalten wiederverwenden können. Es ist keine separate Technologie. Es ist ein Voiceover-Stil, den Sie auf gewöhnlicher Text-to-Speech (TTS) und Voice-Cloning aufbauen: Sie schreiben ein Skript, wählen oder erstellen eine Stimme mit dieser schlitzohrigen Attitüde und generieren Audio, das von einem Inhalt zum nächsten dieselbe Persönlichkeit beibehält. Mit DubSmart AI kann diese Wiseguy-Persona von einer vorgefertigten Stimme aus unserer Bibliothek oder von einer benutzerdefinierten Stimme stammen, die Sie aus Ihren eigenen Aufnahmen klonen.
Diese Unterscheidung ist wichtiger als das Etikett. Das Wort „Wiseguy" beschreibt einen Tonfall, nicht einen Knopf. Alles, was die Stimme wiedererkennbar macht, ergibt sich aus drei Hebeln, die Sie steuern: die Stimme, die Sie wählen, wie Sie das Skript schreiben und wie Sie die Wiedergabe einstellen. Dieser Leitfaden erklärt, was der Stil wirklich ist, wie unsere Text-to-Speech ihn erzeugt, die drei praktischen Wege, ihn einzusetzen, und wann ein spielerischer Erzähler hilft – und wann er Sie stillschweigend Vertrauen kostet.
Inhaltsverzeichnis
Ist eine Wiseguy-Stimme das Richtige für Ihr Projekt?
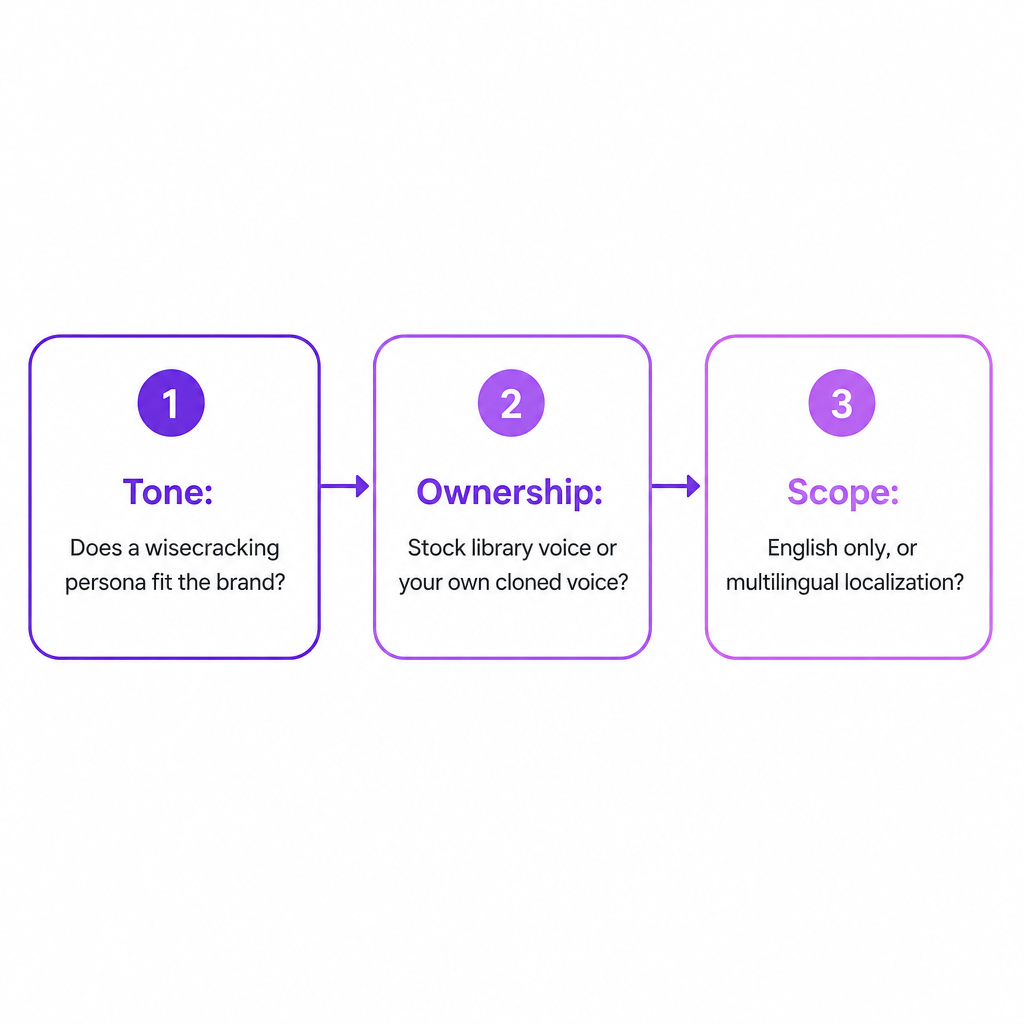
Bevor Sie sich nach einer Stimme umsehen, klären Sie drei Fragen, denn sie entscheiden alles, was danach kommt.
Die erste ist der Tonfall. Eine geistreiche, schnoddrige Persona kann Unterhaltung, Creator-Content und informelle Erklärvideos ansprechender machen. Sie kann aber auch die Glaubwürdigkeit bei ernsten Inhalten untergraben. Wenn Ihre Inhalte im Bereich Gesundheit, Finanzen, HR, Recht oder Compliance angesiedelt sind, wirkt ein vorlauter Erzähler gegen Sie.
Die zweite ist die Eigentümerschaft. Wollen Sie einen generischen KI-Charakter, den jeder andere ebenfalls auswählen könnte, oder eine Stimme, die unverkennbar Ihre ist? Eine Standardstimme ist schneller einsatzbereit; eine geklonte Stimme verschafft Ihnen eine stimmliche Identität, die kein Wettbewerber aus demselben Regal ziehen kann.
Die dritte ist der Umfang. Wenn Sie heute nur englisches Voiceover benötigen, reicht die Wahl einer einzigen Stimme. Wenn Sie planen, in andere Sprachen zu expandieren, brauchen Sie eine Persona, die reisefähig ist, was Sie zu einer Plattform führt, die mehrsprachige Ausgabe bewältigt, ohne einen Werkzeugwechsel zu erzwingen.
Wenn die ehrlichen Antworten „unsere Marke ist spielerisch", „wir wollen einen unverwechselbaren Klang" und „wir werden in mehrere Sprachen skalieren" lauten, ist eine Wiseguy-Text-to-Speech-Strategie eine vernünftige langfristige Wette. Wenn eine dieser Antworten kippt, grenzen Sie den Plan ein, bevor Sie in eine Stimme investieren.
Wie unsere Text-to-Speech eine Stimme im Wiseguy-Stil erzeugt
Im Kern unseres Text-to-Speech-Tools wandeln Sie geschriebenen Text in natürliche, menschenähnliche Sprache um und wählen aus einer Bibliothek von mehr als 300 Stimmen in über 33 Sprachen. Dieser Katalog deckt eine große Bandbreite an Akzenten, Geschlechtern und Tonfällen ab, weshalb ein „Wiseguy"-Ergebnis ganz ohne speziellen Modus möglich ist: Sie wählen einfach eine Stimme, die bereits das entspannte, selbstbewusste Gefühl mitbringt, das Sie mit dieser Art von Erzähler verbinden.
Der praktische Ablauf ist kurz. Sie wählen eine Stimme mit der richtigen Attitüde, geben Ihren Text in der benötigten Sprache ein und generieren das Audio. Von dort aus können Sie Geschwindigkeit, Pausen und manchmal Tonhöhe anpassen, sodass die Wiedergabe informell und dialogisch statt flach wirkt. Das Ergebnis ist eine Audiodatei, die Sie direkt in Ihren Schnitt einfügen, sei es ein YouTube-Upload, ein E-Learning-Modul oder ein Werbespot.
Was dies zu mehr als einem einmaligen Trick macht, ist, dass DubSmart als All-in-One-Plattform aufgebaut ist. Text-to-Speech, Voice-Cloning, KI-Dubbing, Speech-to-Text, Speech-Separator, Text-to-Image und Image-to-Video liegen alle in einem Workflow. So kann dieselbe Wiseguy-Stimme von der Erzählung in eine gedubbte Version desselben Videos wechseln, ohne das Tool zu verlassen oder die Persona anderswo neu aufzubauen.
Drei Wege, Wiseguy-Text-to-Speech einzusetzen
Es gibt drei Wege zum selben Stil, und sie unterscheiden sich hauptsächlich in Geschwindigkeit, Eigentümerschaft und Automatisierung.
Option 1: Eine Standardstimme aus der Bibliothek. Der schnellste Weg ist die Wahl einer bestehenden Stimme aus unserem Katalog mit über 300 Stimmen. Für eine Wiseguy-Persona suchen Sie nach einem leicht lässigen oder urbanen Akzent, einer mittleren Tonhöhe, die selbstbewusst wirkt, und einem Tempo, das dialogisch angehaucht ist. Da das Tool Inhalte in über 33 Sprachen unterstützt, können Sie diese Stimme jetzt auf Englisch einsetzen und weitere Sprachen ausrollen, während Ihr Kanal wächst. Dieser Weg passt zu Ihnen, wenn Sie sofort etwas brauchen, es Ihnen nichts ausmacht, dass andere Nutzer dieselbe Stimme wählen könnten, und Ihnen Tonfall und Sprachabdeckung wichtiger sind als eine einzigartige stimmliche Identität.
Option 2: Klonen Sie Ihre eigene Persona. Wenn die Stimme wirklich Ihre sein soll, erstellt unser Voice-Cloning ein synthetisches Modell eines bestimmten Sprechers, sodass neue Sprache aus Text in dieser Stimme generiert werden kann. Sie nehmen rund 20 Sekunden sauberer Sprache auf, idealerweise frei von Hintergrundgeräuschen, und laden sie in das Voice-Cloning-Tool hoch, das sie zu einem benannten benutzerdefinierten Stimmprofil verarbeitet. Sobald das Klonen abgeschlossen ist, erscheint diese Stimme neben der Basisbibliothek in Text-to-Speech und KI-Dubbing, bereit für künftige Projekte. Das bedeutet, dass eine Persona Ihren englischen Kommentar, dessen gedubbte Versionen und die Charaktererzählung in Schulungsmodulen tragen kann. Wählen Sie dies, wenn Ihre Marke sich um einen wiedererkennbaren Host dreht, Sie eine Stimme wollen, auf die niemand sonst zugreifen kann, und Sie Quellaudio aufnehmen und die Genehmigung des Sprechers verwalten können.
Option 3: Automatisieren über die API. Entwickler und Agenturen können den Stil mit unserer Text-to-Speech-API in Apps und Pipelines einbinden, einem RESTful-Dienst, bei dem Sie eine POST-Anfrage mit Ihrem Text und Ihren Stimmpräferenzen senden und natürlich klingende Sprache als Audiodatei erhalten. Diese Präferenzen können eine bestimmte Bibliotheks-Stimmen-ID oder ein zuvor erstelltes geklontes Stimmprofil referenzieren. Damit kann ein charakteristischer Erzähler automatisierte Video-Zusammenfassungen, In-App-Tutorial-Voiceovers oder dynamische Marketingtexte aus Ihrem CMS antreiben. Ihr Backend übergibt einfach Text und die Stimmenkennung an den Endpunkt, und die Antwort wird gestreamt oder dort gespeichert, wo Ihr Produkt sie benötigt. Wenn Sie auch in großem Umfang lokalisieren, erweitern die KI-Dubbing-API und die Voice-Cloning-API dieselbe Identität programmatisch in gedubbte Videos und benutzerdefinierte Stimmerstellung.
Was hinter den Kulissen passiert
Ob Sie eine Standard- oder geklonte Stimme verwenden, die Pipeline folgt demselben grundlegenden KI-Muster, und es zu kennen hilft Ihnen, bessere Ergebnisse zu erzielen.
Zuerst kommt die Textanalyse. Das System nimmt Ihr Skript auf, normalisiert Zahlen und Abkürzungen und sagt voraus, wo Betonungen und Pausen liegen sollten. Deshalb prägen Interpunktion und Satzlänge die Wiedergabe so stark: kurze, prägnante Zeilen erzeugen ganz natürlich den abgehackten, selbstbewussten Rhythmus, auf den eine Wiseguy-Stimme angewiesen ist.
Als Nächstes folgt die akustische Modellierung. Ein neuronales Netzwerk nutzt Ihr gewähltes Stimmprofil, um vorherzusagen, wie das Audio Moment für Moment klingen sollte, einschließlich Tonhöhe, Lautstärke und Timing. Bei einer geklonten Stimme wurde dieses Modell feinabgestimmt, um die Merkmale eines bestimmten Sprechers zu reproduzieren; bei einer Standardstimme greifen Sie auf ein vortrainiertes Profil zurück, das bereits zu einem bestimmten Stil passt.
Schließlich die Wellenformerzeugung. Ein Vocoder-Modell wandelt diese Vorhersagen in eine hochwertige Wellenform um, die wie natürliche menschliche Sprache klingt.
Die „Wiseguy"-Qualität ist nicht in dieser Maschinerie verborgen. Sie steuern sie über drei sichtbare Hebel: die Stimmwahl (Bibliothek versus Klon), das Verfassen des Skripts (umgangssprachliche Sprache und knappe Sätze) und die Wiedergabeeinstellungen (Geschwindigkeit, Pausen und manchmal Tonhöhe). Ändern Sie diese, und Sie ändern den Charakter.
Entscheidungskriterien: wann man voll einsteigt, wann man zurückhaltend bleibt
Nutzen Sie diese Tests, um zu entscheiden, wie weit Sie die Persona treiben.
| Faktor | Voll auf eine Wiseguy-Stimme setzen | Eine neutrale Stimme wählen |
|---|---|---|
| Markenpassung | Unterhaltung, Creator, informelle Erklärvideos | Compliance, Medizin, Recht, HR |
| Publikum | Jüngere, social-media-affine Zuschauer | Enterprise-Käufer, formelle Schulungen |
| Sprachplan | Persona sorgfältig je Markt lokalisiert | Slang, der sich nicht sauber übersetzen lässt |
| Workflow | Eine Plattform pflegt die Stimme über alle Assets | Mehrere getrennte Tools |
| Budgetphase | Kleine Experimente vor dem Skalieren | Inhalte mit hohem Risiko ohne Spielraum zum Testen |
Eine sinnvolle Reihenfolge ist, zunächst eine Standardstimme im Wiseguy-Stil an einem kleinen Segment Ihres Publikums zu testen. Wenn das Engagement steigt und der Tonfall zu Ihrer Marke passt, erwägen Sie, Ihre eigene Persona für die langfristige Differenzierung zu klonen. Nutzen Sie dann mehrsprachige TTS und KI-Dubbing, um diese Persona über lokalisierte Kanäle zu replizieren, wobei Sie jedes Skript kulturell abstimmen, statt es Wort für Wort zu übersetzen. Da DubSmart diese Tools an einem Ort bündelt, zwingt Sie das Aufrechterhalten einer konsistenten Charakterstimme über Erzählung und Dubbing hinweg nicht dazu, mit separaten Apps zu jonglieren. Ein kreditbasiertes Modell mit einer kostenlosen Stufe gibt Ihnen zudem Raum, in kleinem Maßstab zu experimentieren, bevor Sie die Nutzung hochfahren.
Risiken und Schutzmaßnahmen, die es sich lohnt einzubauen
Ein ausdrucksstarker Stimmstil birgt echte Nachteile, wenn Sie ihn unbedacht einsetzen.
Markenmissausrichtung ist der häufigste Fehler: übermäßig sarkastische Wiedergabe untergräbt das Vertrauen bei sensiblen Themen. Kulturelle Fehltritte sind der nächste, denn Humor und „Wiseguy"-Attitüde lassen sich selten wörtlich übersetzen; was in einem Markt spielerisch wirkt, kann in einem anderen unhöflich klingen. Stimmrechte sind beim Klonen am wichtigsten. Modellieren Sie die Stimme einer realen Person nur mit klarer, dokumentierter Genehmigung, was für kommerzielle Projekte entscheidend ist. Und synthetische Stimmen können für Identitätsbetrug oder irreführende Inhalte missbraucht werden, wenn keine interne Richtlinie sie regelt.
Die Schutzmaßnahmen sind unkompliziert. Schreiben Sie Markentonrichtlinien, damit die Persona Grenzen hat. Verwenden Sie geklonte Stimmen nur unter ausdrücklichen Vereinbarungen mit dem Sprecher. Prüfen Sie Skripte auf kulturelle Sensibilität vor jeder mehrsprachigen Einführung. Und halten Sie Wiseguy-Stimmen aus Inhalten heraus, bei denen Neutralität und Autorität der ganze Sinn sind.
Wie verschiedene Creator es einsetzen
Für YouTube-Creator eignet sich eine Wiseguy-Stimme gut als wiederkehrender Kanal-Erzähler für Intros, Kommentare und Sponsor-Reads, während Ihre On-Camera-Präsenz für Schlüsselsegmente reserviert bleibt. Dieselbe Stimme kann dann mit den integrierten Tools in andere Sprachen gedubbt werden. Wenn Sie diese Expansion planen, führt Sie unser Ratgeber zum Aufbau eines mehrsprachigen YouTube-Kanals durch den umfassenderen Workflow.
Für kleine Unternehmen und Marketingteams verleiht die Persona Produkterklärvideos und Social Ads einen einprägsamen Twist. Generieren Sie englische Voiceovers über TTS und lokalisieren Sie dann Kampagnen, indem Sie dieselbe Stimme oder ein kulturell abgestimmtes Äquivalent in anderen Sprachen wiederverwenden.
Für E-Learning- und Corporate-Training-Produzenten reservieren Sie den Stil für informelle Module, schnelle Tipps und Engagement-Booster und behalten neutrale Stimmen für Compliance- und Richtlinieninhalte bei. Diese Aufteilung hält die Aufmerksamkeit, ohne die Ernsthaftigkeit dort zu gefährden, wo sie zählt. Unsere Übersicht darüber, was Medienlokalisierung beinhaltet, ist eine nützliche Einführung, wenn Sie eine mehrsprachige Schulungsbibliothek aufbauen.
Für Filmemacher und Podcast-Creator lässt das Klonen der Stimme eines bestimmten Charakters diese zu einer charakteristischen Präsenz in Trailern, Teasern und Behind-the-Scenes-Clips werden. Für Entwickler und Agenturen ermöglicht das Einbinden der TTS-API in Ihre Pipeline, dass ein einzelner Erzähler dynamische Texte aus Datenbanken oder nutzergenerierten Inhalten jedes Mal mit einer konsistenten Identität liest.
Häufig gestellte Fragen
Was ist Wiseguy-Text-to-Speech in DubSmart?
Es ist KI-generierte Sprache, bei der Sie eine Stimme wählen oder klonen, die wie ein geistreicher, selbstbewusster Erzähler klingt, und dann unsere Text-to-Speech nutzen, um Skripte in dieser Persona in Audio zu verwandeln. Sie stützt sich auf standardmäßige TTS und Voice-Cloning statt auf eine separate Technologie.
Kann DubSmart Wiseguy-Stimmen in mehreren Sprachen bewältigen?
Ja. Unsere Text-to-Speech und verwandte Tools unterstützen Inhalte in mehr als 33 Sprachen, sodass eine Stimme im Wiseguy-Stil über internationale Kanäle laufen kann. Lokalisieren Sie Slang und Humor je Markt, statt sie wörtlich zu übersetzen.
Brauche ich viel Audio, um eine Wiseguy-Stimme zu klonen?
Nein. Voice-Cloning ist so konzipiert, dass es mit kurzen Aufnahmen funktioniert. Rund 20 Sekunden sauberer Sprache reichen aus, um ein benutzerdefiniertes Stimmprofil zu erstellen, das Sie sowohl in Text-to-Speech als auch in KI-Dubbing wiederverwenden können.
Können Entwickler Wiseguy-Erzählung programmatisch auslösen?
Ja. Unsere Text-to-Speech-API akzeptiert POST-Anfragen mit Text und Stimmpräferenzen und gibt natürlich klingende Sprache zurück. Sie können entweder eine Standardstimme oder eine geklonte Persona anhand ihrer ID referenzieren.
Gibt es einen risikoarmen Weg, dies zuerst auszuprobieren?
Ein kreditbasiertes Modell mit einer kostenlosen Stufe lässt Sie den Stil an Beispielvideos oder Kampagnen testen, bevor Sie größere Budgets festlegen, was zu Creatorn, kleinen Unternehmen und Agenturen passt, die mit Stimm-Personas experimentieren.