Ein Standbild friert einen Moment ein, kann aber nicht zeigen, wie sich dieser Moment bewegt hat. Genau diese Lücke füllt Image-to-Video-KI. Wenn Sie sich fragen, was Image-to-Video-KI ist, lautet die kurze Antwort: Es handelt sich um eine generative Medientechnologie, die ein einzelnes statisches Bild – ein Foto, eine Illustration, eine Produktaufnahme oder ein KI-generiertes Kunstwerk – aufnimmt und es zu einem kurzen Videoclip animiert, indem sie neue Einzelbilder erfindet, die scheinbare Bewegung, Kamerabewegung und manchmal Ton erzeugen. Sie liefern ein Bild, beschreiben, was passieren soll, und das Modell sagt die Zwischenbilder voraus und rendert sie.
Das klingt einfach, doch die Entscheidung dahinter lautet nicht nur „Kann dieses Tool einen coolen Clip erstellen". Es geht darum, ob die erzeugte Bewegung Ihrer Quelle treu bleibt, zu Ihrer Plattform passt und eine Marken- oder Genauigkeitsprüfung übersteht. Dieser Leitfaden erklärt den Mechanismus, was Sie steuern können, wo es in eine echte Produktion passt und wie wir Image to Video innerhalb von DubSmart AI als eine Phase eines größeren Medien-Workflows handhaben.
Inhaltsverzeichnis
Wie sich Image-to-Video-KI von ähnlichen Technologien unterscheidet
Die Verwirrung beginnt meist hier, denn mehrere Tools klingen ähnlich, erfüllen aber unterschiedliche Aufgaben. Image-to-Video-KI generiert eine Abfolge neuer Einzelbilder, sodass ein statisches Bild sich im Laufe der Zeit zu bewegen scheint. Dieses eine Unterscheidungsmerkmal grenzt sie von allem ab, womit sie verwechselt wird.
- Text-to-Video erstellt einen Clip allein aus einer schriftlichen Beschreibung, ohne Ausgangsbild.
- Bildanimation wendet einfachere Effekte an – Zoom, Schwenk, Parallaxe – ohne wirklich neue Motivbewegung zu synthetisieren.
- Diashow-Erstellung durchläuft mehrere Standbilder, erzeugt aber niemals kontinuierliche Bewegung innerhalb eines Einzelbilds.
- Video-to-Video stilisiert oder bearbeitet bereits vorhandenes Filmmaterial um, anstatt von einem Bild auszugehen.
Eine Diashow, die von Foto A zu Foto B wechselt, ist also kein Image-to-Video. Ebenso wenig ein Ken-Burns-artiger Schwenk über ein einzelnes Bild. Das entscheidende Merkmal ist die Frame-Synthese: Das Modell erzeugt Bewegung, die nie aufgenommen wurde, verankert an dem einen Einzelbild, das Sie bereitgestellt haben.
Wenn Synchronisation, Transkription und Lokalisierung an anderer Stelle in Ihrem Stack liegen, zeigt unser Beitrag zu All-in-One-KI-Video-Tools nach Anwendungsfall, wo Image-to-Video neben diesen Aufgaben passt.
Wie die Generierung tatsächlich funktioniert
Anbieter nutzen unterschiedliche Modelle, aber die Pipeline lässt sich auf vier zusammenhängende Fähigkeiten reduzieren. Sie zu verstehen erklärt, warum manche Clips nahtlos aussehen und andere verzerren.
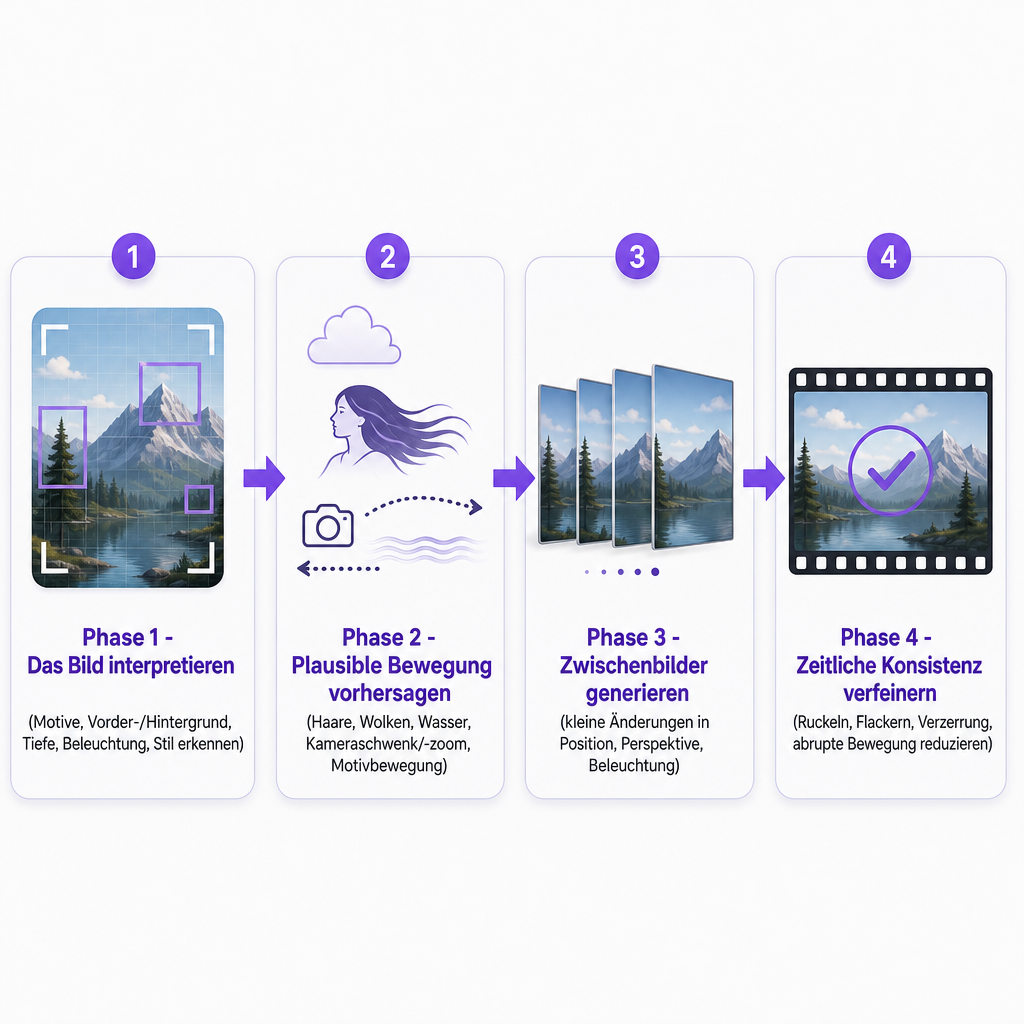
Zuerst interpretiert es das Bild. Das Modell untersucht den Upload, um Personen, Tiere, Produkte und Objekte zu identifizieren, trennt dann Vorder- und Hintergrund und schätzt relative Position, Tiefe, Beleuchtung und visuellen Stil. Das Bild wird zu einer funktionalen Darstellung einer Szene statt einer flachen Oberfläche.
Als Nächstes sagt es plausible Bewegung voraus. Aus dieser Darstellung schätzt das Modell, wie sich die Szene verändern könnte: wie sich Haare oder Stoff bewegen könnten, wie sich Wolken, Rauch, Wasser oder Blätter bewegen könnten, wie Licht über ein Objekt wandern könnte und wie eine Kamera schwenken, neigen, zoomen oder hineinfahren könnte. Diese Vorhersagen sind keine Aufzeichnung von etwas, das passiert ist. Es sind erzeugte Möglichkeiten, abgeleitet aus dem Bild, Ihrem Prompt und im Training erlernten Mustern.
Es erzeugt die Einzelbilder dazwischen. Das System rendert eine Reihe von Einzelbildern mit kleinen Änderungen in Position, Perspektive, Beleuchtung oder Form. Nacheinander abgespielt lesen sich diese Einzelbilder als kontinuierliche Bewegung. Das ist der Kern: Das Tool enthüllt kein verborgenes Filmmaterial, sondern synthetisiert, was zwischen Momenten erscheinen könnte, die nie gefilmt wurden.
Zuletzt verfeinert es die zeitliche Konsistenz. Schließlich glättet das Modell Übergänge, um Ruckeln, Flackern, plötzliche Lichtwechsel, verzerrte Objekte, inkonsistente Gesichter und abrupte Kamerabewegungen zu unterdrücken. Wie gut das gelingt, hängt vom Modell, vom Quellbild, vom Prompt und von der Komplexität der angeforderten Aktion ab. Je mehr Sie das Modell erfinden lassen, desto schwerer arbeitet diese Phase.
Was Sie steuern können und was das Quellbild entscheidet
Die besten Ergebnisse entstehen, wenn man Bewegung steuert, nicht wenn man das ganze Bild in Prosa umschreibt. Ein zuverlässiger Prompt benennt vier Dinge: Motiv, Aktion, Kamerabewegung und visuellen Stil.
Eine Keramik-Kaffeetasse auf einem Holztisch, sanft aufsteigender Dampf, langsame Kamerafahrt nach vorne, warmes Morgenlicht, realistisches Produktvideo.
Von da an können Sie in der Regel Motivbewegung (geht, dreht sich, rotiert, erhebt sich), Umgebungsbewegung (Wind, Regen, Rauch, fallende Blätter), Kamerabewegung (Schwenk, Neigung, Dolly hinein oder heraus, Handheld, statisch), Tempo (sanft bis rasant), Stimmung (filmisch, dokumentarisch, beruhigend) und Ausgabeformat (Querformat, quadratisch, Hochformat) festlegen. Wir empfehlen, den ersten Prompt einfach zu halten und sich auf die Bewegung zu konzentrieren, die Sie wirklich wollen.
Der Haken ist, dass Ihr Prompt zu dem passen muss, was das Bild unterstützen kann. Ein Porträt wirkt in der Regel natürlich mit subtiler Gesichts- oder Kamerabewegung und unnatürlich, wenn Sie das Motiv sprinten lassen. Eine Landschaft liest sich oft besser mit einem langsamen Schwenk oder Umgebungsbewegung als mit rasanter Motivaktion. Eine Produktaufnahme bevorzugt meist eine kontrollierte Rotation, einen Lichtstreif oder eine allmähliche Enthüllung. Jeder Grad dramatischer Bewegung zwingt das Modell, mehr visuelle Information zu erfinden – und beim Erfinden treten Artefakte auf.
Deshalb trägt das Quellbild so viel Gewicht. Es bestimmt Motiv, Komposition, Beleuchtung und Stil, mit denen das Modell arbeiten muss. Für stärkere Ergebnisse beginnen Sie mit einem klaren, erkennbaren Motiv, guter Beleuchtung, scharfen Details, minimalen Artefakten, einer bewussten Komposition, genügend freiem Raum für die gewünschte Bewegung und deutlichen Vorder- und Hintergrundebenen. Ein überfülltes, unscharfes oder stark beschnittenes Bild gibt dem Modell weniger, mit dem es arbeiten kann – ein eng auf ein Gesicht gefasstes Bild lässt selten Raum für eine weite Kamerabewegung. Eine starke Quelle garantiert keinen perfekten Clip, bietet dem Modell aber einen weitaus besseren Ausgangspunkt. Wenn Sie diese Standbilder von Grund auf erzeugen, kann unser KI-Bildgenerator sie produzieren, bevor Sie animieren.
Wo Creator und Teams es tatsächlich einsetzen
Image-to-Video verdient seinen Platz, wenn die Bewegung der Botschaft dient, nicht wenn sie Dekoration um ihrer selbst willen ist.
- Social Media. Verwandeln Sie Fotos, Thumbnails, Illustrationen oder generierte Kunstwerke in kurze Clips für Shorts, Reels und TikTok. Hochformat zählt am meisten, wenn das Originalbild für Mobilgeräte erstellt wurde.
- Produktmarketing. Animieren Sie ein Produktbild mit einem subtilen Zoom, einer Rotation, einem Lichtwechsel oder Hintergrundbewegung, damit ein statisches Asset in einer Anzeige auffällt.
- YouTube und Videoproduktion. Nutzen Sie Clips als Intros, Outros, B-Roll, Establishing-Shots, Übergänge oder Hintergrundsequenzen hinter einer Erzählung – und legen Sie dann Voiceover, Musik, Untertitel oder Synchronisation darüber.
- E-Learning und Schulung. Fügen Sie Diagrammen, historischen Bildern und Präsentationsgrafiken Bewegung hinzu, aber nur dort, wo die Bewegung eine Idee verdeutlicht.
- Storyboarding und Konzeptarbeit. Animieren Sie Standbilder, um Stimmung, Bildausschnitt und Kameraführung zu erkunden, bevor Sie sich für einen vollständigen Dreh entscheiden.
- Immobilien und Reisen. Verwandeln Sie ein gut gewähltes Objekt- oder Reiseziel-Bild in einen kurzen atmosphärischen Clip – ohne Merkmale anzudeuten, die der reale Ort nicht hat.
In jedem Fall ist der Clip eine Komponente. Ein YouTube-Creator könnte mehrere Illustrationen animieren, sie in einem Editor zusammensetzen, eine Erzählung generieren und das fertige Video für andere Märkte lokalisieren.
Unsere Image-to-Video-Optionen bei DubSmart AI
Unser Image to Video-Generator verwendet das hochgeladene Bild als erstes Einzelbild, wodurch die Eröffnungskomposition und der visuelle Stil festgelegt werden. Sie fügen einen Text-Prompt hinzu, der Motivbewegung, Kamerawinkel oder Szenendynamik beschreibt, wählen Dauer und Qualität und laden den Clip herunter.
| Option | Unser Angebot |
|---|---|
| Cliplänge | 4, 6 oder 8 Sekunden |
| Qualitätsstufen | Standard, Hoch, Ultra Hoch |
| Audio | Hoch und Ultra Hoch enthalten Ton |
| Querformate | 1280×720 und 1920×1080 |
| Quadratisches Format | 1024×1024 |
| Hochformat | 720×1280 |
| Eingabe | Ein hochwertiges Bild plus ein Bewegungs-Prompt |
Wir haben das Tool für Social Media, Werbung, künstlerische Projekte und größere Videoproduktionen entwickelt. Für konkrete Preise oder den Credit-Verbrauch prüfen Sie die aktuellen Angaben in Ihrem DubSmart-Konto oder in Ihren Tarifinformationen, bevor Sie eine Produktion kalkulieren, da diese Details bei Ihrem Tarif liegen und nicht auf der öffentlichen Tool-Seite.
Wie Sie das richtige Tool für die Aufgabe wählen
Das richtige Tool hängt von den Inhalten ab, die Sie ausliefern müssen, nicht davon, ob es eine beeindruckende Demo produzieren kann. Einige Kriterien trennen eine Spielerei von etwas, das Sie in einem wiederholbaren Workflow nutzen können.
Steuerung des Quellbilds. Prüfen Sie, ob das Tool Ihr Bild als striktes erstes Einzelbild, als lockere Referenz oder nur als Stilvorgabe behandelt. Ein Erstes-Einzelbild-Ansatz hält die Eröffnungskomposition an Ihre Quelle gebunden – nützlich, wenn die Eröffnungsaufnahme wichtig ist.
Bewegungssteuerung. Achten Sie auf klare Unterstützung für Motivbewegung, Kamerabewegung, Umgebungseffekte, Geschwindigkeit und Stil. Attraktive, aber unvorhersehbare Bewegung ist schwer zu reproduzieren, wenn Sie Konsistenz über mehrere Clips hinweg benötigen.
Dauer und Formate. Passen Sie verfügbare Dauern und Seitenverhältnisse an Ihr Ziel an. Kurze Clips eignen sich für Social-Posts, Anzeigen, Übergänge und Einschübe; stellen Sie sicher, dass die Hochformat-, Quadrat- und Querformat-Optionen zu dem passen, wo der Clip laufen wird.
Audio. Entscheiden Sie, ob Sie ein stummes Bild für spätere Bearbeitung, Umgebungsgeräusche, Musik, Effekte oder einen vollständig generierten Track benötigen. Generiertes Audio sollte vor der Veröffentlichung dennoch auf Timing und Relevanz geprüft werden.
Konsistenz. Wenn ein Gesicht, Produkt, Logo oder eine Figur durchgehend identisch bleiben muss, testen Sie zuerst mehrere Generierungen. Modelle können kleine Details – Hände, Text innerhalb eines Bildes, Logos, architektonische Linien – unbemerkt verändern, während sie Einzelbilder synthetisieren.
Bearbeitungskompatibilität. Stellen Sie sicher, dass Sie ein praktisches Format in der richtigen Auflösung herunterladen, es mit Live-Action-Material kombinieren und Untertitel, Erzählung oder Synchronisation hinzufügen können, ohne den Bildausschnitt zu verlieren, den Ihr Editor benötigt. Für Teams, die bereits Sprach- und lokalisierte Medien mit uns produzieren, fügt sich Image to Video in einen Workflow ein, statt ein weiteres eigenständiges Tool hinzuzufügen.
Grenzen, Risiken und Rechte, die Sie nicht übergehen können
Image-to-Video-KI rekonstruiert kein echtes Filmmaterial aus einem Standbild. Sie erzeugt eine plausible Interpretation von Bewegung, und diese Unterscheidung bestimmt jede Einschränkung, die eingeplant werden sollte.
Gesichter, Finger, Text, Logos und Produktdetails können sich zwischen Einzelbildern verschieben, also prüfen Sie den gesamten Clip, statt die erste Vorschau zu beurteilen. Das Modell kann auch Tiefe, Objektgrenzen oder Ursache und Wirkung falsch interpretieren – und so unnatürliche Bewegung, sich biegende Objekte oder eine Kamerabewegung erzeugen, die erfundene Details enthüllt. Vage Prompts wie „beweg es" geben fast keine Richtung vor; konkrete Beschreibungen von Motiv, Bewegung, Kamera und Stimmung leiten das Modell weitaus besser. Und weil die Technologie bei kurzen Clips am stärksten ist, funktioniert eine generierte Sequenz gut als Einschub oder Social-Asset, ersetzt aber keine vollständig gefilmte Szene.
Die Risiken, die am meisten zählen, sind ethischer und rechtlicher Natur. Ein generierter Clip sollte niemals andeuten, dass eine Person eine Handlung ausgeführt hat, dass ein Produkt eine Funktion besitzt oder dass sich ein realer Ort verändert hat, wenn nichts davon geschehen ist – eine Grenze, die besonders in Werbung, Nachrichten, Bildung und Kundenkommunikation zählt. In Bezug auf Rechte: Verwenden Sie nur Bilder, für die Sie die Erlaubnis zur Verarbeitung und Veröffentlichung haben, und seien Sie vorsichtig bei Fotos identifizierbarer Personen, Markenassets, urheberrechtlich geschützten Kunstwerken, kundeneigenen Materialien, privaten Informationen, Prominenten-Abbildern und KI-generierten Bildern mit unklaren Nutzungsbedingungen. Das Transformieren einer Eingabe verleiht Ihnen keine Rechte an der Eingabe oder dem resultierenden Video.
Häufig gestellte Fragen
Was ist Image-to-Video-KI einfach erklärt?
Es ist KI-Software, die ein Standbild in ein kurzes bewegtes Video verwandelt, indem sie neue Einzelbilder auf Grundlage des Bildes und einer von Ihnen bereitgestellten Bewegungsanweisung erzeugt.
Kann Image-to-Video-KI Ton hinzufügen?
Einige Tools erzeugen Ton, während andere stummes Video für die spätere Bearbeitung produzieren. Unsere Qualitätsoptionen Hoch und Ultra Hoch enthalten Ton; prüfen Sie generiertes Audio vor der Veröffentlichung auf Timing und Relevanz.
Welche Bilder funktionieren am besten?
Klare, gut ausgeleuchtete Bilder mit einem erkennbaren Motiv, deutlichen Vorder- und Hintergrundbereichen, scharfen Details und minimalen Artefakten geben dem Modell einen stärkeren Ausgangspunkt als überfüllte oder unscharfe Quellen.
Wie lang sind die Image-to-Video-Clips von DubSmart AI?
Wir bieten Dauern von 4, 6 und 8 Sekunden in Quer-, Quadrat- und Hochformat an.
Kann ich Hochformat-Videos für TikTok oder YouTube Shorts erstellen?
Ja. Wir führen ein Hochformat 720×1280 neben Quadrat- und Querformat-Auflösungen auf, sodass Clips zu Mobile-First-Plattformen passen.
Ist Image-to-Video-KI für Business-Inhalte geeignet?
Sie kann für Anzeigen, Produktvisualisierungen, Schulungen, Social-Content und Konzeptentwicklung funktionieren, sofern Sie die Ausgabe vor der Veröffentlichung auf Genauigkeit, Markenkonsistenz, Rechte, Einwilligung und etwaige irreführende visuelle Aussagen prüfen.