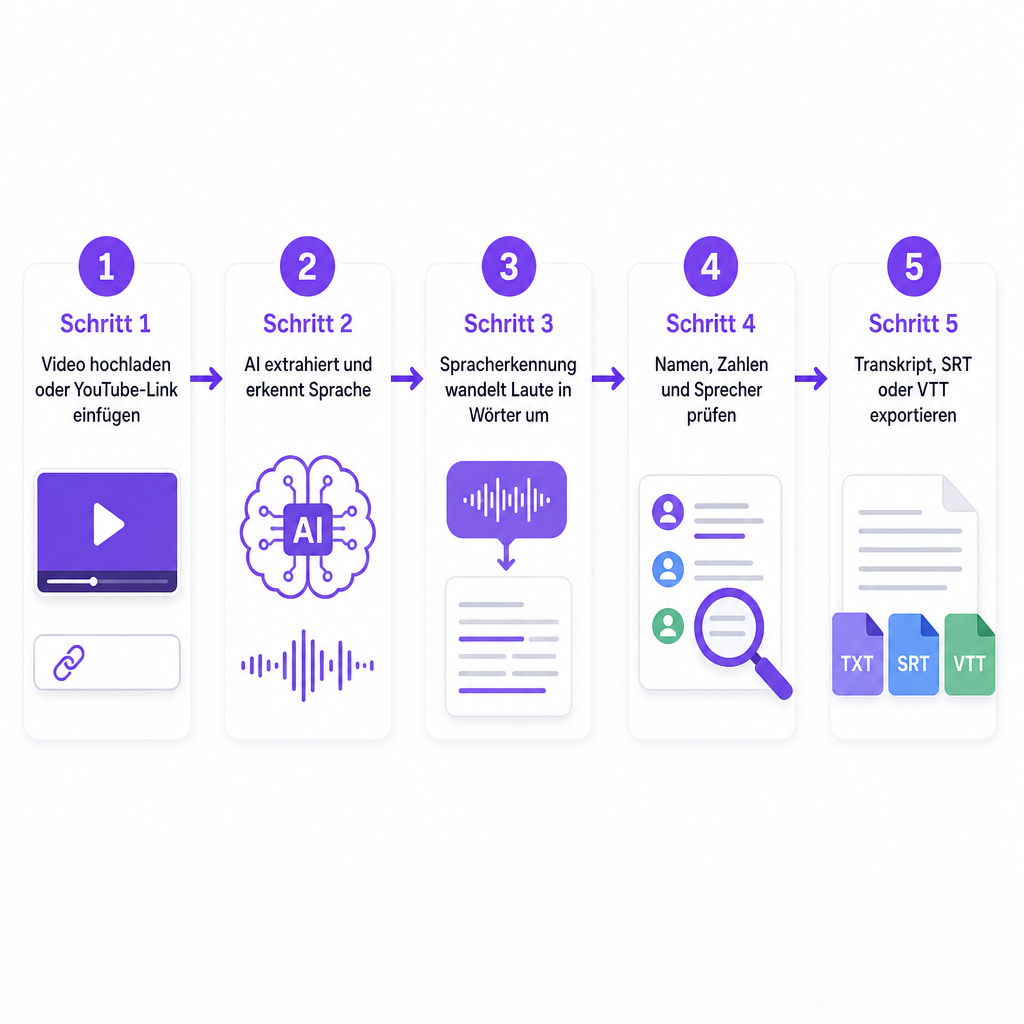
Der schnellste Weg, ein Video in Text zu transkribieren, besteht darin, ein KI-Speech-to-Text-Tool den ersten Durchgang erledigen zu lassen: Laden Sie die Videodatei hoch oder fügen Sie einen YouTube-Link ein, lassen Sie das System das gesprochene Audio in ein bearbeitbares Transkript umwandeln und überprüfen Sie dann die Stellen, bei denen Fehler am wahrscheinlichsten sind. Dieser letzte Schritt ist wichtiger, als die meisten Menschen erwarten, denn „schnell“ sollte ein zügiges erstes Transkript plus eine kurze Qualitätskontrolle bedeuten, nicht sofortige Perfektion. Manuelles Tippen hingegen bedeutet, jede Zeile anzuhalten, zurückzuspulen und neu zu tippen – und genau dort verschwinden die Stunden.
Wenn Sie die praktische Version davon möchten, wie man ein Video in Text transkribiert, akzeptiert unser Speech to Text-Workflow Video-Uploads und YouTube-Links, lässt Sie das entstehende Projekt bearbeiten, unterstützt mehr als 60 Sprachen und verarbeitet Dateien bis zu 5 GB ohne angegebene Begrenzung der Videolänge. Der Rest dieses Leitfadens erklärt den dahinterstehenden Mechanismus, wie Sie die richtige Ausgabe wählen und wie Sie eine hohe Genauigkeit beibehalten, wenn das Audio sich wehrt.
Inhaltsverzeichnis
Was es tatsächlich bedeutet, ein Video in Text zu transkribieren
Die Videotranskription wandelt das gesprochene Audio in einem Video in geschriebene Worte um. Diese eine Ausgabe kann vielen Zwecken dienen: einem vollständigen Videotranskript, Untertiteln oder Closed Captions, einem Bearbeitungsskript, einem Blog- oder Newsletter-Entwurf, durchsuchbaren Aufzeichnungen von Besprechungen und Vorlesungen oder Ausgangstext, den Sie später für neue Zielgruppen übersetzen.
Es hilft, drei Begriffe zu unterscheiden, die oft verschwimmen. Transkription behält die ursprünglich gesprochene Sprache in Textform. Übersetzung wandelt diesen Inhalt in eine andere Sprache um. Dubbing ersetzt oder ergänzt gesprochenes Audio in einer anderen Sprache. Sie transkribieren zuerst und entscheiden dann, ob Übersetzung oder Dubbing der nächste Schritt ist. Wenn Sie die tiefergehende Definition der Erkennungstechnologie hinter all dem möchten, behandelt unser Leitfaden dazu, wie Speech-to-Text funktioniert, die Grundlagen.
Wie KI-Videotranskription unter der Haube funktioniert
Die Pipeline zu kennen hilft Ihnen vorherzusagen, woher Fehler kommen. Die meisten automatischen Transkriptionssysteme durchlaufen dieselben Phasen. Zuerst liest das System die Audiospur im Video. Als Nächstes erkennt es, welche Abschnitte tatsächlich Sprache enthalten. Ein Erkennungsmodell ordnet dann Klangmuster Wörtern zu, und ein Sprachverarbeitungsschritt nutzt den umgebenden Kontext, um diese Vorhersagen zu verbessern. Die erkannten Wörter werden zu Sätzen oder zeitlich abgestimmten Segmenten zusammengesetzt, und schließlich korrigieren und exportieren Sie das Ergebnis.
Das Erkennungsmodell ist nur ein Teil der Qualitätsgleichung. Mikrofonqualität, sich überlappende Sprecher, Akzente, Hintergrundmusik, Raumhall, Fachvokabular und Unterbrechungen prägen alle die Ausgabe. Unser Speech-to-Text-System ist darauf ausgelegt, laute Umgebungen, mehrere Sprecher sowie verschiedene Sprachen und Dialekte zu bewältigen, mit der ehrlichen Einschränkung, dass die Genauigkeit je nach Audioqualität und Akzentvielfalt variiert. Diese Einschränkung ist der Grund, warum es den Prüfdurchgang gibt – kein Fehler, den man verstecken müsste.
Transkript, Captions oder Untertitel: die richtige Ausgabe wählen
Das beste Exportformat hängt ganz davon ab, wofür der Text gedacht ist, und die falsche Wahl verschwendet später Zeit.
Ein einfaches Transkript ist lesbarer Text ohne erforderliches Timing. Greifen Sie darauf zurück, wenn Sie Recherchenotizen, Besprechungsaufzeichnungen, ein Videoskript, einen Blog- oder Newsletter-Entwurf oder Inhalte zur Wiederverwertung benötigen. Zeitstempel sind hier optional, helfen aber Bearbeitern, hin- und herzuspringen.
Captions synchronisieren Text mit dem Video und können relevante nicht-sprachliche Informationen wie Musik, Applaus oder das Zuschlagen einer Tür enthalten. Sie sind wichtig für die Barrierefreiheit und für alle, die ohne Ton zuschauen. Untertitel zeigen in der Regel gesprochene Dialoge für Zuschauer an, die die Sprache nicht verstehen. Wenn Sie Untertitel in einer anderen Sprache benötigen, transkribieren Sie zuerst das Original, übersetzen dann und timen den übersetzten Text.
Für zeitlich abgestimmte Formate ist WebVTT ein Webstandard für zeitlich abgestimmte Texttracks; die W3C-WebVTT-Spezifikation beschreibt es als ein Format für Captions, Untertitel, Kapitel, Beschreibungen und andere Metadaten, die mit Audio oder Video synchronisiert sind. Für YouTube-Uploads gehören sowohl SubRip .srt als auch .vtt zu den unterstützten Untertitelformaten, und YouTube weist darauf hin, dass einfache .srt-Dateien reine UTF-8-Kodierung verwenden müssen.
Reinigen Sie das Audio, bevor Sie verrauschte Videos transkribieren
Hintergrundgeräusche sind eine der häufigsten Ursachen für Transkriptionsfehler. Straßengeräusche, Klimaanlagen, Mikrofonrückkopplungen, konkurrierende Musik und Raumhall verwischen alle die Grenzen zwischen Wörtern, und das Erkennungsmodell hat weniger Signal, mit dem es arbeiten kann.
Die Lösung besteht darin, die Sprache vor der Transkription zu isolieren. Unser Speech Separator entfernt Hintergrundgeräusche und trennt gesprochene Worte vom umgebenden Audio und unterstützt gängige Formate wie MP3, WAV und AAC sowie Videodateien. Er verdient seinen Platz im Workflow bei im Freien aufgenommenen Interviews, in akustisch unbehandelten Räumen aufgenommenen Podcasts, Videos mit starker Hintergrundmusik, Podiumsdiskussionen mit ungleichmäßigen Mikrofonpegeln und Archivmaterial mit Brummen oder Umgebungsgeräuschen.
Eine Warnung für die Barrierefreiheitsarbeit: Entfernen Sie nicht reflexartig jedes Geräusch. Wenn ein Geräusch eine Bedeutung trägt, etwa eine Sirene, ein Alarm oder eine Lautsprecherdurchsage, muss es möglicherweise dennoch in den Captions dargestellt werden, auch wenn es aus der bereinigten Sprachspur ausgeschlossen wird, die Sie zur Transkription senden.
Wie Sie die Transkriptionsgenauigkeit verbessern
Behandeln Sie die KI-Transkription als einen starken ersten Entwurf und wenden Sie dann gezielte Kontrollen an, anstatt alles blind erneut zu lesen.
Beginnen Sie mit der klarsten Quelldatei. Laden Sie die Originalaufnahme hoch statt eines komprimierten Social-Media-Downloads, da ein saubereres Sprachsignal dem Modell mehr zum Arbeiten gibt. Reduzieren Sie konkurrierendes Audio, indem Sie Hintergrundmusik verringern oder entfernen, und verwenden Sie die sauberste verfügbare Sprachspur, wenn das Video mehrere getrennte hat. Wählen Sie die Sprache oder den Dialekt, die zur Aufnahme passen, wenn die Option vorhanden ist, was dem System hilft, Aussprache, Rechtschreibung und Satzstruktur zu interpretieren.
Gehen Sie dann die vorhersehbaren Fehlerstellen an. Durchsuchen Sie das Transkript nach Eigennamen wie Namen, Marken, Orten, Produktbegriffen und Fachjargon, anstatt einem allgemeinen Durchlesen zu vertrauen. Überprüfen Sie Sprecherwechsel und fügen Sie manuell Sprecherbezeichnungen hinzu, wenn das Transkript für rechtliche, bildungsbezogene, forschungsbezogene oder redaktionelle Zwecke verwendet wird. Verifizieren Sie kurze, bedeutungskritische Elemente: Daten, Preise, Prozentsätze, Maßangaben, URLs, Akronyme, Verneinungen wie „nicht“ und ähnlich klingende Wörter, denn ein einziger Fehler kann einen Satz ins Gegenteil verkehren.
Die zuverlässigste Methode besteht darin, das Video abzuspielen und dabei dem Transkript zu folgen. Springen Sie bei einer langen Aufnahme zuerst zu Abschnitten mit Namen, Zahlen, unklarem Audio oder sich überlappenden Stimmen. Dies spiegelt eine verinnerlichenswerte Warnung wider: Automatische Captions können Sprache falsch wiedergeben, aufgrund von Fehlaussprachen, Akzenten, Dialekten und Hintergrundgeräuschen.
Den Workflow an Ihren Inhaltstyp anpassen
Verschiedene Formate beanspruchen unterschiedliche Teile des Prozesses, also passen Sie an, wo Sie Prüfzeit aufwenden.
Bei YouTube-Videos speist ein Transkript Captions, Beschreibungen, Kapitel, Clip-Auswahl und suchorientierte Wiederverwertung; verwenden Sie den Original-Upload oder eine hochwertige Quelle, wenn Ihnen das Video gehört. Interviews und Podcasts benötigen normalerweise Sprecherbezeichnungen und eine stärkere Rauschbehandlung, also reinigen Sie zuerst das Audio aus geschäftigen Umgebungen und halten Sie die Sprecheridentität konsistent. E-Learning- und Schulungsvideos sollten Genauigkeit bei Anweisungen, Terminologie, Zahlen und Verweisen auf dem Bildschirm priorisieren, mit Captions, die eng genug synchronisiert sind, damit Lernende die Erklärung und den Bildschirm gemeinsam verfolgen.
Geschäftsbesprechungen werden zu durchsuchbaren Aufzeichnungen und Aktionspunkten, aber sensible Gespräche erfordern besondere Sorgfalt: Verifizieren Sie Namen, Entscheidungen, Daten und zugewiesene Verantwortlichkeiten, bevor Sie teilen. Kurzform-Social-Videos wandeln das Transkript oft in Bildschirm-Captions, eine Beitragsbeschreibung oder übersetzte Versionen um, also halten Sie Zeilenumbrüche für Mobilgeräte kurz und stellen Sie sicher, dass Captions keine wichtigen Bildinhalte verdecken.
Wie Sie ein Video-zu-Text-Tool auswählen
Bewerten Sie den gesamten Workflow, nicht nur eine beworbene Genauigkeitszahl. Die Tabelle unten ordnet die Kriterien zu, die tatsächlich Ihre Durchlaufzeit und Ausgabequalität verändern.
| Entscheidungskriterium | Was zu prüfen ist |
|---|---|
| Eingabeunterstützung | Akzeptiert es Ihr Video, Audio oder eine YouTube-URL? |
| Dateibegrenzungen | Was ist die maximale Dateigröße und Videodauer? |
| Sprachabdeckung | Unterstützt es Ihre Sprache, Ihren Dialekt und Akzente? |
| Sprecherbehandlung | Können Sie mehrere Sprecher identifizieren oder trennen? |
| Ausgabeformate | Können Sie einfachen Text, SRT oder VTT exportieren? |
| Integration | Gibt es eine API zur Verarbeitung von Videos im großen Maßstab? |
Unsere öffentliche Speech-to-Text-Seite bestätigt Video- und YouTube-Link-Eingabe, bearbeitbare Projekte, Downloads, Unterstützung für mehr als 60 Sprachen und eine Größenbegrenzung von 5 GB. Wir geben auf dieser Seite nicht an, ob jede Ausgabe Zeitstempel enthält, wie lange Dateien aufbewahrt werden oder ob die Sprecheridentifikation automatisch erfolgt, also bestätigen Sie diese Einzelheiten für Ihren eigenen Workflow, bevor Sie sensible oder umfangreiche Inhalte verwenden. Wenn eine dieser Antworten für Sie entscheidend ist, teilen Sie uns Ihren Dateityp, Ihre Sprache, die Anzahl der Sprecher und die beabsichtigte Ausgabe mit, und wir können Sie zur richtigen Konfiguration führen.
Datenschutz, Rechte und ein sinnvoller Prüfstandard
Ein Transkript kann vertrauliche Geschäftsinformationen, personenbezogene Daten, Kundengespräche, unveröffentlichte Inhalte oder urheberrechtlich geschütztes Material enthalten. Bestätigen Sie vor dem Hochladen, dass Sie die Erlaubnis haben, die Aufnahme zu verarbeiten, dass jede erforderliche Sprecherzustimmung vorliegt und ob das Video vertrauliche oder regulierte Informationen enthält. Prüfen Sie, wie ein Anbieter hochgeladene Dateien und generierte Transkripte speichert und löscht, wer auf das Projekt und die Exporte zugreifen kann und ob Dateien für das Modelltraining verwendet werden dürfen. Denken Sie daran, dass das Transkribieren einer urheberrechtlich geschützten Aufnahme technisch einfach ist, aber keine Erlaubnis gewährt, ihre Inhalte weiterzuverbreiten; Sie benötigen weiterhin die Rechte, um die Quelle, das Transkript, die Captions oder die Übersetzungen zu veröffentlichen.
Kalibrieren Sie die Prüftiefe am Einsatzrisiko. Eine leichte Prüfung eignet sich für Social-Clips, interne Notizen und grobe Ideenfindung: Scannen Sie nach offensichtlichen Fehlern, Namen, Zahlen und fehlenden Sätzen. Eine vollständige Prüfung eignet sich für Kurse, öffentliche Captions, Interviews, Kundenaufzeichnungen, rechtliches Material und alles Veröffentlichte: Hören Sie sich die vollständige Aufnahme an, korrigieren Sie die Formulierung, verifizieren Sie Sprecherbezeichnungen, prüfen Sie Zeitstempel und bestätigen Sie, dass die Captions den Formatregeln der Zielplattform entsprechen. Für die Barrierefreiheit prüfen Sie über den Dialog hinaus, da wichtige Soundeffekte, Sprecherwechsel und bedeutungsvolle Hinweise in den Captions dargestellt werden müssen.
Der effiziente Weg ist jedes Mal derselbe: Beginnen Sie mit dem saubersten Video, das Sie haben, isolieren Sie die Sprache, wenn das Audio schwierig ist, erzeugen Sie ein bearbeitbares Transkript, verifizieren Sie Namen und Zahlen und exportieren Sie das Format, das Ihre Plattform erfordert. Für Teams, die sprachübergreifend arbeiten, ist dieses Transkript auch der natürliche Ausgangspunkt für Übersetzung und Dubbing später.
Häufig gestellte Fragen
Was ist der schnellste Weg, ein Video in Text zu transkribieren?
Verwenden Sie ein automatisches Speech-to-Text-Tool, das das Video direkt akzeptiert oder einen YouTube-Link unterstützt. Laden Sie die klarste Quelle hoch, wählen Sie die richtige Sprache, erzeugen Sie das Transkript und überprüfen Sie dann zuerst die fehleranfälligsten Abschnitte.
Kann ich ein Video transkribieren, ohne manuell zu tippen?
Ja. KI-Speech-to-Text-Tools wandeln gesprochenes Audio automatisch in bearbeitbaren Text um. Sie sollten die Ausgabe dennoch überprüfen, da die Genauigkeit je nach Rauschen, Akzenten, sich überlappender Sprache und Fachvokabular variieren kann.
Kann DubSmart ein langes Video transkribieren?
Ja. Unser Speech-to-Text-Tool akzeptiert hochgeladenes Audio oder Video und YouTube-Links, unterstützt die Bearbeitung und lässt Sie das fertige Projekt herunterladen. Wir geben Unterstützung für mehr als 60 Sprachen und eine Dateibegrenzung von 5 GB an, ohne angegebene Begrenzung der Videolänge; die tatsächliche Verarbeitungszeit variiert je nach Datei und Audio.
Was soll ich tun, wenn das Transkript viele Fehler hat?
Verbessern Sie zuerst das Quellaudio. Entfernen Sie konkurrierende Geräusche mit einem Sprachtrennungs-Tool, bestätigen Sie die ausgewählte Sprache und erzeugen oder bearbeiten Sie dann das Transkript, wobei Sie besonders auf Eigennamen, Zahlen, Akzente und sich überlappende Sprecher achten.
Welches Untertitelformat soll ich verwenden?
Verwenden Sie das Format, das Ihre Plattform erfordert. SRT wird weithin unterstützt, während WebVTT ein weborientiertes Timed-Text-Format ist, und YouTube unterstützt beide unter seinen Untertitelformaten.