Wenn Sie bei comfyui text to speech gelandet sind und eine einzelne Schaltfläche erwarten, die ein Skript in Audio verwandelt, sollten Sie zuallererst wissen, dass ComfyUI überhaupt keine Sprach-Engine ist. Es ist ein knotenbasierter Arbeitsbereich, in dem Sie Text, eine Stimme, ein Modell, eine Sprache und eine Audioausgabe zu einem wiederverwendbaren Graphen verdrahten. Die Sprache selbst stammt von welchem TTS-Knoten auch immer Sie verbinden: einem gehosteten Anbieter, einer offiziellen Partnerintegration oder einem lokalen Modell, das Sie selbst installieren. Die eigentlich wichtige Frage ist also nicht, ob ComfyUI Ihr Skript sprechen kann, denn das kann es, sondern ob ein visueller Graph der richtige Ort für die Arbeit ist, die Sie wiederholen müssen.
Diese Unterscheidung prägt jede weitere Entscheidung auf dieser Seite. ComfyUI belohnt Experimente und multimodale Pipelines, bei denen Erzählung neben Bild-, Video- und Audiogenerierung steht. Ein dediziertes Sprachtool belohnt wiederholbare Produktion, bei der Sie einfach immer wieder saubere Voiceovers benötigen. Nachfolgend erklären wir, wie der Workflow funktioniert, welche Optionstypen es gibt, wie man sie beurteilt und wo sich ein Graph nicht mehr lohnt zu warten.
Inhaltsverzeichnis
Was ComfyUI Text-to-Speech wirklich ist
ComfyUI Text-to-Speech ist die Praxis, einen ComfyUI-Graphen zu verwenden, um geschriebenen Text in eine AUDIO-Ausgabe umzuwandeln. Die offizielle Dokumentation beschreibt ComfyUI als eine Open-Source-, knotenbasierte Anwendung zum Erstellen von Workflows für Bild-, Video-, Audio- und 3D-Generierung, und seine Audioknoten verbinden externe Sprachdienste oder Modelle mit derselben visuellen Arbeitsfläche.
Ein funktionierender Sprachgraph ist klein. Er benötigt eine Text- oder Prompt-Eingabe, einen TTS-Knoten, eine Stimm- oder Referenzaudio-Eingabe, optionale Sprach- und Wiedergabeeinstellungen sowie einen Audio-Vorschau- oder Speicherknoten. Der TTS-Knoten leitet Ihr Skript durch ein Sprachmodell und gibt generiertes Audio zurück, das spätere Knoten verwenden können.
Die praktische Konsequenz ist, dass ComfyUI die Workflow-Ebene ist, nicht das Modell. Die eigentliche Stimme kann von einem gehosteten Anbieter, einem Partner-Audiomodell, einem benutzerdefinierten Drittanbieter-Knoten oder einem lokal installierten System erzeugt werden. Dieses Verständnis dieser Aufteilung hält Ihre Erwartungen korrekt: Sie bauen eine Pipeline zusammen und wählen dennoch die Engine darin aus.
Wie der vierstufige Workflow funktioniert
Lässt man die Knotennamen weg, tut jeder ComfyUI-Sprachgraph dieselben vier Dinge in Reihenfolge.
Zuerst kommt das Skript als Text an. Der TTS-Knoten kann einfachen Text direkt übernehmen, oder der Text kann von einem anderen Knoten einfließen, der ein längeres Skript lädt, übersetzt oder segmentiert. Eine lange Erzählung in logische Abschnitte zu zerlegen, ermöglicht es Ihnen, einen Absatz neu zu generieren, ohne das gesamte Voiceover neu aufzubauen, und hilft Ihnen, unter der Eingabeobergrenze eines Anbieters zu bleiben.
Zweitens wählt der Workflow eine Stimme und ein Modell aus. Je nach Anbieter könnte das ein voreingestellter Sprecher, eine geklonte Stimme, eine Stimm-ID oder eine Referenzaufnahme sein. Die Modellwahl bestimmt auch Geschwindigkeit, Qualität, Ausdrucksspektrum und Kosten. Der HeyGen-Knoten von ComfyUI etwa stellt sowohl heygen-voice-1 als auch ein schnelleres, kostengünstigeres heygen-voice-1-turbo bereit, während der ElevenLabs-Knoten Steuerungen wie Stabilität, Geschwindigkeit und Stil anbietet.
Drittens synthetisiert das Sprachmodell Audio. Moderne neuronale Systeme schätzen Aussprache, Rhythmus, Pausen und Tonhöhenbewegung, anstatt vorab aufgezeichnete Wörter zusammenzufügen, und sie liefern eine Wellenform zurück, die Sie weiterleiten können: in eine Datei gespeichert, mit Musik gemischt, in einen Video-Graphen eingefügt oder mit einem Avatar gepaart.
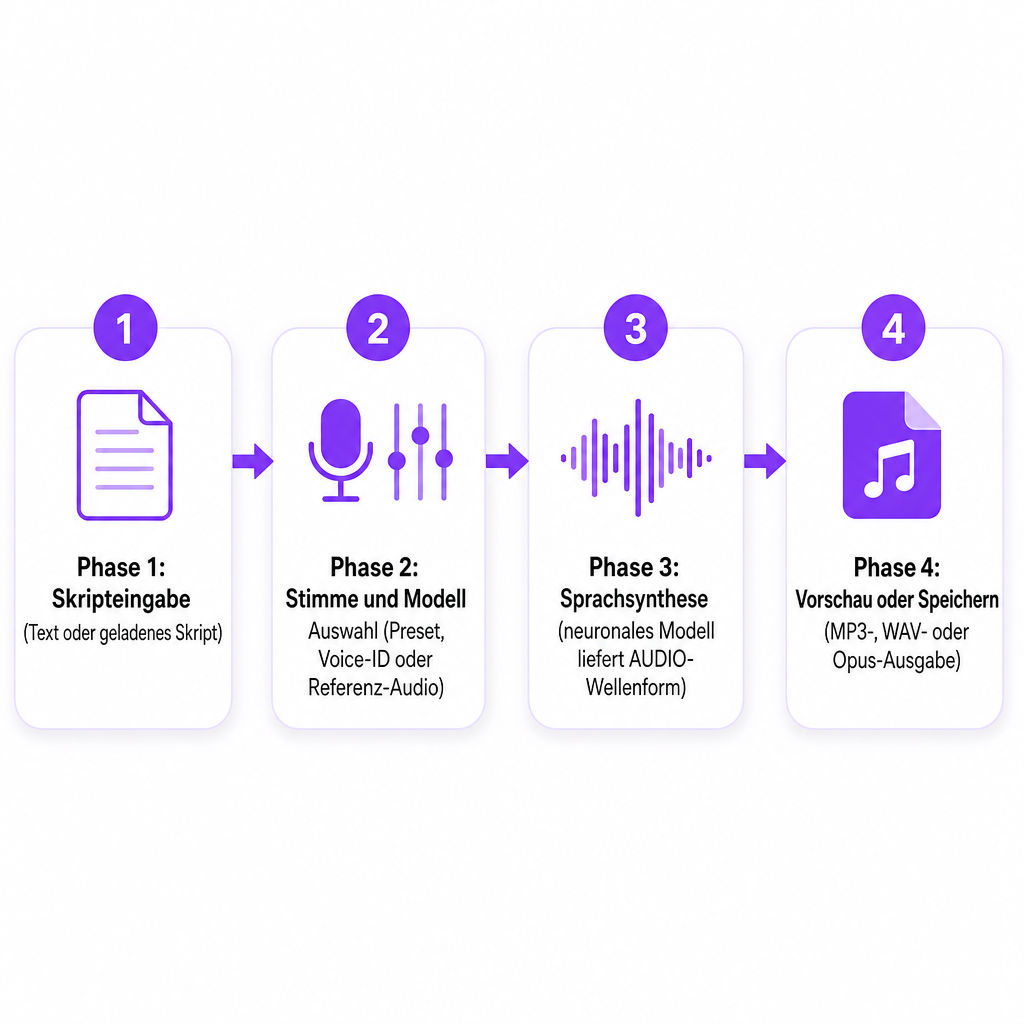
Viertens wird das Audio in der Vorschau angezeigt oder gespeichert. TTS-Knoten geben typischerweise ein AUDIO-Objekt aus, das mit einem Vorschau- oder Speicherknoten verbunden wird, wobei das Dateiformat vom Knoten und Anbieter festgelegt wird; die Dokumentation des ElevenLabs-Knotens listet beispielsweise auswählbare Formate einschließlich MP3- und Opus-Varianten auf. Da der Graph visuell ist, ist die Schleife leicht erneut auszuführen: Ändern Sie Skript, Stimme, Sprache oder Modell und stellen Sie es erneut in die Warteschlange.
Die drei Möglichkeiten, TTS in ComfyUI auszuführen
Es gibt keine einzige ComfyUI-Sprachmethode, und die Unterschiede liegen in Einrichtung, Kontrolle, Datenschutz und wie viel Wartung Sie bereit sind, selbst zu übernehmen.
Gehostete Anbieterknoten senden Ihren Text und Ihre Stimmeinstellungen an einen externen Dienst und geben fertiges Audio zurück. Dies ist meist der schnellste Weg zu hochwertiger Sprache, weil das Modell auf der Infrastruktur des Anbieters läuft. Der HeyGen-Voice-1.0-Knoten veranschaulicht das Muster: Er benötigt eine gültige geklonte Stimm-ID, sendet den Text und die ID an HeyGen und gibt die Sprache zurück. Die Kompromisse sind ebenfalls vorhersehbar, denn ein Konto oder eine API-Verbindung kann erforderlich sein, die Nutzung kann Anbieter-Credits verbrauchen, Ihr Text und Audio werden von einem Drittanbieter verarbeitet, und Anbieterlimits oder Preise können sich ändern.
Offizielle Partner-Audioknoten erweitern dieselbe Idee über mehr des Audiobereichs. Die Audio-Dokumentation von ComfyUI trennt Text-zu-Audio-Generierung von Stimm- und Sprachanwendungsfällen, einschließlich Sprache aus Text und aus Referenzaudio. Diese Integrationen glänzen, wenn Ihr Graph bereits auf andere gehostete Medienmodelle angewiesen ist, weil sie das Hin- und Herschieben von Dateien zwischen separaten Anwendungen reduzieren.
Community- und lokale TTS-Knoten verbinden ComfyUI mit Systemen wie Edge TTS, Kokoro, Index-TTS und anderen Modellen, die lokal ausgeführt werden können. Lokale Workflows können Ihnen mehr Kontrolle über Ihre Daten und Modellwahl geben, aber sie verlangen mehr im Gegenzug: Installation, kompatible Hardware, Modell-Downloads und Fehlerbehebung. Ein lokaler Knoten ist nicht automatisch besser als ein gehosteter. Sein echter Vorteil hängt davon ab, ob Ihre Maschine das Modell effizient ausführen kann, ob die Stimmqualität hält, ob Ihre Sprache unterstützt wird, ob die Lizenz kommerzielle Nutzung erlaubt und ob Sie den Workflow über die Zeit am Laufen halten können.
Voice-Cloning und die Steuerungen, die Sie erwarten können
Voice-Cloning fügt dem Graphen eine Referenzidentität anstelle eines Standardsprechers hinzu. Die Struktur besteht meist aus zwei verbundenen Teilen: einem Cloning-Knoten, der eine Stimmidentität erstellt oder zurückgibt, und einem TTS-Knoten, der diese Identität nutzt, um neuen Text zu sprechen. Die HeyGen-Dokumentation beschreibt dies direkt, wo ein Instant-Clone-Knoten eine voice_id erzeugt, die in den Voice-1.0-Text-to-Speech-Knoten einfließt; dieser Klon-Workflow erfordert mindestens 10 Sekunden klarer Sprache, und der TTS-Knoten akzeptiert bis zu 5.000 Zeichen pro Anfrage.
Klonen Sie nur mit Genehmigung. Replizieren Sie nicht die Stimme einer realen Person, nur weil Sie an eine Aufnahme gelangen können. Holen Sie sich die Erlaubnis, bewahren Sie den Nachweis dafür auf und kennzeichnen Sie synthetische oder geklonte Sprache überall dort, wo der Kontext ein Publikum in die Irre führen könnte.
Über die Stimme selbst hinaus variieren die Steuerungen, denen Sie begegnen, je nach Knoten und Modell, aber ein vertrautes Set wiederholt sich bei den meisten davon.
- Stimme: die Sprecheridentität oder Voreinstellung
- Sprache: die Sprache, die zur Interpretation des Skripts verwendet wird
- Geschwindigkeit: wie schnell die Erzählung vorgetragen wird
- Tonhöhe: die wahrgenommene Höhe oder Tiefe der Stimme
- Stil und Ausdruckskraft: der Vortragscharakter und wie stark Emotion angewendet wird
- Stabilität: wie konsistent die Stimme ihre Eigenschaften beibehält
- Ausgabeformat: wie MP3, WAV oder Opus
- Referenzaudio: eine Aufnahme, die zum Klonen oder zur Sprachtransformation verwendet wird
Einige Modelle gehen mit Inline-Hinweisen weiter. Die Dokumentation des Fish-Audio-Knotens unterstützt Emotions-Hinweise und Mehrsprecher-Dialog-Tags in unterstützten Modellen. Eine Warnung gilt für alle: Diese Steuerungen sind zwischen Anbietern nicht austauschbar, und eine Einstellung namens Stil in einem Knoten verhält sich möglicherweise völlig anders als Stil in einem anderen.
ComfyUI versus eine dedizierte TTS-Plattform
ComfyUI verdient seinen Platz, wenn Sprache ein Teil einer größeren Medien-Pipeline ist. Eine dedizierte Plattform gewinnt tendenziell, wenn die einzige echte Aufgabe darin besteht, Skripte in ausgefeilte Erzählung zu verwandeln, ohne einen Graphen zusammenzubauen.
| Entscheidungsfaktor | ComfyUI | Dedizierte TTS-Plattform |
|---|---|---|
| Workflow-Flexibilität | Hoch; TTS mit anderen Medienknoten verbinden | Meist auf Sprachproduktion fokussiert |
| Einrichtung | Benötigt eventuell Knoten, Anbieterverbindungen oder Modellinstallationen | Oft schneller für die erste Generierung |
| Stimmoptionen | Abhängig von installierten oder verbundenen Knoten | Meist eine organisierte Stimmbibliothek |
| Automatisierung | Stark für wiederverwendbare visuelle Graphen | Oft über API oder Batch-Tools |
| Lokale Verarbeitung | Möglich mit lokalen Knoten und Modellen | Meist cloudbasiert |
| Bester Anwendungsfall | Experimentelle oder multimodale Pipelines | Wiederholbare Erzählung und Produktion |
Für Ersteller, die eine visuelle Pipeline aufbauen, die Sprache mit Bildern, Video oder Audioverarbeitung verbindet, zahlt sich der Graph aus. Für YouTube-Erzählungen, E-Learning-Voiceovers, Podcasts oder Lokalisierungsteams, die eine vorhersehbare Schnittstelle benötigen, beseitigt ein spezialisierter Dienst meist den technischen Mehraufwand. Unser Text-to-Speech-Workflow ist um die direkte Skript-zu-Audio-Generierung herum aufgebaut, mit über 300 KI-Stimmen, Voice-Cloning in 33 Sprachen, anpassbarer Sprechgeschwindigkeit, emotionalen Dialog-Hinweisen und herunterladbaren Projekten. Wenn die Generierung innerhalb einer Anwendung oder einer automatisierten Content-Pipeline stattfinden muss, übernimmt unsere Text-to-Speech-API die Integrationsseite, und unsere KI-Dubbing-API erweitert dieselbe Idee auf übersetztes, stimmlich abgestimmtes Video.
Wie Sie Ihr Setup auswählen und Fehler beheben
Bevor Sie sich auf einen Knoten oder ein Modell festlegen, führen Sie ein paar bewusste Prüfungen durch, anstatt einer kurzen Demo zu vertrauen.
Beurteilen Sie die Stimmqualität anhand einer schwierigen Probe, nicht einer einfachen. Generieren Sie eine Passage, die Namen, Zahlen, Akronyme, lange Sätze, Fragen, Markenbegriffe und mindestens eine emotionale Zeile in Ihrer Zielsprache und Ihrem Akzent enthält. Eine Stimme, die Sie in einem Einzeiler bezaubert, kann einen Produktnamen verstümmeln oder den Rhythmus über einen Absatz hinweg verlieren.
Prüfen Sie Sprach- und Akzentunterstützung pro Sprache, nicht insgesamt. Einige Systeme erkennen die Sprache automatisch, während andere erfordern, dass Sie sie festlegen, und die Dokumentation des HeyGen-Knotens empfiehlt, die Sprache manuell festzulegen bei eng verwandten Sprachen, bei denen die automatische Erkennung unzuverlässig sein kann. Denken Sie daran, dass eine fließende Stimme eine ungenaue Übersetzung nicht retten kann; Stimmqualität und Übersetzungsqualität sind getrennte Probleme.
Messen Sie die Aussprachekontrolle für die Wörter, die Engines tatsächlich ins Stolpern bringen: Produktnamen, Eigennamen, Abkürzungen, Daten, Währung und Fachvokabular. Wenn ein Knoten kein Aussprachewörterbuch oder SSML-ähnliche Steuerungen bietet, planen Sie ein, Text phonetisch umzuschreiben oder Zahlen auszuschreiben. Testen Sie bei einer Serie oder einem Markenkanal auch die Konsistenz, indem Sie dieselbe Stimme über mehrere Generierungen, Tonarten und neu generierte Abschnitte hinweg ausführen, da separate ComfyUI-Durchläufe für verschiedene Szenen abweichen können.
Wägen Sie Latenz, Kosten, Datenschutz und Rechte gemeinsam ab. Gehostete Knoten starten schnell, hängen aber von Netzwerkgeschwindigkeit, Anbieterverfügbarkeit, Kontolimits und nutzungsbasierten Preisen ab, während lokale Modelle pro-Anfrage-Gebühren vermeiden, aber Hardware und Wartung erfordern; vergleichen Sie die gesamten Produktionskosten, nicht den beworbenen Preis. Beim Datenschutz bestätigen Sie, wie Eingaben gespeichert werden, ob Inhalte das Modell trainieren, ob Stimmdaten gelöscht werden können, ob kommerzielle Nutzung erlaubt ist, wem die Ausgabe gehört und welche Einwilligung geklonte Stimmen erfordern.
Wenn sich ein Graph fehlerhaft verhält, gruppieren sich die Fehler zu einer kurzen Liste. Ein Knoten für geklonte Stimmen, der einen Fehler zurückgibt, hat oft eine leere oder ungültige voice_id; der HeyGen-Knoten stoppt genau aus diesem Grund. Überlange Skripte stoßen an Grenzen, und der dokumentierte HeyGen-Voice-1.0-Knoten akzeptiert bis zu 5.000 Zeichen, während er warnt, dass sehr lange Sprache fehlschlagen kann, insbesondere bei längerem chinesischem oder japanischem Text, also teilen Sie die Erzählung in logische Abschnitte auf. Falsche Aussprache reagiert meist auf das Umschreiben von Zahlen in Wörter, das Hinzufügen von Satzzeichen oder das Ausschreiben von Akronymen. Zu ausdrucksstarke Ausgabe erfordert eine geringere Ausdruckskraft, Stil oder Tonhöhenvariation. Und wenn sich Audio nachgelagert nicht verbinden lässt, prüfen Sie den Typ, da eine AUDIO-Ausgabe ohne einen Konvertierungsschritt keinen Knoten speisen kann, der ein Bild, Video oder Text erwartet. Speichern Sie schließlich einen sauberen Graphen mit benannten Knoten und aufgezeichneten Einstellungen, denn der Anbieter, die Stimm-ID, die Sprache und das Ausgabeformat, die Sie verwendet haben, sind die Details, die Ihr zukünftiges Ich benötigen wird.
Häufig gestellte Fragen
Ist ComfyUI ein Text-to-Speech-Tool?
ComfyUI ist eine knotenbasierte Workflow-Anwendung und keine einzelne TTS-Engine. Es kann Sprache über integrierte Knoten, Partnerintegrationen sowie Community- oder lokale TTS-Knoten generieren.
Kann ComfyUI eine Stimme klonen?
Ja, wenn die ausgewählte Integration oder der benutzerdefinierte Knoten Cloning unterstützt. Die genauen Aufnahmeanforderungen, der Stimm-ID-Prozess, die Grenzen und die kommerziellen Bedingungen hängen vom Anbieter ab.
Funktioniert ComfyUI Text-to-Speech offline?
Es kann, wenn Sie ein kompatibles lokales TTS-Modell und lokale Knoten verwenden. Gehostete Anbieterknoten erfordern eine Internetverbindung und senden möglicherweise Text- oder Stimmdaten an den Anbieter.
Was ist der beste ComfyUI-TTS-Knoten?
Es gibt keinen universell besten Knoten. Wählen Sie basierend auf Sprachunterstützung, Stimmqualität, Cloning-Anforderungen, Datenschutz, Kosten, Latenz und Kompatibilität mit dem Rest Ihres Workflows.
Kann ich ComfyUI TTS für YouTube-Videos verwenden?
Ja. Generieren Sie die Erzählung, überprüfen Sie Aussprache und Rechte, exportieren Sie das Audio und synchronisieren Sie es mit Ihrem Video. Wenn Sie eine geklonte oder synthetische Stimme verwenden, befolgen Sie die geltenden Einwilligungs-, Offenlegungs- und Plattformanforderungen.