واجهة برمجة تطبيقات استنساخ الصوت هي واجهة للمطورين تحوّل عينة صوتية مصرّحًا بها إلى صوت اصطناعي قابل لإعادة الاستخدام، بحيث يمكن لتطبيق ما إرسال نص—أو تشغيل مهمة دبلجة آلية—واستعادة كلام جديد يشبه المتحدث الأصلي. فبدلًا من اختيار صوت ثابت من كتالوج، ينشئ الكود الخاص بك هوية صوتية مرتبطة بمعرّف فريد، ثم يعيد استخدامها عبر النصوص والمنتجات واللغات. هذا التحول الوحيد—من اختيار صوت إلى امتلاكه برمجيًا—هو ما يجعل هذه التقنية مثيرة للاهتمام لصنّاع المحتوى والعلامات التجارية والمطورين الذين يبنون على نطاق واسع.
الإجابة المختصرة على ما هي واجهة برمجة تطبيقات استنساخ الصوت هي: إنها تكشف عن ثلاث قدرات مترابطة—تحميل الصوت، وإنشاء الصوت، وتوليد الصوت—كنقاط نهاية يمكن لبرنامجك استدعاؤها. وفهم كيفية تلاؤم هذه الأجزاء معًا هو ما يميّز خط إنتاج سلسًا عن آخر محبط، لذا فإن بقية هذا الشرح تمرّ عبر الآلية، والمفاضلات، وأسئلة الحقوق التي يجب حسمها قبل أن يُنشر ملف واحد.
جدول المحتويات
ما الذي تفعله واجهة برمجة تطبيقات استنساخ الصوت فعليًا
تكشف واجهة برمجة تطبيقات استنساخ الصوت عن الاستنساخ كخدمة قابلة للبرمجة بدلًا من كونها ميزة يدوية مدفونة داخل محرر صوت أو لوحة تحكم على الويب. يحمّل تطبيقك عينة، ويحوّلها المزوّد إلى صوت مخصص بمعرّفه الخاص، ومنذ ذلك الحين يصبح هذا المعرّف هو المقبض الذي تمرره في طلبات تحويل النص إلى كلام أو الدبلجة.
النمط متسق عبر المزوّدين: تصبح العينة الصوتية معرّف صوت مخصص، الذي يصبح كلامًا جديدًا من نص أو نص مترجم، الذي يصبح ملفًا صوتيًا نهائيًا. أما عمل التعلّم الآلي—تحليل النبرة، وأنماط النطق، ونطاق الطبقة الصوتية، والإيقاع، والجَرَس—فيحدث خلف نقطة النهاية، ويمكن لنموذج الصوت الناتج أن ينطق نصًا جديدًا تمامًا مع الحفاظ على الصفات المميزة للمتحدث المرجعي.
هناك تمييز واحد يهم أكثر من أي شيء آخر. فواجهة برمجة التطبيقات لا تعيد تشغيل التسجيل الأصلي؛ بل تولّد كلامًا جديدًا. يمكن لصوت مستنسخ أن ينطق كلمات لم تكن موجودة قط في العينة المصدر، وهذا بالضبط هو سبب قوته وسبب حمله للمسؤولية.
كيف يعمل استنساخ الصوت خلف واجهة برمجة التطبيقات
ينفّذ المزوّدون النموذج بطرق مختلفة، لكن معظم الأنظمة تشترك في نفس المراحل العامة، ومعرفتها تساعدك على تصميم تكامل موثوق.
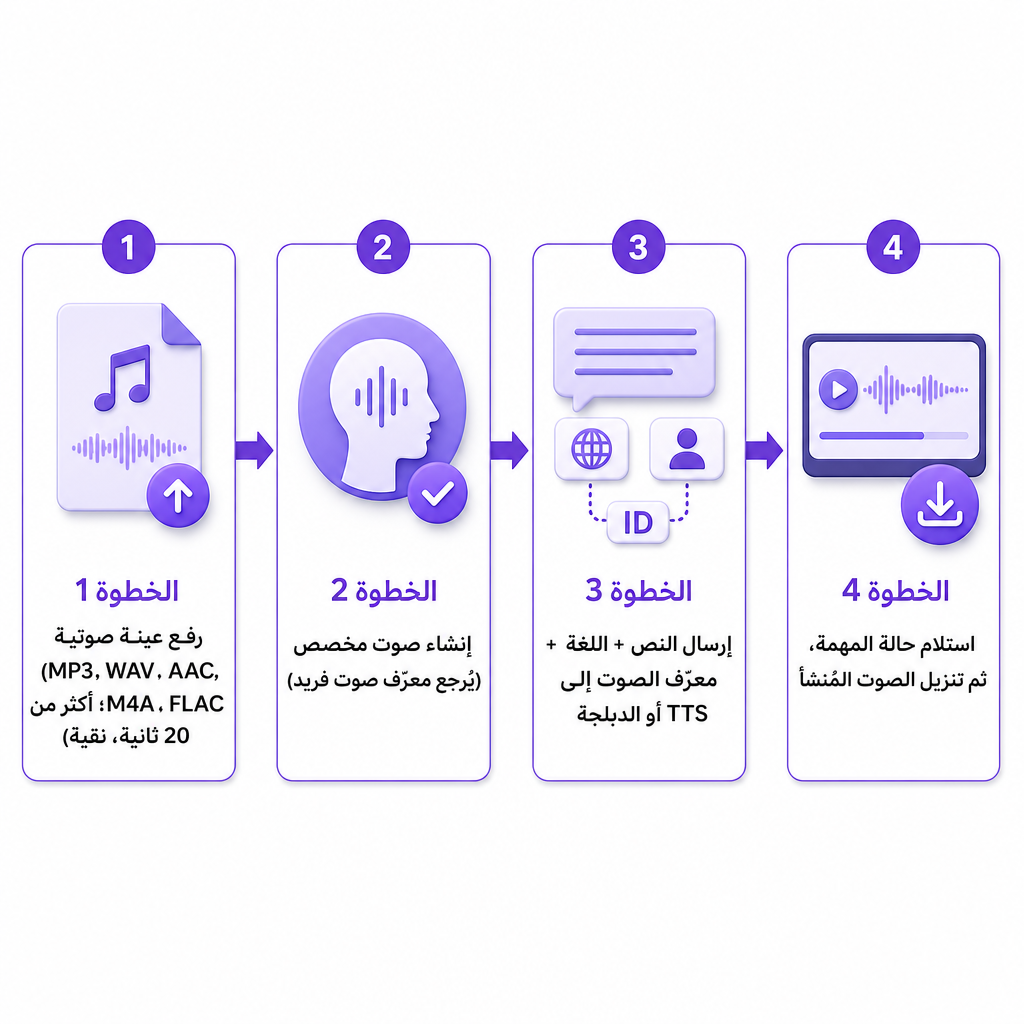
أولًا، يستقبل النظام عينة صوتية. عادةً ما يحمّل المطورون عبر رابط تحميل موقّع مسبقًا، مما يتيح للتطبيق إرسال الملف مباشرةً إلى التخزين بدلًا من حشر حمولة صوتية كبيرة داخل طلب إنشاء الصوت. والصوت المصدر النظيف مهم هنا لأن النموذج قد يتعلّم أصواتًا غير مرغوب فيها إلى جانب المتحدث: الموسيقى، وصدى الغرفة، وتعدد المتحدثين المتداخلين، والتشويه، وتقليل الضوضاء العدواني كلها تقلل من اتساق النسخة المستنسخة. توثّق واجهة برمجة تطبيقات استنساخ الصوت لدينا دعم صيغ MP3 وWAV وAAC وM4A وFLAC، وتوصي بما لا يقل عن 20 ثانية من الصوت دون ضوضاء خلفية للحصول على أفضل نتيجة.
ثانيًا، يُنشئ المزوّد صوتًا مخصصًا. بعد التحميل، يرسل التطبيق موقع الملف المخزّن واسمًا، وتعيد الخدمة كائن صوت بمعرّف. هذا المعرّف هو مفتاح كل ما يتبع—يخزّنه تطبيقك إلى جانب سجل مستخدم أو مشروع أو شخصية أو علامة تجارية في قاعدة بياناته الخاصة. توثيقنا يتبع هذا النمط بنقطة نهاية للإنشاء، إضافةً إلى نقاط نهاية لسرد الأصوات المخصصة مع التقسيم إلى صفحات ولحذف صوت مخصص حسب المعرّف.
ثالثًا، يولّد التطبيق كلامًا جديدًا. بمجرد وجود الصوت المخصص، يرسل الكود الخاص بك نصًا ولغة ومعرّف الصوت المخصص إلى نقطة نهاية تحويل النص إلى كلام. تعيد الخدمة معرّف مشروع أو مهمة؛ ثم يستعلم التطبيق عن حالة المهمة حتى تكتمل المعالجة ويسترجع رابط الصوت الناتج. توثّق واجهة برمجة تطبيقات تحويل النص إلى كلام لدينا التوليد القائم على المشاريع بحالات: معلّق، وقيد المعالجة، ومكتمل، وفاشل، وتكشف عن قيم الصوت واللغة والسرعة والطبقة الصوتية على مستوى المقطع الفردي.
إذا أردت التفاصيل الأعمق لجانب التوليد، فإن شرحنا حول ما هي واجهة برمجة تطبيقات تحويل النص إلى كلام وكيف تعمل يفصّل خط أنابيب التركيب الذي يحرّكه الصوت المستنسخ في النهاية.
واجهة برمجة تطبيقات استنساخ الصوت مقابل واجهات تحويل النص إلى كلام والدبلجة
هذه الواجهات الثلاث مترابطة لكنها تحل مشكلات مختلفة، والخلط بينها يؤدي إلى بنية خاطئة.
| نوع واجهة برمجة التطبيقات | المدخل الرئيسي | المخرج الرئيسي | الأنسب لـ |
|---|---|---|---|
| واجهة برمجة تطبيقات تحويل النص إلى كلام | نص مع صوت مختار | كلام اصطناعي | السرد، والتنبيهات، والمساعدين، والصوت المكتوب |
| واجهة برمجة تطبيقات استنساخ الصوت | عينة صوتية | معرّف صوت مخصص | إنشاء هوية صوتية قابلة لإعادة الاستخدام |
| واجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي | فيديو أو صوت مع إعدادات اللغة | وسائط مترجمة ومدبلجة | توطين الفيديو والصوت متعدد اللغات |
في الممارسة العملية، نادرًا ما تعمل واجهة برمجة تطبيقات استنساخ الصوت بمفردها. فنقطة نهاية الاستنساخ تنشئ الصوت؛ ونقطة نهاية تحويل النص إلى كلام تستخدم معرّف الصوت ذاك لنطق نص جديد. ويمكن أن يتدفق معرّف الصوت نفسه أيضًا إلى سير عمل الدبلجة، حيث يترجم النظام الحوار الأصلي ويولّد الأداء المترجم بالصوت المخصص المختار. نصف أصواتنا المخصصة بأنها قابلة للاستخدام في مشاريع تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي على حدٍّ سواء، وهو ما يتيح لعينة واحدة مدتها 20 ثانية أن تخدم السرد والتوطين من الهوية نفسها. للاطلاع على البنية الخاصة بالدبلجة، راجع شرحنا المرافق حول ما هي واجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي، وللاطلاع على العائلة الأوسع من نقاط نهاية الصوت، دليلنا حول ما هي واجهة برمجة تطبيقات الصوت بالذكاء الاصطناعي.
ما الذي يمكنك بناؤه بها
تستحق واجهة برمجة تطبيقات استنساخ الصوت مكانها عندما يجب توليد الصوت نفسه مرارًا وتكرارًا، عبر العديد من النصوص أو المنتجات أو اللغات. وتظهر بعض الأنماط الملموسة أين تناسب.
يمكن لصانع محتوى على YouTube تسجيل عينة صوتية واحدة وإعادة استخدام الصوت الناتج للنسخ المترجمة من مقاطع الفيديو، لتوليد السرد لأسواق لغوية مختلفة دون إعادة تسجيل كل نص. لا يلغي الاستنساخ الحاجة إلى مراجعة الترجمة—فالأسماء، والتعابير الاصطلاحية، والنكات، والمراجع الثقافية لا تزال بحاجة إلى تحقق بشري—لكنه يزيل عنق الزجاجة في التسجيل.
يمكن لشركة إنشاء راوٍ متسق لشروحات المنتجات، ومقاطع الفيديو التعريفية، والإعلانات، ومحتوى المساعدة، بدلًا من تخصيص صوت مختلف لكل حملة. والخطوة العملية قبل الإنتاج هي سياسة استخدام الصوت: أي الأقسام قد تستخدم الصوت، وأي محتوى يحتاج إلى موافقة، وما إذا كان يجب الإفصاح عن السرد الاصطناعي.
تكتسب فرق التدريب القدرة على تحديث الدروس بسرعة عند تغيّر سياسة أو تفصيل منتج أو إجراء، مع الحفاظ على الاستمرارية عبر مكتبة دورات كبيرة. وبالنسبة للمواضيع الحساسة، تظل المراجعة البشرية أساسية، لأن الصوت المولّد يبدو واثقًا حتى عندما يكون النص خاطئًا. ويمكن لمنتجي البودكاست الحفاظ على صوت مضيف أو شخصية متسق للمقدمات، والتصحيحات، والملخصات، أو الإصدارات باللغات البديلة، وهو أمر مفيد عندما يتطلب تعديل صغير جلسة جديدة كاملة لولا ذلك. ويمكن للمطورين الذين يبنون ألعابًا، وتطبيقات تعليمية، وأدوات إمكانية وصول، أو تجارب موجّهة جعل الصوت جزءًا من سير عمل قائم بدلًا من تصدير الصوت يدويًا لكل استجابة.
كيفية تقييم واجهة برمجة تطبيقات استنساخ الصوت
يعتمد المزوّد المناسب على متطلب الإنتاج لديك، وليس على مدى صقل عرض توضيحي واحد. اعمل على الأبعاد أدناه قبل أن تلتزم.
متطلبات إدخال الصوت. أكّد صيغ الملفات المدعومة، والحد الأدنى أو طول العينة الموصى به، وما إذا كان يُرفض تعدد المتحدثين، وكيفية التعامل مع ضوضاء الخلفية، وما إذا كانت التحميلات مقبولة مباشرةً، وما إذا كان يمكن حذف الملفات المرجعية بعد الاستنساخ. نحن ندرج MP3 وWAV وAAC وM4A وFLAC كصيغ مدعومة ونوصي بعينة نظيفة مدتها 20 ثانية على الأقل.
جودة الصوت واتساقه. اختبر الصوت بأكثر من جملة واحدة. أدرج جملًا قصيرة وطويلة، وأرقامًا وتواريخ، وأسماء علم، وأسئلة وجملًا تعجبية، ومفردات تقنية، وكلمات يصعب نطقها. فالنسخة المستنسخة التي تسحر في عرض قصير قد تتوه في سرد طويل أو لغة غير مألوفة.
دعم اللغة والتوطين. إذا كان المخرج متعدد اللغات هو الهدف، فتحقق من اللغات المصدر والهدف المدعومة، وما إذا كان الصوت المخصص يمكنه نطق كل منها، وسلوك اللهجة والنطق، وما إذا كان الصوت يبقى مميزًا عبر اللغات. تذكر واجهة برمجة تطبيقات تحويل النص إلى كلام لدينا علنًا أكثر من 300 صوت ذكاء اصطناعي عبر أكثر من 33 لغة ولهجة، بما في ذلك الإنجليزية والبرتغالية والإسبانية والفرنسية والألمانية والصينية واليابانية. نحن لا ننشر كتالوج لغات كاملًا على تلك الصفحة، لذا أكّد المزيج الدقيق للصوت واللغة قبل تثبيت سير عمل إنتاجي.
بنية واجهة برمجة التطبيقات. ينبغي لواجهة برمجة تطبيقات جاهزة للإنتاج أن توفر معالجة يمكن التنبؤ بها للمصادقة، والتحميلات، وإنشاء الصوت، والسرد، والحذف، وحالة المشروع، وإعادة المحاولات، وأخطاء التحقق، والتقسيم إلى صفحات، واسترجاع الصوت، ومراقبة الاستخدام. نحن نعرض مصادقة Bearer-token في أمثلتنا ونوثّق كلًا من نقاط نهاية إدارة الصوت ومعالجة تحويل النص إلى كلام القائمة على المشاريع.
التوليد المتزامن مقابل غير المتزامن. قد تعيد الطلبات القصيرة نتيجة بسرعة، لكن المحتوى الأطول يُعالَج على نحو أفضل كمهمة: إرسال طلب، استلام معرّف مهمة، الاستعلام عن الحالة أو استلامها، ثم تنزيل الصوت. يمنع التصميم غير المتزامن انتهاء مهلة طلب الويب أثناء تقديم سرد طويل أو دفعة كبيرة من المقاطع. يستخدم توثيق تحويل النص إلى كلام لدينا حالات المشروع وقيم التقدم، ويعيد المشروع المكتمل رابط صوت إلى جانب روابط صوت لكل مقطع.
عناصر التحكم في المخرجات والتحرير. تحقق من صيغة المخرج وجودته، وما إذا كان معدل العينة قابلًا للتكوين، وما إذا كانت السرعة والطبقة الصوتية تُضبطان، وما إذا كان يمكن تنزيل المقاطع الفردية، وما إذا كان يمكن إعادة توليد مقطع فاشل دون إعادة تشغيل المشروع بأكمله، وما إذا كانت روابط الصوت مؤقتة أم دائمة. نحن نوثّق مخرج MP3 بتردد 22 كيلوهرتز لواجهة برمجة تطبيقات تحويل النص إلى كلام ونكشف عن عناصر التحكم في السرعة والطبقة الصوتية على مستوى المقطع.
عناصر التحكم في الحذف والبيانات. ينبغي للمزوّد أن يتيح لك إزالة الصوت المرجعي المحمّل، والصوت المخصص المولّد، وملفات الصوت المولّدة، وبيانات المشروع المرتبطة. تتضمن واجهة برمجة تطبيقات استنساخ الصوت لدينا نقطة نهاية للحذف للأصوات المخصصة وتذكر أنه يمكن للمستخدمين حذف الأصوات المخصصة والصوت المرتبط بها. راجع شروط الخصوصية الحالية والتزامات الاحتفاظ قبل تحميل تسجيلات سرية أو حساسة تجاريًا.
الحقوق، وانتحال الهوية، والاستخدام المسؤول
استنساخ الصوت هو قرار يتعلق بالحقوق والخصوصية وانتحال الهوية بقدر ما هو قرار تقني، والتعامل معه بوصفه مجرد كود هو ما يوقع الفرق في المتاعب.
ابدأ بالإذن. استخدم تسجيلًا فقط عندما يكون لديك الحق في استنساخ صوت ذلك المتحدث واستخدامه. بالنسبة لسير عمل تجاري، ينبغي أن تتناول الموافقة المكتوبة إنشاء صوت اصطناعي، والاستخدام التجاري، واللغات والمناطق، ومدة الترخيص، والمحتوى الإعلاني والسياسي، واستخدامات التدريب وخدمة العملاء، وما إذا كان يمكن الترخيص من الباطن للصوت، وكيفية حذفه أو سحبه من الخدمة. العثور على تسجيل عبر الإنترنت لا يمنحك الحق في استنساخه.
احترس من انتحال الهوية، لأن الصوت الاصطناعي يمكن أن يجعل طلبًا احتياليًا يبدو مصدَّقًا. حذّرت لجنة التجارة الفيدرالية (FTC) من أن المحتالين قد يستنسخون صوت أحد الأقارب أو المسؤولين التنفيذيين للضغط على الناس لإرسال أموال أو مشاركة معلومات. وتشمل الضمانات المعقولة تقييد من يمكنه إنشاء صوت مخصص أو الوصول إليه، وطلب موافقة قبل نشر الصوت المولّد، وتسجيل نشاط التوليد، وفصل بيانات اعتماد التطوير والإنتاج، وتطبيق حدود المعدل، وحظر فئات المحتوى عالية الخطورة، وطلب قناة تحقق ثانية للطلبات المالية.
بالنسبة للجمهور الأمريكي، تضيف المكالمات الصادرة ثقلًا قانونيًا. تذكر لجنة الاتصالات الفيدرالية (FCC) أن الأصوات المولّدة بالذكاء الاصطناعي تقع ضمن قيود قانون حماية مستهلك الهاتف (TCPA) على الأصوات الاصطناعية أو المسجّلة مسبقًا، وأن مثل هذه المكالمات تتطلب عمومًا موافقة صريحة مسبقة ما لم ينطبق استثناء. واجهة برمجة تطبيقات استنساخ الصوت ليست ترخيصًا لأتمتة التسويق عبر الهاتف، أو تحصيل الديون، أو المكالمات السياسية، أو الاتصالات الحساسة للهوية. يمكنك قراءة حكم لجنة الاتصالات الفيدرالية حول أصوات المكالمات الآلية المولّدة بالذكاء الاصطناعي وتنبيه المستهلك من لجنة التجارة الفيدرالية حول استنساخ الصوت مباشرةً.
أخيرًا، الاستنساخ يغيّر التسليم، لا الحقيقة. فالصوت الواقعي يجعل عبارة غير دقيقة تبدو موثوقة، لذا راجع الأسماء والأرقام، والترجمات، وأي ادعاءات طبية أو مالية أو قانونية، وتعليمات المنتج، والنطق، والتوقيت، والنص المعروض على الشاشة قبل الإصدار. وبالنسبة للفيديو متعدد اللغات، تحقق من كل من النص المترجم والصوت النهائي—فالنسخة المستنسخة الجيدة لا يمكنها إنقاذ ترجمة خاطئة.
هل واجهة برمجة تطبيقات استنساخ الصوت مناسبة لمشروعك؟
تكون واجهة برمجة تطبيقات استنساخ الصوت مناسبة بقوة عندما تحتاج إلى الصوت نفسه عبر العديد من الملفات، ويكون لديك بالفعل خط موثوق للنص أو الترجمة أو الوسائط، وتريد التوليد البرمجي بدلًا من التصديرات اليدوية العرضية، وتملك إذنًا موثّقًا لاستخدام الصوت المرجعي، وتنتج محتوى موطّنًا أو مخصصًا على نطاق واسع، ويمكنك اختبار الصوت المولّد ومراجعته قبل الإصدار.
قد يخدمك صوت تحويل نص إلى كلام مُعدّ مسبقًا على نحو أفضل عندما تفوق السرعة والبساطة وانخفاض المخاطر القانونية استمرارية العلامة التجارية. وغالبًا ما يكون الممثل الصوتي المحترف الخيار الصحيح للحملات الرئيسية، والأداءات الدقيقة، والمواضيع الحساسة، أو العمل الذي يحتاج إلى إخراج بشري كامل. وبالنسبة للفرق التي تحتاج إلى أصوات مخصصة وتوطين في مكان واحد، نقدّم الاستنساخ وتحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي كقدرات مترابطة لواجهة برمجة التطبيقات: تبني واجهة برمجة تطبيقات استنساخ الصوت لدينا صوتًا مخصصًا من عينة، وتستخدم واجهة برمجة تطبيقات تحويل النص إلى كلام لدينا معرّفات الصوت لتوليد الكلام داخل سير عمل مشروع. عندما تكون مستعدًا لربطها، يغطي دليلنا التفصيلي حول كيفية دمج واجهة برمجة تطبيقات استنساخ الصوت خطوات التحميل والإنشاء والتوليد بالتفصيل.
التقييم الأكثر فائدة هو اختبار مضبوط: استخدم عينة نظيفة ومصرّحًا بها، وولّد النص نفسه باللغات المقصودة، وافحص الجودة وزمن الاستجابة، وتحقق من دورة حياة واجهة برمجة التطبيقات وعناصر التحكم في الحذف، واطلب موافقة بشرية قبل نشر أي شيء.
الأسئلة الشائعة
هل واجهة برمجة تطبيقات استنساخ الصوت هي نفسها مولّد الصوت بالذكاء الاصطناعي؟
لا. يتيح لك مولّد الصوت بالذكاء الاصطناعي عادةً اختيار صوت اصطناعي موجود وتوليد كلام من نص. أما واجهة برمجة تطبيقات استنساخ الصوت فتنشئ صوتًا مخصصًا من عينة صوتية، يمكنك بعد ذلك إعادة استخدامه للتوليد.
ما مقدار الصوت اللازم لاستنساخ صوت؟
تختلف المتطلبات حسب المزوّد والنموذج. نوصي بما لا يقل عن 20 ثانية من الصوت النظيف وندعم صيغ الإدخال MP3 وWAV وAAC وM4A وFLAC.
هل يمكن لصوت مستنسخ أن ينطق لغة أخرى؟
أحيانًا. يعتمد ذلك على نموذج المزوّد، واللغات المدعومة لديه، وقدرة الصوت على الانتقال عبر اللغات. تحقق من المزيج الدقيق للصوت واللغة بدلًا من افتراض أن كل نسخة مستنسخة تعمل بالقدر نفسه من الجودة في كل مكان.
هل يمكنني استخدام صوت مستنسخ للدبلجة بالذكاء الاصطناعي؟
نعم، عندما يربط المزوّد الاستنساخ بالدبلجة. نحن نسمح باستخدام الأصوات المخصصة في مشاريع الدبلجة بالذكاء الاصطناعي عن طريق الإشارة إلى معرّف الصوت.
هل استنساخ الصوت قانوني؟
التقنية نفسها ليست غير قانونية تلقائيًا، لكن استخدام صوت شخص ما دون إذن قد يخلق مشكلات تتعلق بالخصوصية، وحقوق الدعاية، والعقود، والاحتيال، وحماية المستهلك. احصل على الإذن، واتبع القوانين المعمول بها، وتجنّب انتحال الهوية المضلّل.