إذا وصلتَ إلى comfyui text to speech وأنت تتوقع زرًا واحدًا يحوّل النص المكتوب إلى صوت، فإن أول ما يستحق معرفته هو أن ComfyUI ليس محرك أصوات على الإطلاق. إنه مساحة عمل قائمة على العُقد حيث تربط النص والصوت والنموذج واللغة ومخرجات الصوت معًا في رسم بياني قابل لإعادة الاستخدام. أما الكلام نفسه فيأتي من أي عُقدة تحويل نص إلى كلام (TTS) تربطها: مزوّد مستضاف، أو تكامل شريك رسمي، أو نموذج محلي تثبّته بنفسك. السؤال المهم فعلًا إذن ليس ما إذا كان بإمكان ComfyUI نطق نصك، لأنه يستطيع، بل ما إذا كان الرسم البياني المرئي هو المكان المناسب للعمل الذي تحتاج إلى تكراره.
هذا التمييز يشكّل كل قرار آخر على هذه الصفحة. يكافئ ComfyUI التجريب وخطوط الإنتاج متعددة الوسائط حيث يجلس السرد الصوتي إلى جانب توليد الصور والفيديو والصوت. أما أداة الكلام المخصصة فتكافئ الإنتاج القابل للتكرار حيث تحتاج ببساطة إلى تعليقات صوتية نظيفة مرة تلو الأخرى. فيما يلي، نشرح كيف يعمل سير العمل، وما أنواع الخيارات الموجودة، وكيف تحكم عليها، وأين يتوقف الرسم البياني عن استحقاق الصيانة.
جدول المحتويات
ما هو تحويل النص إلى كلام في ComfyUI فعليًا
تحويل النص إلى كلام في ComfyUI هو ممارسة استخدام رسم بياني في ComfyUI لتحويل النص المكتوب إلى مخرجات AUDIO. تصف الوثائق الرسمية ComfyUI بأنه تطبيق مفتوح المصدر قائم على العُقد لبناء خطوط عمل عبر توليد الصور والفيديو والصوت والأشكال ثلاثية الأبعاد، وتربط عُقده الصوتية خدمات أو نماذج الكلام الخارجية داخل تلك اللوحة المرئية نفسها.
الرسم البياني الصوتي الفعّال صغير. فهو يحتاج إلى مدخل نص أو موجّه، وعُقدة TTS، ومدخل صوت أو صوت مرجعي، وإعدادات لغة وأداء اختيارية، وعُقدة معاينة أو حفظ للصوت. تدفع عُقدة TTS نصك عبر نموذج كلام وتعيد الصوت المولَّد الذي يمكن للعُقد اللاحقة استخدامه.
النتيجة العملية هي أن ComfyUI هو طبقة سير العمل، وليس النموذج. فالصوت الفعلي قد يُنتَج بواسطة مزوّد مستضاف، أو نموذج صوت شريك، أو عُقدة مخصصة من طرف ثالث، أو نظام مثبّت محليًا. فهم هذا التقسيم هو ما يبقي توقعاتك دقيقة: أنت تجمّع خط إنتاج، ولا تزال تختار المحرك داخله.
كيف يعمل سير العمل ذو المراحل الأربع
إذا أزلتَ أسماء العُقد، فإن كل رسم بياني للكلام في ComfyUI يقوم بالأشياء الأربعة نفسها بالتسلسل.
أولًا، يصل النص كنص مكتوب. قد تأخذ عُقدة TTS النص العادي مباشرة، أو قد يتدفق النص من عُقدة أخرى تحمّل أو تترجم أو تقسّم نصًا أطول. يتيح لك تقسيم السرد الطويل إلى أقسام منطقية إعادة توليد فقرة واحدة دون إعادة بناء التعليق الصوتي بأكمله، ويساعدك على البقاء تحت الحد الأقصى لمدخلات المزوّد.
ثانيًا، يختار سير العمل صوتًا ونموذجًا. وفقًا للمزوّد، قد يكون ذلك متحدثًا مُعدًّا مسبقًا، أو صوتًا مستنسخًا، أو معرّف صوت، أو تسجيلًا مرجعيًا. كما يحكم اختيار النموذج السرعة والجودة والمدى التعبيري والتكلفة. على سبيل المثال، تكشف عُقدة HeyGen في ComfyUI عن كل من heygen-voice-1 وheygen-voice-1-turbo الأسرع والأقل تكلفة، بينما تعرض عُقدة ElevenLabs عناصر تحكم مثل الثبات والسرعة والأسلوب.
ثالثًا، يصنّع نموذج الكلام الصوت. تقدّر الأنظمة العصبية الحديثة النطق والإيقاع والتوقفات وحركة طبقة الصوت بدلًا من تجميع كلمات مسجّلة مسبقًا، وتعيد موجة صوتية يمكنك توجيهها فيما بعد: حفظها في ملف، أو مزجها مع موسيقى، أو إدراجها في رسم بياني للفيديو، أو إقرانها مع صورة رمزية.
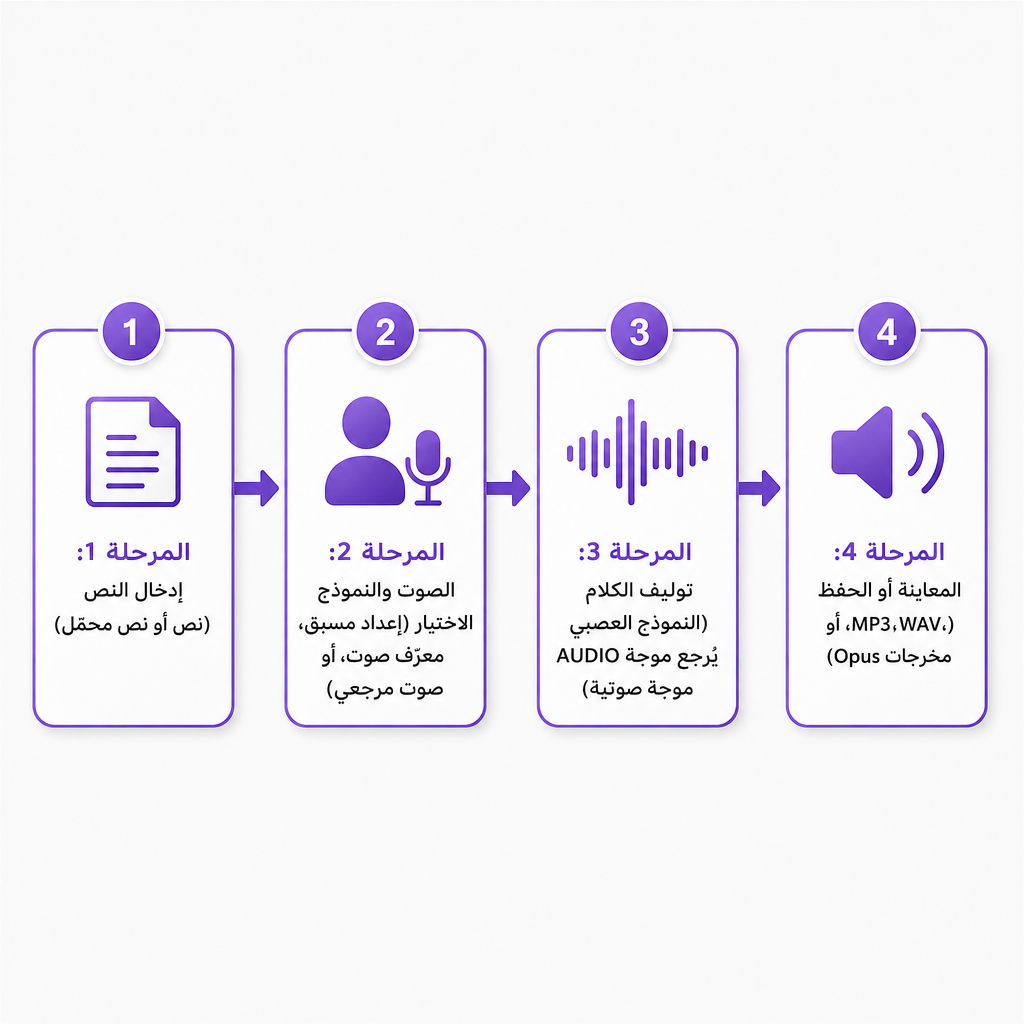
رابعًا، تتم معاينة الصوت أو حفظه. عادةً ما تصدر عُقد TTS كائن AUDIO يتصل بعُقدة معاينة أو حفظ، مع تعيين تنسيق الملف من قِبل العُقدة والمزوّد؛ فعلى سبيل المثال، تسرد وثائق عُقدة ElevenLabs تنسيقات قابلة للاختيار تشمل MP3 وأنواع Opus. ولأن الرسم البياني مرئي، فإن تكرار الدورة سهل: غيّر النص أو الصوت أو اللغة أو النموذج، ثم أدرجه في قائمة الانتظار مرة أخرى.
الطرق الثلاث لتشغيل TTS في ComfyUI
لا توجد طريقة واحدة للكلام في ComfyUI، وتعود الفروقات إلى الإعداد والتحكم والخصوصية ومقدار الصيانة التي أنت مستعد لتحملها.
ترسل عُقد المزوّد المستضاف نصك وإعدادات صوتك إلى خدمة خارجية وتعيد صوتًا جاهزًا. عادةً ما يكون هذا أسرع طريق لكلام عالي الجودة لأن النموذج يعمل على البنية التحتية للمزوّد. تجسّد عُقدة HeyGen Voice 1.0 هذا النمط: فهي تتطلب معرّف صوت مستنسخ صالح، وترسل النص والمعرّف إلى HeyGen، وتعيد الكلام. والمقايضات متوقعة أيضًا، إذ قد يُطلب حساب أو اتصال API، وقد يستهلك الاستخدام أرصدة المزوّد، ويُعالَج نصك وصوتك بواسطة طرف ثالث، وقد تتغير حدود المزوّد أو تسعيره.
تمدّد عُقد الصوت للشركاء الرسميين الفكرة نفسها عبر جزء أكبر من مجال الصوت. تفصل وثائق الصوت في ComfyUI بين توليد الصوت من النص وحالات استخدام الصوت والكلام، بما في ذلك الكلام من النص ومن الصوت المرجعي. تتألق هذه التكاملات عندما يعتمد رسمك البياني بالفعل على نماذج وسائط مستضافة أخرى، لأنها تقلّل من نقل الملفات بين تطبيقات منفصلة.
تربط عُقد TTS المجتمعية والمحلية ComfyUI بأنظمة مثل Edge TTS وKokoro وIndex-TTS ونماذج أخرى يمكن تشغيلها محليًا. يمكن أن تمنحك خطوط العمل المحلية تحكمًا أكبر في بياناتك واختيار النموذج، لكنها تطلب المزيد في المقابل: التثبيت، والأجهزة المتوافقة، وتنزيلات النماذج، واستكشاف الأخطاء. العُقدة المحلية ليست أفضل تلقائيًا من المستضافة. تعتمد ميزتها الحقيقية على ما إذا كان جهازك قادرًا على تشغيل النموذج بكفاءة، وما إذا كانت جودة الصوت تصمد، وما إذا كانت لغتك مدعومة، وما إذا كان الترخيص يسمح بالاستخدام التجاري، وما إذا كان بإمكانك إبقاء سير العمل حيًا مع مرور الوقت.
استنساخ الصوت وعناصر التحكم التي يمكنك توقعها
يضيف استنساخ الصوت هوية مرجعية إلى الرسم البياني بدلًا من متحدث جاهز. عادةً ما تتكوّن البنية من جزأين متصلين: عُقدة استنساخ تنشئ أو تعيد هوية صوتية، وعُقدة TTS تستخدم تلك الهوية لنطق نص جديد. تصف وثائق HeyGen هذا مباشرة، حيث تنتج عُقدة Instant Clone معرّف voice_id يُغذّي عُقدة Voice 1.0 Text to Speech؛ ويطلب سير عمل الاستنساخ ذاك ما لا يقل عن 10 ثوانٍ من الكلام الواضح، وتقبل عُقدة TTS ما يصل إلى 5000 حرف لكل طلب.
استنسخ فقط بتفويض. لا تكرّر صوت شخص حقيقي لمجرد أنه يمكنك الوصول إلى تسجيل. احصل على الإذن، واحتفظ بإثباته، وأفصح عن الكلام الاصطناعي أو المستنسخ حيثما قد يضلّل السياق الجمهور.
بعيدًا عن الصوت نفسه، تختلف عناصر التحكم التي ستصادفها حسب العُقدة والنموذج، لكن مجموعة مألوفة تتكرر عبر معظمها.
- الصوت: هوية المتحدث أو الإعداد المسبق
- اللغة: اللغة المستخدمة لتفسير النص
- السرعة: مدى سرعة تقديم السرد
- طبقة الصوت: درجة علوّ أو انخفاض الصوت المُدرَكة
- الأسلوب والتعبيرية: طابع الأداء ومدى قوة تطبيق العاطفة
- الثبات: مدى ثبات الصوت على خصائصه
- تنسيق المخرجات: مثل MP3 أو WAV أو Opus
- الصوت المرجعي: تسجيل يُستخدم للاستنساخ أو تحويل الكلام
تذهب بعض النماذج أبعد من ذلك بإشارات مضمّنة. تدعم وثائق عُقدة Fish Audio إشارات العاطفة وعلامات الحوار متعدد المتحدثين في النماذج المدعومة. ثمة تحذير يسري عبرها جميعًا: عناصر التحكم هذه ليست قابلة للتبادل بين المزوّدين، وقد يتصرف إعداد يُسمى الأسلوب في عُقدة واحدة بشكل مختلف تمامًا عن الأسلوب في عُقدة أخرى.
ComfyUI مقابل منصة TTS مخصصة
يستحق ComfyUI مكانته عندما يكون الكلام جزءًا واحدًا من خط إنتاج وسائط أكبر. وتميل المنصة المخصصة إلى الفوز عندما تكون المهمة الحقيقية الوحيدة هي تحويل النصوص إلى سرد مصقول دون تجميع رسم بياني.
| عامل القرار | ComfyUI | منصة TTS مخصصة |
|---|---|---|
| مرونة سير العمل | عالية؛ اربط TTS بعُقد وسائط أخرى | عادةً ما تركز على إنتاج الكلام |
| الإعداد | قد يحتاج إلى عُقد أو روابط مزوّد أو تثبيت نماذج | غالبًا أسرع للتوليد الأول |
| خيارات الصوت | تعتمد على العُقد المثبّتة أو المتصلة | عادةً مكتبة أصوات منظّمة واحدة |
| الأتمتة | قوية للرسوم البيانية المرئية القابلة لإعادة الاستخدام | غالبًا عبر API أو أدوات الدُفعات |
| المعالجة المحلية | ممكنة مع العُقد والنماذج المحلية | عادةً قائمة على السحابة |
| أفضل حالة استخدام | خطوط الإنتاج التجريبية أو متعددة الوسائط | السرد والإنتاج القابل للتكرار |
بالنسبة للمبدعين الذين يبنون خط إنتاج مرئيًا يمزج الكلام مع الصور أو الفيديو أو معالجة الصوت، فإن الرسم البياني يستحق عناءه. أما بالنسبة لسرد يوتيوب، أو تعليقات التعلّم الإلكتروني الصوتية، أو البودكاست، أو فرق التوطين التي تحتاج إلى واجهة متوقعة، فإن الخدمة المتخصصة عادةً ما تزيل العبء التقني. يُبنى سير عمل تحويل النص إلى كلام الخاص بنا حول التوليد المباشر من النص إلى الصوت، مع أكثر من 300 صوت ذكاء اصطناعي، واستنساخ الصوت عبر 33 لغة، ومعدل كلام قابل للتعديل، وإشارات حوار عاطفية، ومشاريع قابلة للتنزيل. وعندما يتعيّن أن يعيش التوليد داخل تطبيق أو خط محتوى آلي، تتولى واجهة برمجة تطبيقات تحويل النص إلى كلام الخاصة بنا جانب التكامل، وتمدّد واجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي الخاصة بنا الفكرة نفسها إلى فيديو مترجم ومتوافق صوتيًا.
كيف تختار إعدادك وتستكشف أخطاءه
قبل الالتزام بعُقدة أو نموذج، أجرِ بضعة فحوصات متعمّدة بدلًا من الوثوق بعرض تجريبي قصير.
احكم على جودة الصوت باستخدام عيّنة صعبة، لا سهلة. ولّد مقطعًا يتضمن أسماء وأرقامًا واختصارات وجملًا طويلة وأسئلة ومصطلحات العلامات التجارية وسطرًا عاطفيًا واحدًا على الأقل بلغتك ولهجتك المستهدفة. فالصوت الذي يبهرك في جملة واحدة قد يشوّه اسم منتج أو يفقد إيقاعه عبر فقرة.
تحقق من دعم اللغة واللهجة لكل لغة، وليس إجمالًا. تكتشف بعض الأنظمة اللغة تلقائيًا بينما تحتاج أخرى إلى أن تضبطها، وتوصي وثائق عُقدة HeyGen بضبط اللغة يدويًا للغات المتقاربة حيث قد يكون الاكتشاف التلقائي غير موثوق. تذكّر أن الصوت الطليق لا يمكنه إنقاذ ترجمة غير دقيقة؛ فجودة الصوت وجودة الترجمة مشكلتان منفصلتان.
قِس التحكم في النطق للكلمات التي تعثّر المحركات فعليًا: أسماء المنتجات، وأسماء العَلَم، والاختصارات، والتواريخ، والعملات، والمفردات التقنية. إذا لم تقدم العُقدة قاموس نطق أو عناصر تحكم بنمط SSML، فخطط لإعادة كتابة النص صوتيًا أو تهجئة الأرقام. بالنسبة لسلسلة أو قناة ذات علامة تجارية، اختبر أيضًا الاتساق بتشغيل الصوت نفسه عبر عمليات توليد ونبرات وأقسام معاد توليدها متعددة، إذ يمكن لعمليات ComfyUI المنفصلة لمشاهد مختلفة أن تنحرف.
وازِن بين زمن الاستجابة والتكلفة والخصوصية والحقوق معًا. تبدأ العُقد المستضافة بسرعة لكنها تعتمد على سرعة الشبكة، وتوفر المزوّد، وحدود الحساب، والتسعير حسب الاستخدام، بينما تتجنب النماذج المحلية الرسوم لكل طلب لكنها تتطلب أجهزة وصيانة؛ قارن إجمالي تكلفة الإنتاج، لا السعر المُعلَن. أما بشأن الخصوصية، فتأكد من كيفية تخزين المدخلات، وما إذا كان المحتوى يدرّب النموذج، وما إذا كان يمكن حذف بيانات الصوت، وما إذا كان الاستخدام التجاري مسموحًا، ومن يملك المخرجات، وما الموافقة التي تتطلبها الأصوات المستنسخة.
عندما يسيء الرسم البياني التصرف، تتجمّع الأعطال في قائمة قصيرة. غالبًا ما تحتوي عُقدة الصوت المستنسخ التي تعيد خطأً على voice_id فارغ أو غير صالح؛ وتتوقف عُقدة HeyGen لهذا السبب بالذات. تصطدم النصوص الطويلة جدًا بالحدود، وتقبل عُقدة HeyGen Voice 1.0 الموثّقة ما يصل إلى 5000 حرف بينما تحذّر من أن الكلام الطويل جدًا قد يفشل، خصوصًا مع النصوص الصينية أو اليابانية المطوّلة، لذا قسّم السرد إلى أقسام منطقية. عادةً ما يستجيب النطق الخاطئ لإعادة كتابة الأرقام بالكلمات، أو إضافة علامات الترقيم، أو تهجئة الاختصارات. وتستدعي المخرجات المفرطة في التعبير خفض التعبيرية أو الأسلوب أو تنويع طبقة الصوت. وعندما لا يتصل الصوت بالعُقد اللاحقة، تحقق من النوع، إذ لا يمكن لمخرج AUDIO أن يغذّي عُقدة تتوقع صورة أو فيديو أو نصًا دون خطوة تحويل. وأخيرًا، احفظ رسمًا بيانيًا نظيفًا بعُقد مسمّاة وإعدادات مسجّلة، لأن المزوّد ومعرّف الصوت واللغة وتنسيق المخرجات التي استخدمتها هي التفاصيل التي ستحتاجها نسختك المستقبلية.
الأسئلة الشائعة
هل ComfyUI أداة لتحويل النص إلى كلام؟
ComfyUI هو تطبيق سير عمل قائم على العُقد وليس محرك TTS واحدًا فريدًا. يمكنه توليد الكلام عبر عُقد مدمجة، وتكاملات الشركاء، وعُقد TTS المجتمعية أو المحلية.
هل يمكن لـ ComfyUI استنساخ صوت؟
نعم، إذا كان التكامل المحدد أو العُقدة المخصصة يدعم الاستنساخ. تعتمد متطلبات التسجيل الدقيقة، وعملية معرّف الصوت، والحدود، والشروط التجارية على المزوّد.
هل يعمل تحويل النص إلى كلام في ComfyUI دون اتصال بالإنترنت؟
يمكنه ذلك عندما تستخدم نموذج TTS محليًا متوافقًا وعُقدًا محلية. تتطلب عُقد المزوّد المستضاف اتصالًا بالإنترنت وقد ترسل بيانات النص أو الصوت إلى المزوّد.
ما هي أفضل عُقدة TTS في ComfyUI؟
لا توجد عُقدة أفضل عالميًا. اختر بناءً على دعم اللغة، وجودة الصوت، واحتياجات الاستنساخ، والخصوصية، والتكلفة، وزمن الاستجابة، والتوافق مع بقية سير عملك.
هل يمكنني استخدام TTS في ComfyUI لمقاطع فيديو يوتيوب؟
نعم. ولّد السرد، وراجع النطق والحقوق، وصدّر الصوت، وزامنه مع الفيديو. إذا استخدمت صوتًا مستنسخًا أو اصطناعيًا، فالتزم بمتطلبات الموافقة والإفصاح والمنصة المعمول بها.