Een stilstaand beeld bevriest een moment, maar het kan niet laten zien hoe dat moment bewoog. Dat is de kloof die image-to-video AI opvult. Als je je afvraagt wat image to video ai is, luidt het korte antwoord: het is een generatieve mediatechnologie die één statisch beeld—een foto, illustratie, productfoto of door AI gegenereerd kunstwerk—neemt en het tot een korte videoclip animeert door nieuwe frames te verzinnen die schijnbare beweging, camerabeweging en soms geluid creëren. Je levert een afbeelding aan, beschrijft wat er moet gebeuren, en het model voorspelt en rendert de tussenliggende frames.
Dat klinkt eenvoudig, maar de beslissing erachter gaat niet alleen over "kan deze tool een coole clip maken." Het gaat erom of de gegenereerde beweging trouw blijft aan je bron, past bij je platform en een merk- of nauwkeurigheidscontrole doorstaat. Deze gids legt het mechanisme uit, wat je kunt beheersen, waar het past in een echte productie, en hoe wij Image to Video binnen DubSmart AI behandelen als één fase van een grotere mediaworkflow.
Inhoudsopgave
Hoe image-to-video AI verschilt van zijn gelijkenissen
De verwarring begint meestal hier, omdat verschillende tools op elkaar lijken maar verschillende taken uitvoeren. Image-to-video AI genereert een reeks nieuwe frames zodat een statisch beeld lijkt te bewegen in de tijd. Dat ene onderscheid scheidt het van alles waarmee het wordt verward.
- Text-to-video bouwt een clip op uit alleen een geschreven beschrijving, zonder beginafbeelding.
- Beeldanimatie past eenvoudigere effecten toe—zoom, pan, parallax—zonder werkelijk nieuwe onderwerpbeweging te synthetiseren.
- Diavoorstelling maken doorloopt meerdere stilstaande beelden maar genereert nooit continue beweging binnen één frame.
- Video-to-video herstyleert of bewerkt bestaand beeldmateriaal in plaats van te beginnen vanuit één afbeelding.
Dus een diavoorstelling die van foto A naar foto B wisselt is geen image-to-video. Evenmin is een pan in Ken Burns-stijl over één afbeelding dat. Het bepalende kenmerk is framesynthese: het model creëert beweging die nooit is vastgelegd, verankerd aan het ene frame dat je hebt aangeleverd.
Als nasynchronisatie, transcriptie en lokalisatie elders in je stack zitten, brengt onze uitleg over alles-in-één AI-videotools per gebruiksscenario in kaart waar image-to-video naast die taken past.
Hoe de generatie daadwerkelijk werkt
Aanbieders gebruiken verschillende modellen, maar de pijplijn komt neer op vier samenhangende capaciteiten. Het begrijpen ervan vertelt je waarom sommige clips naadloos ogen en andere vervormen.
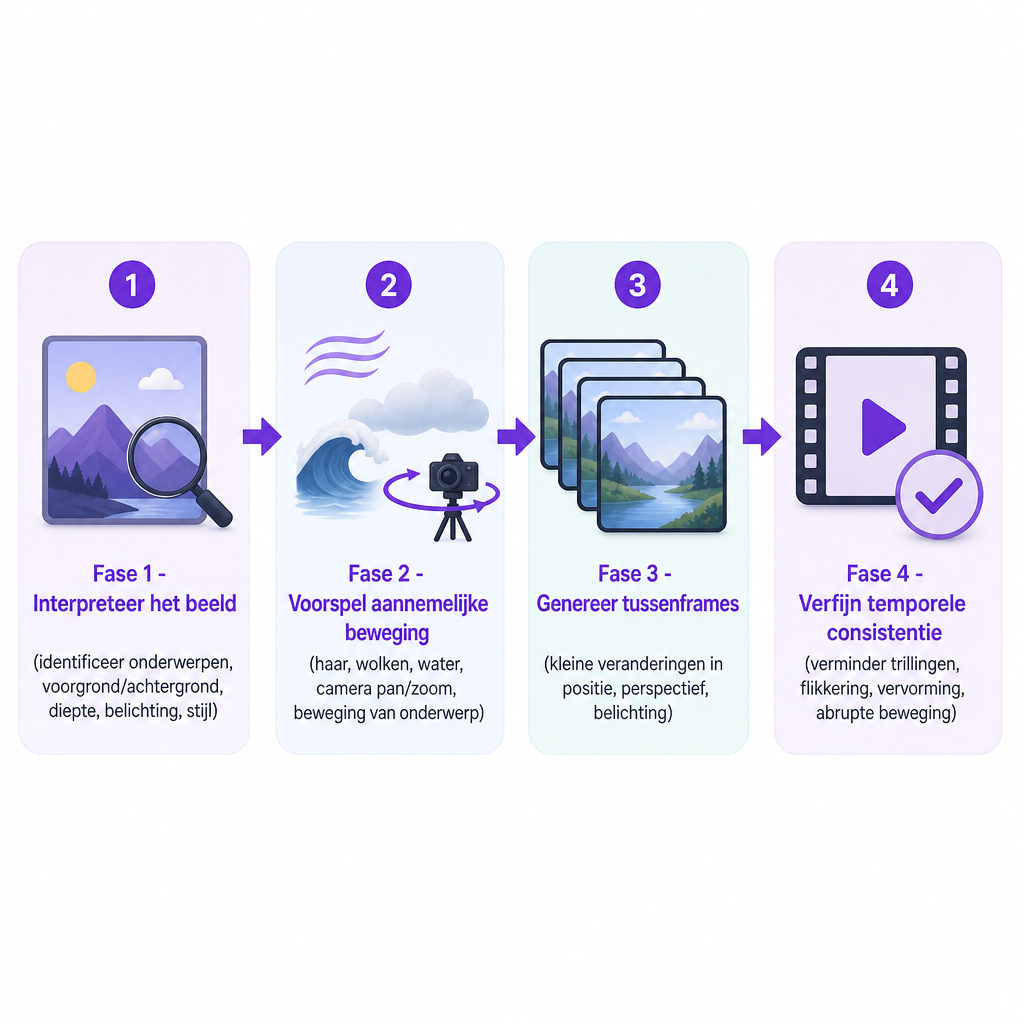
Het interpreteert eerst de afbeelding. Het model onderzoekt de upload om mensen, dieren, producten en objecten te identificeren, scheidt vervolgens voorgrond van achtergrond en schat relatieve positie, diepte, belichting en visuele stijl in. Het beeld wordt een werkende weergave van een scène in plaats van een plat oppervlak.
Het voorspelt vervolgens plausibele beweging. Vanuit die weergave schat het model in hoe de scène zou kunnen veranderen: hoe haar of stof zou kunnen bewegen, hoe wolken, rook, water of bladeren zouden kunnen bewegen, hoe licht over een object zou kunnen reizen, en hoe een camera zou kunnen pannen, kantelen, zoomen of inrijden. Deze voorspellingen zijn geen opname van iets dat is gebeurd. Het zijn gegenereerde mogelijkheden, afgeleid van de afbeelding, je prompt en patronen die tijdens training zijn geleerd.
Het genereert daarna de frames ertussen. Het systeem rendert een reeks frames met kleine veranderingen in positie, perspectief, belichting of vorm. Achter elkaar afgespeeld lezen die frames als continue beweging. Dit is de kern: de tool onthult geen verborgen beeldmateriaal, het synthetiseert wat zou kunnen verschijnen tussen momenten die nooit zijn gefilmd.
Het verfijnt tot slot de temporele consistentie. Ten slotte maakt het model overgangen soepeler om trillingen, flikkeringen, plotselinge belichtingsverschuivingen, vervormde objecten, inconsistente gezichten en abrupte camerabewegingen te onderdrukken. Hoe goed dat lukt hangt af van het model, de bronafbeelding, de prompt en hoe complex de gevraagde actie is. Hoe meer je het model laat verzinnen, hoe harder deze fase moet werken.
Wat je kunt beheersen, en wat de bronafbeelding bepaalt
De sterkste resultaten komen voort uit het regisseren van beweging, niet uit het herschrijven van het hele beeld in proza. Een betrouwbare prompt benoemt vier dingen: onderwerp, actie, camerabeweging en visuele stijl.
Een keramische koffiemok op een houten tafel, zacht opstijgende stoom, langzame camera-inrijding, warm ochtendlicht, realistische productvideo.
Vanaf daar kun je meestal onderwerpbeweging specificeren (lopen, draaien, roteren, opstaan), omgevingsbeweging (wind, regen, rook, vallende bladeren), camerabeweging (pan, kantelen, dolly in of uit, uit de hand, statisch), tempo (zacht tot snel), sfeer (filmisch, documentair, kalmerend) en uitvoerformaat (liggend, vierkant, verticaal). We raden aan de eerste prompt eenvoudig te houden en je te richten op de beweging die je echt wilt.
Het addertje is dat je prompt moet aansluiten bij wat de afbeelding kan ondersteunen. Een portret oogt doorgaans natuurlijk met subtiele gezichts- of camerabeweging en onnatuurlijk als je het onderwerp laat sprinten. Een landschap leest vaak beter met een langzame pan of omgevingsbeweging dan met snelle onderwerpactie. Een productfoto bevoordeelt meestal gecontroleerde rotatie, een lichtstreek of een geleidelijke onthulling. Elke graad van dramatische beweging dwingt het model meer visuele informatie te verzinnen—en verzinnen is waar artefacten verschijnen.
Daarom draagt de bronafbeelding zoveel gewicht. Het bepaalt het onderwerp, de compositie, de belichting en de stijl waarmee het model moet werken. Voor sterkere uitvoer begin je met een duidelijk, herkenbaar onderwerp, goede belichting, scherp detail, minimale artefacten, een weloverwogen compositie, genoeg lege ruimte voor de gewenste beweging, en onderscheiden voorgrond- en achtergrondlagen. Een drukke, wazige of zwaar bijgesneden afbeelding geeft het model minder om mee te redeneren—een afbeelding die strak op een gezicht is ingekaderd laat zelden ruimte voor een brede camerabeweging. Een sterke bron garandeert geen perfecte clip, maar geeft het model een veel beter startpunt. Als je die stilstaande beelden vanaf nul genereert, kan onze AI-beeldgenerator ze produceren voordat je animeert.
Waar makers en teams het daadwerkelijk gebruiken
Image-to-video verdient zijn plek wanneer de beweging de boodschap dient, niet wanneer het decoratie is omwille van zichzelf.
- Sociale media. Verander foto's, thumbnails, illustraties of gegenereerde kunstwerken in korte clips voor Shorts, Reels en TikTok. Verticale uitvoer is het belangrijkst wanneer het originele beeld voor mobiel is gebouwd.
- Productmarketing. Animeer een productafbeelding met een subtiele zoom, rotatie, belichtingsverschuiving of achtergrondbeweging om een statisch asset te laten opvallen in een advertentie.
- YouTube en videoproductie. Gebruik clips als intro's, outro's, B-roll, vestigingsshots, overgangen of achtergrondsequenties achter voice-over—leg vervolgens voice-over, muziek, ondertitels of nasynchronisatie eroverheen.
- E-learning en training. Voeg beweging toe aan diagrammen, historische beelden en presentatiebeelden, maar alleen waar de beweging een idee verduidelijkt.
- Storyboarding en conceptwerk. Animeer stilstaande beelden om sfeer, kadrering en cameraregie te verkennen voordat je je aan een volledige opname verbindt.
- Vastgoed en reizen. Transformeer een goed gekozen pand- of bestemmingsbeeld in een korte sfeervolle clip—zonder kenmerken te suggereren die de echte locatie niet heeft.
In elk geval is de clip een component. Een YouTube-maker kan verschillende illustraties animeren, ze in een editor samenstellen, voice-over genereren en de voltooide video lokaliseren voor andere markten.
Onze Image to Video-opties bij DubSmart AI
Onze Image to Video-generator gebruikt de geüploade afbeelding als eerste frame, wat de openingscompositie en visuele stijl vastlegt. Je voegt een tekstprompt toe die onderwerpbeweging, camerahoeken of scènedynamiek beschrijft, kiest duur en kwaliteit, en downloadt de clip.
| Optie | Ons aanbod |
|---|---|
| Clipduur | 4, 6 of 8 seconden |
| Kwaliteitsniveaus | Standaard, Hoog, Ultra Hoog |
| Audio | Hoog en Ultra Hoog bevatten geluid |
| Liggende formaten | 1280×720 en 1920×1080 |
| Vierkant formaat | 1024×1024 |
| Verticaal formaat | 720×1280 |
| Invoer | Een hoogwaardige afbeelding plus een bewegingsprompt |
We hebben de tool gebouwd voor sociale media, reclame, artistieke projecten en grotere videoproducties. Bevestig voor specifieke prijzen of creditverbruik de actuele cijfers in je DubSmart-account of planinformatie voordat je een productie opzet, aangezien die details bij je plan horen en niet op de openbare toolpagina staan.
Hoe je een tool voor de klus kiest
De juiste tool hangt af van de content die je moet leveren, niet van de vraag of hij één indrukwekkende demo kan produceren. Een paar criteria scheiden een nieuwtje van iets dat je in een herhaalbare workflow kunt gebruiken.
Controle over bronafbeelding. Controleer of de tool je afbeelding behandelt als een strikt eerste frame, een losse referentie of alleen een stijlgids. Een eerste-frame-aanpak houdt de openingscompositie gebonden aan je bron—handig wanneer het beginshot ertoe doet.
Bewegingscontrole. Zoek naar duidelijke ondersteuning voor onderwerpbeweging, camerabeweging, omgevingseffecten, snelheid en stijl. Aantrekkelijke maar onvoorspelbare beweging is moeilijk te reproduceren wanneer je consistentie over meerdere clips nodig hebt.
Duur en formaten. Stem beschikbare duren en beeldverhoudingen af op je bestemming. Korte clips passen bij sociale posts, advertenties, overgangen en inserts; bevestig dat de verticale, vierkante en liggende opties aansluiten bij waar de clip zal draaien.
Audio. Beslis of je een stille beeld nodig hebt voor latere bewerking, omgevingsgeluid, muziek, effecten of een volledig gegenereerde track. Gegenereerde audio moet nog steeds worden gecontroleerd op timing en relevantie voordat deze wordt gepubliceerd.
Consistentie. Als een gezicht, product, logo of personage overal identiek moet blijven, test dan eerst meerdere generaties. Modellen kunnen stilletjes kleine details veranderen—handen, tekst binnen een afbeelding, logo's, architectonische lijnen—terwijl ze frames synthetiseren.
Bewerkingscompatibiliteit. Bevestig dat je een praktisch formaat in de juiste resolutie kunt downloaden, het kunt combineren met live-action beeldmateriaal, en ondertitels, voice-over of nasynchronisatie kunt toevoegen zonder de kadrering te verliezen die je editor nodig heeft. Voor teams die al stem en gelokaliseerde media bij ons produceren, past Image to Video in één workflow in plaats van weer een losstaande tool toe te voegen.
Beperkingen, risico's en rechten die je niet kunt overslaan
Image-to-video AI reconstrueert geen echt beeldmateriaal uit een stilstaand beeld. Het genereert een plausibele interpretatie van beweging, en dat onderscheid bepaalt elke beperking die het waard is om op te plannen.
Gezichten, vingers, tekst, logo's en productdetails kunnen tussen frames verschuiven, dus beoordeel de hele clip in plaats van de eerste preview te beoordelen. Het model kan ook diepte, objectgrenzen of oorzaak en gevolg verkeerd interpreteren—met onnatuurlijke beweging, buigende objecten of een camerabeweging die verzonnen detail onthult tot gevolg. Vage prompts als "laat het bewegen" geven vrijwel geen richting; specifieke beschrijvingen van onderwerp, beweging, camera en sfeer sturen het model veel beter. En omdat de technologie het sterkst is bij korte clips, werkt een gegenereerde sequentie goed als insert of social asset maar vervangt het geen complete gefilmde scène.
De risico's die het meest tellen zijn ethisch en juridisch. Een gegenereerde clip mag nooit suggereren dat een persoon een actie heeft uitgevoerd, dat een product een kenmerk heeft, of dat een echte plek is veranderd wanneer niets daarvan is gebeurd—een grens die vooral telt in reclame, nieuws, onderwijs en klantcommunicatie. Wat betreft rechten: gebruik alleen afbeeldingen die je toestemming hebt om te verwerken en te publiceren, en wees voorzichtig met foto's van identificeerbare personen, merkmaterialen, auteursrechtelijk beschermde kunstwerken, materialen in eigendom van klanten, privé-informatie, afbeeldingen van beroemdheden en door AI gegenereerde afbeeldingen met onzekere gebruiksvoorwaarden. Het transformeren van een invoer geeft je geen rechten op de invoer of de resulterende video.
Veelgestelde vragen
Wat is image to video AI in eenvoudige bewoordingen?
Het is AI-software die een stilstaand beeld omzet in een korte bewegende video door nieuwe frames te genereren op basis van de afbeelding en een bewegingsinstructie die jij aanlevert.
Kan image-to-video AI geluid toevoegen?
Sommige tools genereren geluid terwijl andere stille video produceren voor latere bewerking. Onze kwaliteitsopties Hoog en Ultra Hoog bevatten geluid; controleer gegenereerde audio op timing en relevantie voordat je publiceert.
Welke afbeeldingen werken het beste?
Duidelijke, goed belichte afbeeldingen met een herkenbaar onderwerp, onderscheiden voorgrond- en achtergrondgebieden, scherp detail en minimale artefacten geven het model een sterker startpunt dan drukke of wazige bronnen.
Hoe lang zijn DubSmart AI image-to-video-clips?
We bieden duren van 4, 6 en 8 seconden, in liggend, vierkant en verticaal formaat.
Kan ik verticale video's maken voor TikTok of YouTube Shorts?
Ja. We bieden een verticaal formaat van 720×1280 naast vierkante en liggende resoluties, zodat clips passen bij mobile-first platforms.
Is image-to-video AI geschikt voor zakelijke content?
Het kan werken voor advertenties, productbeelden, training, sociale content en conceptontwikkeling, mits je de uitvoer controleert op nauwkeurigheid, merkconsistentie, rechten, toestemming en misleidende visuele claims voordat deze live gaat.