静止画像は一瞬を切り取りますが、その瞬間がどう動いたかを示すことはできません。そのギャップを埋めるのが画像から動画へのAIです。「画像から動画へのAIとは何か」と問うなら、簡潔な答えはこうです。それは、写真、イラスト、商品写真、AI生成アートワークといった1枚の静止画を取り込み、見かけ上の動き、カメラの動き、時には音声を生み出す新しいフレームを創り出すことで、短い動画クリップへとアニメーション化する生成メディア技術です。あなたは画像を提供し、何が起こるべきかを記述すると、モデルがその中間フレームを予測してレンダリングします。
これは単純に聞こえますが、その背後にある判断は「このツールはかっこいいクリップを作れるか」だけではありません。生成された動きがソースに忠実であり続けるか、あなたのプラットフォームに適しているか、そしてブランドや正確性のレビューを通過できるかどうかです。このガイドでは、その仕組み、あなたがコントロールできること、実際の制作のどこに適合するか、そして私たちがDubSmart AI内でより大きなメディアワークフローの一段階として画像から動画をどう扱っているかを説明します。
目次
画像から動画へのAIが類似技術とどう違うか
混乱はたいていここから始まります。いくつかのツールが似たように聞こえながら、異なる仕事をするからです。画像から動画へのAIは、静止画が時間とともに動いて見えるよう、新しいフレームのシーケンスを生成します。その1つの違いが、間違えられがちなすべてのものと区別する決め手です。
- テキストから動画は、開始画像を使わず、書かれた説明だけからクリップを構築します。
- 画像アニメーションは、本当に新しい被写体の動きを合成せずに、ズーム、パン、パララックスといったより単純なエフェクトを適用します。
- スライドショー作成は、複数の静止画を順に表示しますが、フレーム内で連続した動きを生成することはありません。
- 動画から動画は、1枚の画像から始めるのではなく、既に存在する映像をリスタイルまたは編集します。
したがって、写真Aから写真Bに切り替わるスライドショーは画像から動画ではありません。1枚の写真を横切るケン・バーンズ風のパンもそうではありません。決定的な特徴はフレーム合成です。モデルが、あなたが与えた1つのフレームを基点として、決して撮影されなかった動きを創り出すのです。
吹き替え、文字起こし、ローカライズがあなたのスタックの別の場所にあるなら、用途別のオールインワンAI動画ツールについての解説記事で、画像から動画がそれらのタスクと並んでどこに適合するかを整理しています。
生成が実際にどのように機能するか
プロバイダーはそれぞれ異なるモデルを使いますが、パイプラインは4つの連携した機能に集約されます。それらを理解すれば、なぜあるクリップはシームレスに見え、別のものは歪むのかが分かります。
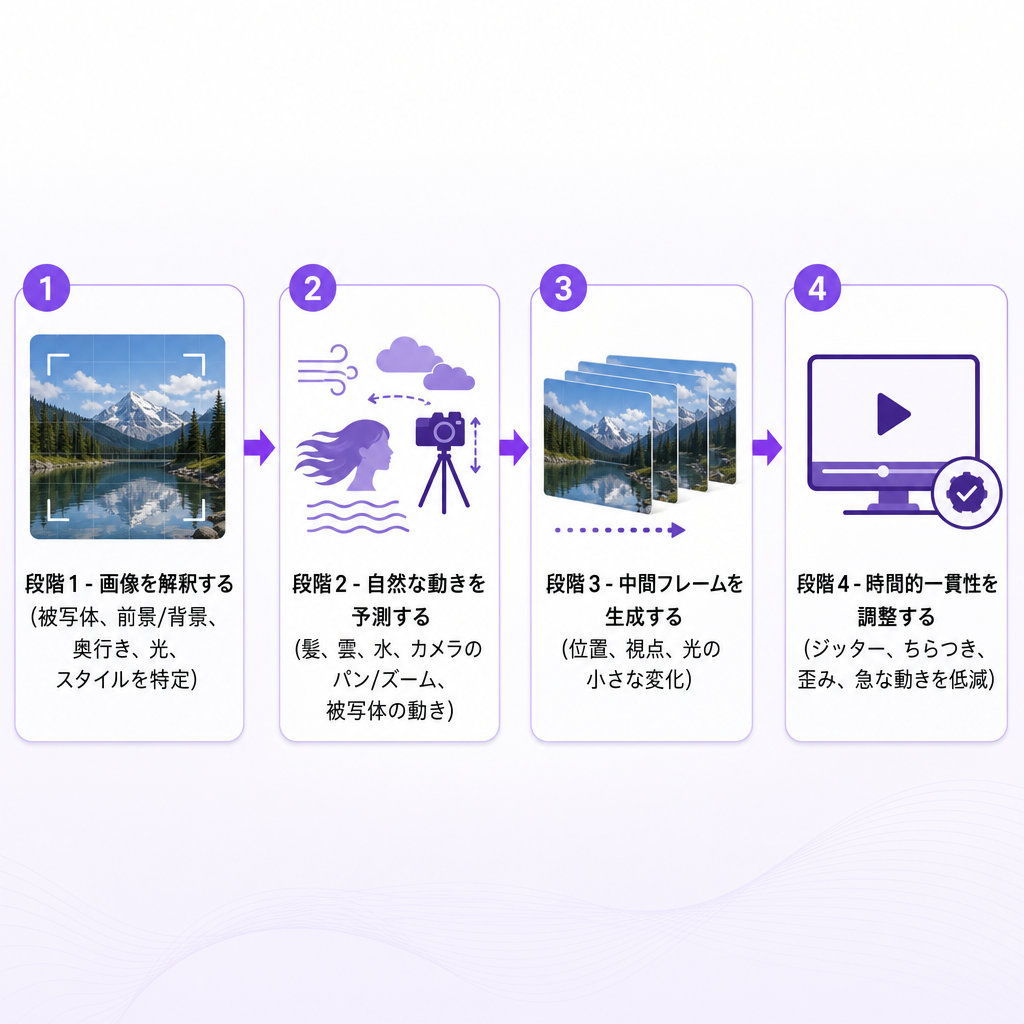
まず画像を解釈します。モデルはアップロードされたものを調べて、人、動物、商品、物体を識別し、前景と背景を分離し、相対的な位置、奥行き、照明、視覚スタイルを推定します。その画像は、平らな表面ではなく、シーンの作業用表現になります。
次にもっともらしい動きを予測します。その表現から、モデルはシーンがどう変化しうるかを推定します。髪や布がどう動くか、雲、煙、水、葉がどう動くか、光が物体をどう横切るか、カメラがどうパン、チルト、ズーム、プッシュインするか。これらの予測は実際に起こったことの記録ではありません。画像、あなたのプロンプト、そして学習で習得したパターンから引き出された、生成された可能性です。
その間のフレームを生成します。システムは、位置、遠近、照明、または形状にわずかな変化を加えた一連のフレームをレンダリングします。連続して再生されると、それらのフレームは連続した動きとして読み取られます。ここが肝心です。ツールは隠された映像を明らかにしているのではなく、決して撮影されなかった瞬間の間に現れうるものを合成しているのです。
最後に時間的一貫性を精緻化します。最後にモデルは、ジッター、ちらつき、突然の照明変化、歪んだ物体、一貫性のない顔、急なカメラの動きを抑えるために遷移を滑らかにします。どれだけうまくいくかは、モデル、ソース画像、プロンプト、そして要求されたアクションの複雑さによります。モデルに創り出すことを多く求めるほど、この段階の負荷は大きくなります。
あなたがコントロールできること、ソース画像が決めること
最も優れた結果は、画像全体を文章で書き直すのではなく、動きを指示することから生まれます。信頼できるプロンプトは4つのことを指定します。被写体、アクション、カメラの動き、視覚スタイルです。
木製テーブルの上にあるセラミックのコーヒーマグ、湯気が静かに立ち上り、ゆっくりとしたカメラのプッシュイン、暖かい朝の光、リアルな商品動画。
そこから通常、被写体の動き(歩く、振り向く、回転する、立ち上がる)、環境の動き(風、雨、煙、落ち葉)、カメラの動き(パン、チルト、ドリーイン・アウト、手持ち、静止)、テンポ(穏やかから速い)、ムード(映画的、ドキュメンタリー、落ち着いた)、出力フォーマット(横長、正方形、縦長)を指定できます。最初のプロンプトはシンプルに保ち、実際に望む動きに焦点を当てることをお勧めします。
難しいのは、あなたのプロンプトが画像の支えられるものと一致しなければならないことです。ポートレートは、繊細な表情やカメラの動きでは自然に見える傾向があり、被写体に全力疾走を求めると不自然になります。風景は、急な被写体のアクションよりも、ゆっくりしたパンや環境の動きの方がよく見えることが多いです。商品写真は通常、制御された回転、光のスイープ、または段階的な見せ方を好みます。劇的な動きの度合いが増すたびに、モデルはより多くの視覚情報を創り出さなければならず、創出こそがアーティファクトが現れる場所です。
だからこそソース画像は非常に大きな重みを持ちます。それはモデルが基にしなければならない被写体、構図、照明、スタイルを設定します。より強い出力のためには、明確で認識しやすい被写体、良い照明、鋭いディテール、最小限のアーティファクト、意図的な構図、望む動きのための十分な空きスペース、そして明確な前景と背景のレイヤーから始めてください。込み入った、ぼやけた、または大きくトリミングされた画像は、モデルに推論の材料を与えません。顔にタイトにフレーミングされた画像は、広いカメラの動きの余地をほとんど残しません。強いソースが完璧なクリップを保証するわけではありませんが、モデルにはるかに良い出発点を与えます。それらの静止画をゼロから生成する場合、私たちのAI画像ジェネレーターが、アニメーション化する前にそれらを生成できます。
クリエイターやチームが実際にどこで使っているか
画像から動画は、動きがそれ自体の装飾ではなく、メッセージに役立つときにその価値を発揮します。
- ソーシャルメディア。写真、サムネイル、イラスト、生成アートワークを、Shorts、Reels、TikTok向けの短いクリップに変えます。元のビジュアルがモバイル向けに作られていた場合、縦長出力が最も重要になります。
- 商品マーケティング。商品画像に繊細なズーム、回転、照明の変化、または背景の動きを加えて、静的なアセットを広告で際立たせます。
- YouTubeと動画制作。クリップをイントロ、アウトロ、Bロール、確立ショット、トランジション、またはナレーションの背後の背景シーケンスとして使い、その上にボイスオーバー、音楽、キャプション、または吹き替えを重ねます。
- eラーニングとトレーニング。図、歴史的な画像、プレゼンテーションのビジュアルに動きを加えますが、動きがアイデアを明確にする場合に限ります。
- 絵コンテとコンセプトワーク。本格的な撮影に踏み切る前に、静止画をアニメーション化してムード、フレーミング、カメラの方向を探ります。
- 不動産と旅行。適切に選ばれた物件や目的地の画像を、短い雰囲気のあるクリップに変えます。ただし、実際の場所にない特徴を暗示することなく。
いずれの場合も、クリップは1つの構成要素です。YouTubeクリエイターは、複数のイラストをアニメーション化し、エディターで組み立て、ナレーションを生成し、完成した動画を他の市場向けにローカライズするかもしれません。
DubSmart AIでの画像から動画のオプション
私たちの画像から動画ジェネレーターは、アップロードされた画像を最初のフレームとして使用し、これにより冒頭の構図と視覚スタイルが固定されます。被写体の動き、カメラアングル、シーンのダイナミクスを記述するテキストプロンプトを追加し、長さと品質を選び、クリップをダウンロードします。
| オプション | 私たちの提供内容 |
|---|---|
| クリップの長さ | 4秒、6秒、または8秒 |
| 品質レベル | 標準、高、超高 |
| 音声 | 高と超高には音声が含まれます |
| 横長フォーマット | 1280×720 と 1920×1080 |
| 正方形フォーマット | 1024×1024 |
| 縦長フォーマット | 720×1280 |
| 入力 | 高品質な画像とモーションプロンプト |
私たちはこのツールを、ソーシャルメディア、広告、アート作品、より大きな動画制作のために作りました。具体的な価格やクレジット消費については、制作の範囲を定める前に、DubSmartアカウントまたはプラン情報で最新の数字をご確認ください。これらの詳細は公開ツールページではなく、お客様のプランに紐づいているためです。
目的に合ったツールの選び方
適切なツールは、1つの印象的なデモを作れるかどうかではなく、あなたが提供する必要があるコンテンツによって決まります。いくつかの基準が、目新しさと、繰り返し可能なワークフローで使えるものを区別します。
ソース画像のコントロール。ツールがあなたの画像を厳密な最初のフレームとして扱うか、緩やかな参照として扱うか、それともスタイルガイドとしてのみ扱うかを確認してください。最初のフレームアプローチは、冒頭の構図をソースに結びつけたままにします。開始ショットが重要なときに役立ちます。
モーションコントロール。被写体の動き、カメラの動き、環境効果、速度、スタイルの明確なサポートを探してください。魅力的だが予測不可能な動きは、複数のクリップにわたって一貫性が必要なときに再現するのが困難です。
長さとフォーマット。利用可能な長さとアスペクト比を、使用先に合わせてください。短いクリップはソーシャル投稿、広告、トランジション、挿入に適しています。縦長、正方形、横長のオプションが、クリップを使う場所と一致することを確認してください。
音声。後で編集するための無音ビジュアルが必要か、環境音、音楽、効果音、または完全に生成されたトラックが必要かを決めてください。生成された音声は、提供前にタイミングと関連性についてレビューすべきです。
一貫性。顔、商品、ロゴ、またはキャラクターが全体を通して同一でなければならない場合は、まず複数回の生成をテストしてください。モデルはフレームを合成する際に、手、画像内のテキスト、ロゴ、建築のラインといった小さなディテールを静かに変えてしまうことがあります。
編集との互換性。適切な解像度で実用的なフォーマットをダウンロードでき、実写映像と組み合わせられ、エディターが必要とするフレーミングを失うことなくキャプション、ナレーション、または吹き替えを追加できることを確認してください。すでに私たちと音声やローカライズされたメディアを制作しているチームにとって、画像から動画は、もう1つのスタンドアロンツールを追加するのではなく、1つのワークフローに収まります。
見逃せない制約、リスク、権利
画像から動画へのAIは、静止画から実際の映像を再構築するわけではありません。それは動きのもっともらしい解釈を生成するものであり、その違いが計画しておくべきすべての制約を左右します。
顔、指、テキスト、ロゴ、商品のディテールはフレーム間で変化する可能性があるため、最初のプレビューで判断するのではなく、クリップ全体をレビューしてください。モデルはまた、奥行き、物体の境界、または因果関係を読み違え、不自然な動き、曲がった物体、または創作されたディテールを明らかにするカメラの動きを生み出すことがあります。「動かして」のような曖昧なプロンプトはほとんど方向性を与えません。被写体、動き、カメラ、ムードの具体的な記述の方が、モデルをはるかにうまく導きます。そしてこの技術は短いクリップで最も強いため、生成されたシーケンスは挿入やソーシャルアセットとしてはうまく機能しますが、完全に撮影されたシーンを置き換えることはできません。
最も重要なリスクは倫理的・法的なものです。生成されたクリップは、実際には起こっていないのに、人物がある行動をした、商品にある機能がある、または実在の場所が変わったと決して暗示すべきではありません。これは特に広告、ニュース、教育、顧客向けコミュニケーションで重要な一線です。権利については、処理して公開する許可を持つ画像のみを使用し、識別可能な人物の写真、ブランドアセット、著作権で保護されたアートワーク、クライアント所有の素材、個人情報、有名人の肖像、使用条件が不確かなAI生成画像には注意してください。入力を変換しても、入力や結果として生じた動画に対する権利を得られるわけではありません。
よくある質問
画像から動画へのAIとは、簡単に言うと何ですか?
それは、画像とあなたが提供する動きの指示に基づいて新しいフレームを生成することで、静止画を短い動く動画に変えるAIソフトウェアです。
画像から動画へのAIは音声を追加できますか?
一部のツールは音声を生成し、他のツールは後で編集するための無音動画を生成します。私たちの高品質と超高品質のオプションには音声が含まれます。公開前に、生成された音声のタイミングと関連性をレビューしてください。
どのような画像が最も効果的ですか?
認識しやすい被写体、明確な前景と背景のエリア、鋭いディテール、最小限のアーティファクトを備えた、明るく照らされた鮮明な画像は、込み入ったりぼやけたりしたソースよりも、モデルにより強い出発点を与えます。
DubSmart AIの画像から動画クリップの長さはどれくらいですか?
横長、正方形、縦長のフォーマットで、4秒、6秒、8秒の長さを提供しています。
TikTokやYouTube Shorts向けの縦長動画を作成できますか?
はい。正方形と横長の解像度に加えて720×1280の縦長フォーマットを提供しているので、クリップはモバイルファーストのプラットフォームに適合します。
画像から動画へのAIはビジネスコンテンツに適していますか?
広告、商品ビジュアル、トレーニング、ソーシャルコンテンツ、コンセプト開発に活用できます。ただし、公開前に、正確性、ブランドの一貫性、権利、同意、および誤解を招く視覚的主張がないかについて出力をレビューすることが条件です。