Un'immagine statica congela un momento, ma non può mostrare come quel momento si sia mosso. È proprio questo il divario che l'IA image-to-video colma. Se ti stai chiedendo cos'è l'IA image to video, la risposta breve è questa: è una tecnologia di media generativi che prende un singolo elemento visivo statico—una foto, un'illustrazione, lo scatto di un prodotto o un'opera generata dall'IA—e lo anima in un breve videoclip inventando nuovi fotogrammi che creano un movimento apparente, movimenti di camera e talvolta audio. Fornisci un'immagine, descrivi cosa dovrebbe accadere, e il modello prevede e renderizza i fotogrammi intermedi.
Sembra semplice, ma la decisione che sta dietro non è solo "questo strumento può creare un clip accattivante". Si tratta di capire se il movimento generato rimane fedele alla tua sorgente, si adatta alla tua piattaforma e supera una revisione di brand o di accuratezza. Questa guida spiega il meccanismo, cosa puoi controllare, dove si inserisce in una produzione reale e come gestiamo Image to Video all'interno di DubSmart AI come una fase di un flusso di lavoro mediatico più ampio.
Indice dei contenuti
In cosa l'IA image-to-video differisce dai suoi simili
La confusione di solito nasce qui, perché diversi strumenti sembrano simili ma svolgono compiti diversi. L'IA image-to-video genera una sequenza di nuovi fotogrammi in modo che un elemento visivo statico sembri muoversi nel tempo. Quella singola distinzione la separa da tutto ciò con cui viene confusa.
- Text-to-video costruisce un clip solo da una descrizione scritta, senza un'immagine di partenza.
- Animazione di immagini applica effetti più semplici—zoom, panoramica, parallasse—senza sintetizzare un movimento del soggetto realmente nuovo.
- Creazione di slideshow scorre tra più immagini statiche ma non genera mai un movimento continuo all'interno di un fotogramma.
- Video-to-video ristilizza o modifica filmati già esistenti invece di partire da un'immagine.
Quindi uno slideshow che passa dalla foto A alla foto B non è image-to-video. Né lo è una panoramica in stile Ken Burns su una singola immagine. Il tratto distintivo è la sintesi di fotogrammi: il modello crea un movimento che non è mai stato catturato, ancorato all'unico fotogramma che gli hai fornito.
Se doppiaggio, trascrizione e localizzazione si trovano altrove nel tuo stack, il nostro approfondimento sugli strumenti video IA all-in-one per caso d'uso mostra dove si colloca image-to-video insieme a quei compiti.
Come funziona davvero la generazione
I provider utilizzano modelli diversi, ma il processo si riduce a quattro capacità collegate. Comprenderle ti dice perché alcuni clip sembrano impeccabili e altri si deformano.
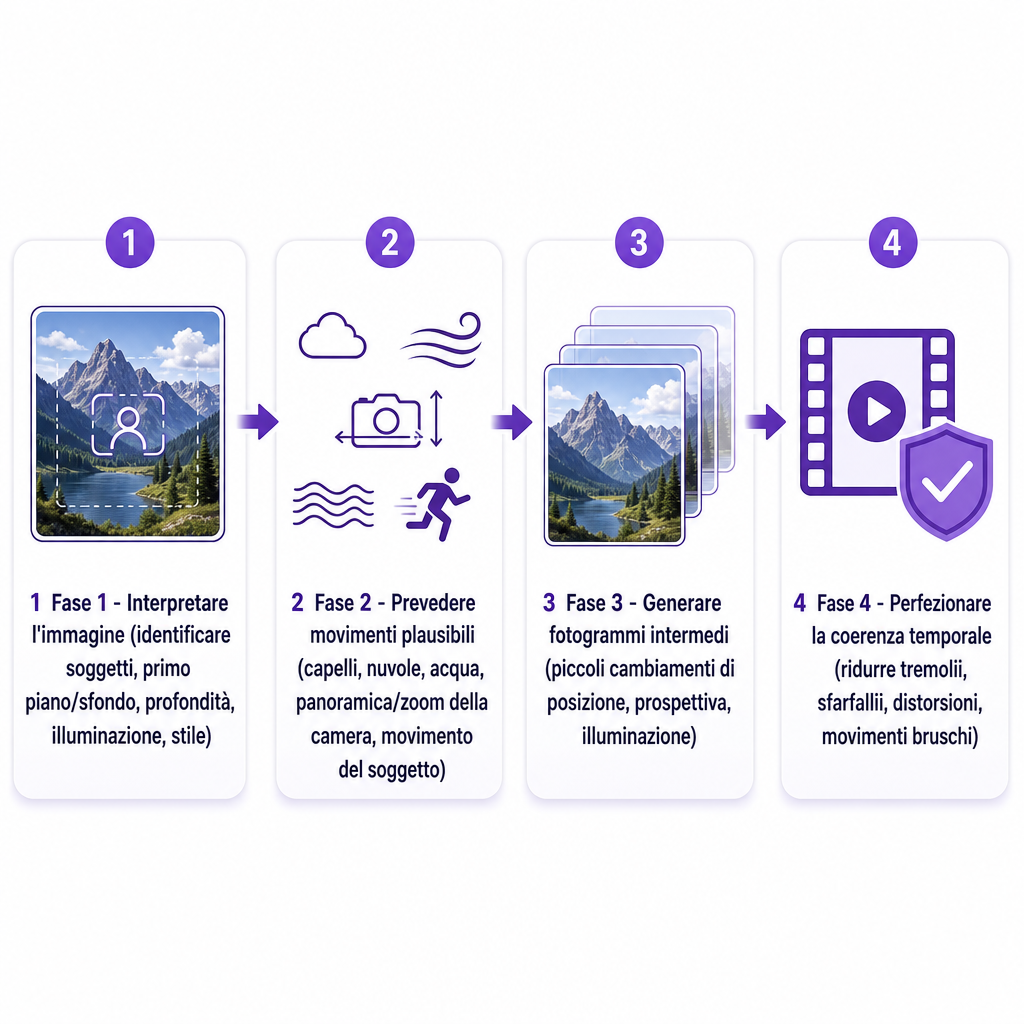
Prima interpreta l'immagine. Il modello esamina il caricamento per identificare persone, animali, prodotti e oggetti, poi separa il primo piano dallo sfondo e stima la posizione relativa, la profondità, l'illuminazione e lo stile visivo. L'immagine diventa una rappresentazione operativa di una scena piuttosto che una superficie piatta.
Poi prevede un movimento plausibile. A partire da quella rappresentazione, il modello stima come la scena potrebbe cambiare: come i capelli o i tessuti potrebbero muoversi, come nuvole, fumo, acqua o foglie potrebbero spostarsi, come la luce potrebbe spostarsi su un oggetto e come una camera potrebbe effettuare una panoramica, un'inclinazione, uno zoom o un avvicinamento. Queste previsioni non sono una registrazione di qualcosa che è accaduto. Sono possibilità generate derivate dall'immagine, dal tuo prompt e dai pattern appresi durante l'addestramento.
Poi genera i fotogrammi intermedi. Il sistema renderizza una serie di fotogrammi con piccoli cambiamenti di posizione, prospettiva, illuminazione o forma. Riprodotti consecutivamente, quei fotogrammi vengono percepiti come un movimento continuo. Questo è il punto cruciale: lo strumento non sta rivelando filmati nascosti, sta sintetizzando ciò che potrebbe apparire tra momenti che non sono mai stati filmati.
Infine rifinisce la coerenza temporale. Alla fine il modello leviga le transizioni per sopprimere tremolii, sfarfallii, improvvisi cambi di illuminazione, oggetti deformati, volti incoerenti e movimenti bruschi della camera. Quanto ci riesce bene dipende dal modello, dall'immagine sorgente, dal prompt e da quanto è complessa l'azione richiesta. Più chiedi al modello di inventare, più questa fase lavora duramente.
Cosa puoi controllare e cosa decide l'immagine sorgente
I risultati migliori provengono dal dirigere il movimento, non dal riscrivere l'intera immagine in prosa. Un prompt affidabile nomina quattro cose: soggetto, azione, movimento di camera e stile visivo.
Una tazza da caffè in ceramica su un tavolo di legno, vapore che sale delicatamente, lento avvicinamento della camera, calda luce mattutina, video di prodotto realistico.
Da lì puoi solitamente specificare il movimento del soggetto (cammina, si gira, ruota, si alza), il movimento ambientale (vento, pioggia, fumo, foglie che cadono), il movimento di camera (panoramica, inclinazione, carrellata in avanti o indietro, a mano libera, statica), il ritmo (da delicato a rapido), l'atmosfera (cinematografica, documentaristica, rilassante) e il formato di output (orizzontale, quadrato, verticale). Ti consigliamo di mantenere semplice il primo prompt e di concentrarti sul movimento che vuoi realmente.
Il problema è che il tuo prompt deve corrispondere a ciò che l'immagine può supportare. Un ritratto tende ad apparire naturale con un sottile movimento facciale o di camera e innaturale se chiedi al soggetto di scattare. Un paesaggio spesso rende meglio con una lenta panoramica o un movimento ambientale che con un'azione rapida del soggetto. Lo scatto di un prodotto solitamente predilige una rotazione controllata, una leggera carrellata di luce o una rivelazione graduale. Ogni grado di movimento drammatico costringe il modello a inventare più informazioni visive—e l'invenzione è dove compaiono gli artefatti.
Ecco perché l'immagine sorgente ha un peso così grande. Stabilisce il soggetto, la composizione, l'illuminazione e lo stile da cui il modello deve lavorare. Per un output più forte, parti da un soggetto chiaro e riconoscibile, buona illuminazione, dettagli nitidi, artefatti minimi, una composizione deliberata, abbastanza spazio vuoto per il movimento desiderato e livelli di primo piano e sfondo distinti. Un'immagine affollata, sfocata o fortemente ritagliata offre al modello meno elementi su cui ragionare—un'immagine inquadrata strettamente su un volto raramente lascia spazio per un ampio movimento di camera. Una sorgente forte non garantisce un clip perfetto, ma offre al modello un punto di partenza molto migliore. Se stai generando quelle immagini statiche da zero, il nostro generatore di immagini IA può produrle prima di animarle.
Dove creator e team la usano davvero
Image-to-video si guadagna il suo posto quando il movimento serve il messaggio, non quando è decorazione fine a se stessa.
- Social media. Trasforma foto, miniature, illustrazioni o opere generate in brevi clip per Shorts, Reels e TikTok. L'output verticale conta di più quando l'elemento visivo originale è stato creato per il mobile.
- Marketing di prodotto. Anima l'immagine di un prodotto con un sottile zoom, rotazione, cambio di illuminazione o movimento dello sfondo per far risaltare un asset statico in un annuncio.
- YouTube e produzione video. Usa i clip come intro, outro, B-roll, inquadrature di apertura, transizioni o sequenze di sfondo dietro una narrazione—poi aggiungi sopra voce fuori campo, musica, sottotitoli o doppiaggio.
- E-learning e formazione. Aggiungi movimento a diagrammi, immagini storiche ed elementi visivi di presentazione, ma solo dove il movimento chiarisce un'idea.
- Storyboard e lavoro di concept. Anima immagini statiche per esplorare atmosfera, inquadratura e direzione di camera prima di impegnarti in una ripresa completa.
- Immobiliare e viaggi. Trasforma l'immagine ben scelta di un immobile o di una destinazione in un breve clip atmosferico—senza suggerire caratteristiche che il luogo reale non possiede.
In ogni caso il clip è un componente. Un creator di YouTube potrebbe animare diverse illustrazioni, assemblarle in un editor, generare una narrazione e localizzare il video finito per altri mercati.
Le nostre opzioni Image to Video su DubSmart AI
Il nostro generatore Image to Video utilizza l'immagine caricata come primo fotogramma, il che fissa la composizione di apertura e lo stile visivo. Aggiungi un prompt di testo che descrive il movimento del soggetto, gli angoli di camera o le dinamiche della scena, scegli durata e qualità e scarichi il clip.
| Opzione | La nostra offerta |
|---|---|
| Durata del clip | 4, 6 o 8 secondi |
| Livelli di qualità | Standard, Alta, Ultra Alta |
| Audio | Alta e Ultra Alta includono il suono |
| Formati orizzontali | 1280×720 e 1920×1080 |
| Formato quadrato | 1024×1024 |
| Formato verticale | 720×1280 |
| Input | Un'immagine di alta qualità più un prompt di movimento |
Abbiamo costruito lo strumento per social media, pubblicità, progetti artistici e produzioni video più ampie. Per prezzi specifici o consumo di crediti, verifica i valori attuali nel tuo account DubSmart o nelle informazioni del piano prima di dimensionare una produzione, poiché quei dettagli risiedono nel tuo piano piuttosto che sulla pagina pubblica dello strumento.
Come scegliere uno strumento adatto al lavoro
Lo strumento giusto dipende dal contenuto che devi consegnare, non dal fatto che possa produrre una singola demo impressionante. Alcuni criteri distinguono una novità da qualcosa che puoi usare in un flusso di lavoro ripetibile.
Controllo dell'immagine sorgente. Verifica se lo strumento tratta la tua immagine come un primo fotogramma rigoroso, un riferimento flessibile o solo una guida di stile. Un approccio basato sul primo fotogramma mantiene la composizione di apertura legata alla tua sorgente—utile quando lo scatto iniziale è importante.
Controllo del movimento. Cerca un chiaro supporto per movimento del soggetto, movimento di camera, effetti ambientali, velocità e stile. Un movimento accattivante ma imprevedibile è difficile da riprodurre quando hai bisogno di coerenza tra più clip.
Durata e formati. Abbina le durate disponibili e i rapporti d'aspetto alla tua destinazione. I clip brevi sono adatti a post social, annunci, transizioni e inserti; verifica che le opzioni verticale, quadrata e orizzontale corrispondano a dove verrà pubblicato il clip.
Audio. Decidi se hai bisogno di un elemento visivo silenzioso per un editing successivo, suono ambientale, musica, effetti o una traccia completamente generata. L'audio generato dovrebbe comunque essere rivisto per tempistica e pertinenza prima della pubblicazione.
Coerenza. Se un volto, un prodotto, un logo o un personaggio deve rimanere identico per tutta la durata, testa prima diverse generazioni. I modelli possono alterare silenziosamente piccoli dettagli—mani, testo all'interno di un'immagine, loghi, linee architettoniche—mentre sintetizzano i fotogrammi.
Compatibilità con l'editing. Verifica di poter scaricare un formato pratico alla giusta risoluzione, combinarlo con riprese dal vivo e aggiungere sottotitoli, narrazione o doppiaggio senza perdere l'inquadratura di cui il tuo editor ha bisogno. Per i team che già producono con noi contenuti vocali e media localizzati, Image to Video si inserisce in un unico flusso di lavoro invece di aggiungere l'ennesimo strumento a sé stante.
Limitazioni, rischi e diritti da non ignorare
L'IA image-to-video non ricostruisce filmati reali da un'immagine statica. Genera un'interpretazione plausibile del movimento, e questa distinzione è alla base di ogni limitazione che vale la pena pianificare.
Volti, dita, testo, loghi e dettagli di prodotto possono cambiare tra i fotogrammi, quindi rivedi l'intero clip invece di giudicare la prima anteprima. Il modello può anche interpretare erroneamente la profondità, i confini degli oggetti o la causa ed effetto—producendo movimenti innaturali, oggetti che si piegano o un movimento di camera che rivela dettagli inventati. Prompt vaghi come "fallo muovere" danno quasi nessuna direzione; descrizioni specifiche di soggetto, movimento, camera e atmosfera guidano il modello molto meglio. E poiché la tecnologia dà il meglio con clip brevi, una sequenza generata funziona bene come inserto o asset social ma non sostituirà una scena filmata completa.
I rischi più importanti sono etici e legali. Un clip generato non dovrebbe mai suggerire che una persona abbia compiuto un'azione, che un prodotto abbia una caratteristica o che un luogo reale sia cambiato quando nulla di tutto ciò è accaduto—una linea che conta soprattutto in pubblicità, informazione, istruzione e comunicazioni con i clienti. Riguardo ai diritti, usa solo immagini che hai il permesso di elaborare e pubblicare, e presta attenzione con foto di persone identificabili, asset di brand, opere protette da copyright, materiali di proprietà del cliente, informazioni private, somiglianze di celebrità e immagini generate dall'IA con termini d'uso incerti. Trasformare un input non ti concede i diritti sull'input o sul video risultante.
Domande frequenti
Cos'è l'IA image to video in parole semplici?
È un software di IA che trasforma un'immagine statica in un breve video in movimento generando nuovi fotogrammi basati sull'immagine e su un'istruzione di movimento che fornisci.
L'IA image-to-video può aggiungere suono?
Alcuni strumenti generano suono mentre altri producono video silenziosi per un editing successivo. Le nostre opzioni di qualità Alta e Ultra Alta includono il suono; rivedi l'audio generato per tempistica e pertinenza prima della pubblicazione.
Quali immagini funzionano meglio?
Immagini chiare e ben illuminate con un soggetto riconoscibile, aree di primo piano e sfondo distinte, dettagli nitidi e artefatti minimi offrono al modello un punto di partenza più solido rispetto a sorgenti affollate o sfocate.
Quanto durano i clip image-to-video di DubSmart AI?
Offriamo durate di 4, 6 e 8 secondi, nei formati orizzontale, quadrato e verticale.
Posso creare video verticali per TikTok o YouTube Shorts?
Sì. Elenchiamo un formato verticale 720×1280 insieme a risoluzioni quadrate e orizzontali, così i clip si adattano alle piattaforme mobile-first.
L'IA image-to-video è adatta ai contenuti aziendali?
Può funzionare per annunci, elementi visivi di prodotto, formazione, contenuti social e sviluppo di concept, a condizione che tu riveda l'output per accuratezza, coerenza del brand, diritti, consenso ed eventuali affermazioni visive fuorvianti prima che venga pubblicato.