Una imagen fija congela un momento, pero no puede mostrar cómo se movió ese momento. Esa es la brecha que llena la IA de imagen a video. Si te preguntas qué es la IA de imagen a video, la respuesta corta es esta: es una tecnología de medios generativos que toma un solo elemento visual estático—una foto, una ilustración, una toma de producto o una obra de arte generada por IA—y lo anima en un videoclip corto inventando nuevos fotogramas que crean movimiento aparente, movimiento de cámara y, a veces, sonido. Tú proporcionas una imagen, describes lo que debería suceder, y el modelo predice y renderiza los fotogramas intermedios.
Eso suena sencillo, pero la decisión detrás de ello no es solo "¿puede esta herramienta hacer un clip genial?". Se trata de si el movimiento generado se mantiene fiel a tu fuente, se ajusta a tu plataforma y supera una revisión de marca o de precisión. Esta guía explica el mecanismo, lo que puedes controlar, dónde encaja en una producción real y cómo manejamos Imagen a Video dentro de DubSmart AI como una etapa de un flujo de trabajo de medios más amplio.
Tabla de contenidos
En qué se diferencia la IA de imagen a video de sus parecidas
La confusión suele empezar aquí, porque varias herramientas suenan parecidas pero hacen trabajos distintos. La IA de imagen a video genera una secuencia de nuevos fotogramas para que un elemento visual estático parezca moverse con el tiempo. Esa única distinción la separa de todo aquello con lo que se confunde.
- Texto a video construye un clip solo a partir de una descripción escrita, sin imagen inicial.
- Animación de imagen aplica efectos más simples—zoom, paneo, parallax—sin sintetizar movimiento genuinamente nuevo del sujeto.
- Creación de presentaciones recorre varias imágenes fijas pero nunca genera movimiento continuo dentro de un fotograma.
- Video a video reestiliza o edita material que ya existe en lugar de partir de una sola imagen.
Así que una presentación que cambia de la foto A a la foto B no es imagen a video. Tampoco lo es un paneo estilo Ken Burns a través de una sola imagen. El rasgo definitorio es la síntesis de fotogramas: el modelo crea movimiento que nunca fue capturado, anclado al único fotograma que le diste.
Si el doblaje, la transcripción y la localización están en otra parte de tu stack, nuestra explicación sobre herramientas de video con IA todo en uno por caso de uso muestra dónde encaja la imagen a video junto a esas tareas.
Cómo funciona realmente la generación
Los proveedores usan modelos diferentes, pero el proceso se reduce a cuatro capacidades conectadas. Entenderlas te dice por qué algunos clips lucen impecables y otros se deforman.
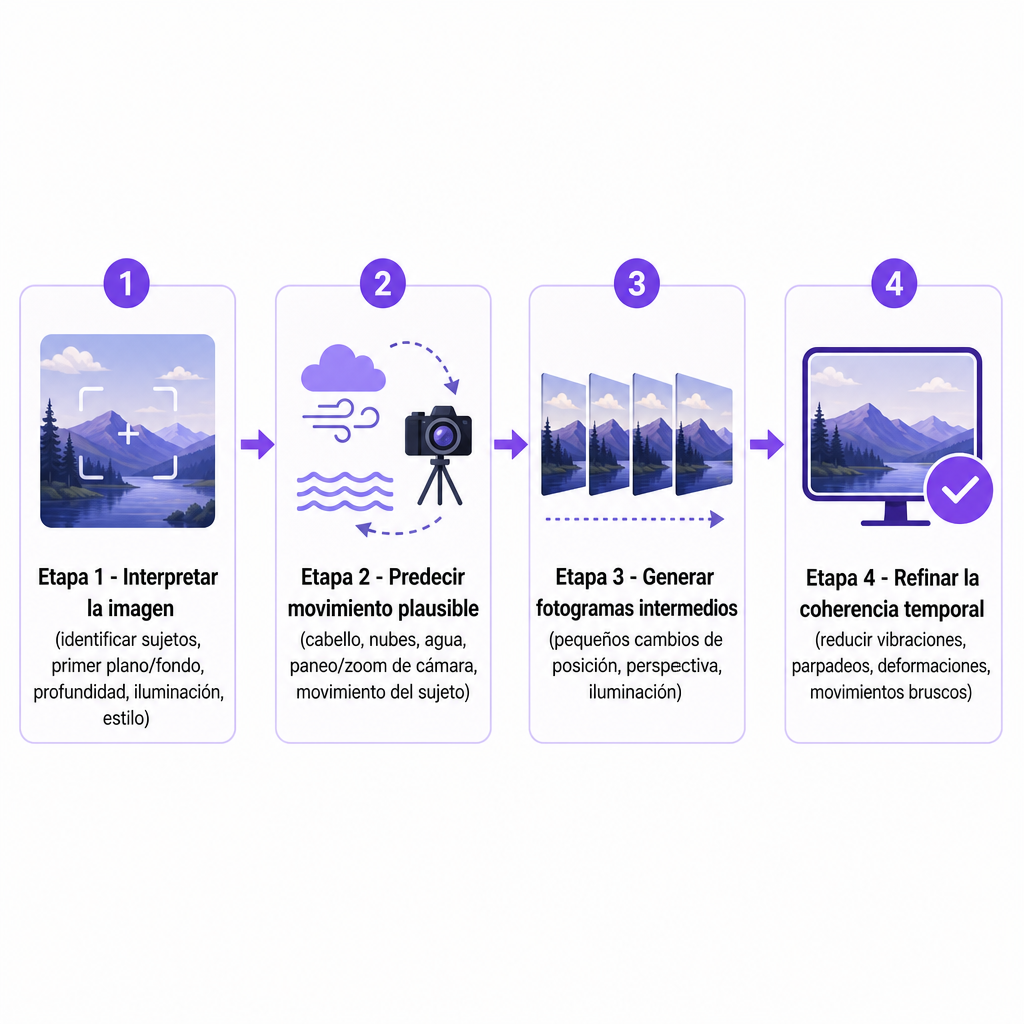
Primero interpreta la imagen. El modelo examina la carga para identificar personas, animales, productos y objetos, luego separa el primer plano del fondo y estima la posición relativa, la profundidad, la iluminación y el estilo visual. La imagen se convierte en una representación funcional de una escena en lugar de una superficie plana.
Luego predice movimientos plausibles. A partir de esa representación, el modelo estima cómo podría cambiar la escena: cómo podría moverse el cabello o la tela, cómo podrían moverse las nubes, el humo, el agua o las hojas, cómo la luz podría desplazarse sobre un objeto, y cómo una cámara podría panear, inclinarse, hacer zoom o acercarse. Estas predicciones no son una grabación de algo que ocurrió. Son posibilidades generadas a partir de la imagen, tu indicación y los patrones aprendidos en el entrenamiento.
Luego genera los fotogramas intermedios. El sistema renderiza una serie de fotogramas con pequeños cambios en posición, perspectiva, iluminación o forma. Reproducidos de forma consecutiva, esos fotogramas se leen como movimiento continuo. Este es el meollo: la herramienta no está revelando material oculto, está sintetizando lo que podría aparecer entre momentos que nunca se filmaron.
Finalmente refina la consistencia temporal. Por último, el modelo suaviza las transiciones para suprimir temblores, parpadeos, cambios repentinos de iluminación, objetos deformados, rostros inconsistentes y movimientos bruscos de cámara. Qué tan bien lo logre depende del modelo, la imagen fuente, la indicación y de cuán compleja sea la acción solicitada. Cuanto más le pidas al modelo que invente, más trabaja esta etapa.
Lo que puedes controlar y lo que decide la imagen fuente
Los mejores resultados vienen de dirigir el movimiento, no de reescribir toda la imagen en prosa. Una indicación fiable nombra cuatro cosas: sujeto, acción, movimiento de cámara y estilo visual.
Una taza de café de cerámica sobre una mesa de madera, el vapor subiendo suavemente, lento acercamiento de cámara, cálida luz matutina, video de producto realista.
A partir de ahí normalmente puedes especificar el movimiento del sujeto (camina, gira, rota, se eleva), el movimiento ambiental (viento, lluvia, humo, hojas que caen), el movimiento de cámara (paneo, inclinación, dolly hacia dentro o hacia fuera, cámara en mano, estática), el ritmo (de suave a rápido), el estado de ánimo (cinematográfico, documental, relajante) y el formato de salida (horizontal, cuadrado, vertical). Recomendamos mantener la primera indicación simple y centrarse en el movimiento que realmente deseas.
El truco está en que tu indicación tiene que coincidir con lo que la imagen puede soportar. Un retrato tiende a verse natural con un movimiento facial o de cámara sutil y poco natural si le pides al sujeto que corra a toda velocidad. Un paisaje a menudo se lee mejor con un paneo lento o movimiento ambiental que con una acción rápida del sujeto. Una toma de producto suele favorecer una rotación controlada, un barrido de luz o una revelación gradual. Cada grado de movimiento dramático obliga al modelo a inventar más información visual—y la invención es donde aparecen los artefactos.
Por eso la imagen fuente tiene tanto peso. Establece el sujeto, la composición, la iluminación y el estilo con los que el modelo debe trabajar. Para un resultado más sólido, comienza con un sujeto claro y reconocible, buena iluminación, detalle nítido, mínimos artefactos, una composición deliberada, suficiente espacio vacío para el movimiento que deseas, y capas distintas de primer plano y fondo. Una imagen abarrotada, borrosa o muy recortada le da al modelo menos con qué razonar—una imagen encuadrada ajustadamente sobre un rostro rara vez deja espacio para un movimiento amplio de cámara. Una fuente sólida no garantiza un clip perfecto, pero le entrega al modelo un punto de partida mucho mejor. Si estás generando esas imágenes fijas desde cero, nuestro generador de imágenes con IA puede producirlas antes de que las animes.
Dónde la usan realmente los creadores y los equipos
La imagen a video se gana su lugar cuando el movimiento sirve al mensaje, no cuando es decoración por sí misma.
- Redes sociales. Convierte fotos, miniaturas, ilustraciones o arte generado en clips cortos para Shorts, Reels y TikTok. El formato vertical importa más cuando el elemento visual original fue creado para móvil.
- Marketing de producto. Anima una imagen de producto con un zoom sutil, rotación, cambio de iluminación o movimiento de fondo para hacer que un recurso estático destaque en un anuncio.
- YouTube y producción de video. Usa clips como introducciones, cierres, B-roll, tomas de establecimiento, transiciones o secuencias de fondo detrás de la narración—luego superpones voz en off, música, subtítulos o doblaje.
- E-learning y capacitación. Agrega movimiento a diagramas, imágenes históricas y elementos visuales de presentaciones, pero solo donde el movimiento aclare una idea.
- Storyboarding y trabajo de concepto. Anima imágenes fijas para explorar el ambiente, el encuadre y la dirección de cámara antes de comprometerte a una grabación completa.
- Bienes raíces y turismo. Transforma una imagen bien elegida de una propiedad o destino en un clip atmosférico corto—sin dar a entender características que la ubicación real no tiene.
En todos los casos, el clip es un componente. Un creador de YouTube podría animar varias ilustraciones, ensamblarlas en un editor, generar la narración y localizar el video terminado para otros mercados.
Nuestras opciones de Imagen a Video en DubSmart AI
Nuestro generador de Imagen a Video usa la imagen cargada como el primer fotograma, lo que fija la composición inicial y el estilo visual. Agregas una indicación de texto que describe el movimiento del sujeto, los ángulos de cámara o la dinámica de la escena, eliges la duración y la calidad, y descargas el clip.
| Opción | Nuestra oferta |
|---|---|
| Duración del clip | 4, 6 u 8 segundos |
| Niveles de calidad | Estándar, Alta, Ultra Alta |
| Audio | Alta y Ultra Alta incluyen sonido |
| Formatos horizontales | 1280×720 y 1920×1080 |
| Formato cuadrado | 1024×1024 |
| Formato vertical | 720×1280 |
| Entrada | Una imagen de alta calidad más una indicación de movimiento |
Creamos la herramienta para redes sociales, publicidad, proyectos artísticos y producciones de video más grandes. Para precios específicos o consumo de créditos, confirma las cifras actuales en tu cuenta de DubSmart o en la información del plan antes de planificar una producción, ya que esos detalles están asociados a tu plan y no en la página pública de la herramienta.
Cómo elegir una herramienta para el trabajo
La herramienta adecuada depende del contenido que necesitas entregar, no de si puede producir una demostración impresionante. Unos pocos criterios separan una novedad de algo que puedes usar en un flujo de trabajo repetible.
Control de la imagen fuente. Comprueba si la herramienta trata tu imagen como un primer fotograma estricto, una referencia flexible o solo una guía de estilo. Un enfoque de primer fotograma mantiene la composición inicial ligada a tu fuente—útil cuando la toma inicial importa.
Control del movimiento. Busca un soporte claro para el movimiento del sujeto, el movimiento de cámara, los efectos ambientales, la velocidad y el estilo. Un movimiento atractivo pero impredecible es difícil de reproducir cuando necesitas consistencia entre varios clips.
Duración y formatos. Ajusta las duraciones y relaciones de aspecto disponibles a tu destino. Los clips cortos se adaptan a publicaciones sociales, anuncios, transiciones e inserciones; confirma que las opciones vertical, cuadrada y horizontal se alineen con el lugar donde se ejecutará el clip.
Audio. Decide si necesitas un visual silencioso para editar más tarde, sonido ambiente, música, efectos o una pista completamente generada. El audio generado debería revisarse igualmente por su sincronización y relevancia antes de entregarlo.
Consistencia. Si un rostro, producto, logotipo o personaje debe mantenerse idéntico en todo momento, prueba varias generaciones primero. Los modelos pueden alterar discretamente pequeños detalles—manos, texto dentro de una imagen, logotipos, líneas arquitectónicas—mientras sintetizan fotogramas.
Compatibilidad de edición. Confirma que puedes descargar un formato práctico con la resolución adecuada, combinarlo con material de acción real y agregar subtítulos, narración o doblaje sin perder el encuadre que tu editor necesita. Para los equipos que ya producen voz y medios localizados con nosotros, Imagen a Video encaja en un flujo de trabajo en lugar de agregar otra herramienta independiente más.
Limitaciones, riesgos y derechos que no puedes saltarte
La IA de imagen a video no reconstruye material real a partir de una imagen fija. Genera una interpretación plausible del movimiento, y esa distinción impulsa cada limitación que vale la pena planificar.
Los rostros, los dedos, el texto, los logotipos y los detalles de producto pueden cambiar entre fotogramas, así que revisa todo el clip en lugar de juzgar la primera vista previa. El modelo también puede malinterpretar la profundidad, los límites de los objetos o la causa y el efecto—produciendo movimiento poco natural, objetos que se doblan, o un movimiento de cámara que revela detalles inventados. Indicaciones vagas como "haz que se mueva" dan casi ninguna dirección; descripciones específicas del sujeto, el movimiento, la cámara y el ambiente guían al modelo mucho mejor. Y como la tecnología es más fuerte en clips cortos, una secuencia generada funciona bien como inserción o recurso social pero no reemplazará una escena filmada completa.
Los riesgos que más importan son éticos y legales. Un clip generado nunca debería dar a entender que una persona realizó una acción, que un producto tiene una característica, o que un lugar real cambió cuando nada de eso sucedió—una línea que importa especialmente en publicidad, noticias, educación y comunicaciones con clientes. En cuanto a derechos, usa solo imágenes que tengas permiso para procesar y publicar, y ten precaución con fotos de personas identificables, activos de marca, obras de arte con derechos de autor, materiales propiedad de clientes, información privada, imágenes de celebridades e imágenes generadas por IA con términos de uso inciertos. Transformar una entrada no te otorga derechos sobre la entrada ni sobre el video resultante.
Preguntas frecuentes
¿Qué es la IA de imagen a video en términos simples?
Es un software de IA que convierte una imagen fija en un video corto en movimiento generando nuevos fotogramas basados en la imagen y una instrucción de movimiento que tú proporcionas.
¿Puede la IA de imagen a video agregar sonido?
Algunas herramientas generan sonido mientras que otras producen video silencioso para editar más tarde. Nuestras opciones de calidad Alta y Ultra Alta incluyen sonido; revisa el audio generado por su sincronización y relevancia antes de publicar.
¿Qué imágenes funcionan mejor?
Imágenes claras y bien iluminadas con un sujeto reconocible, áreas distintas de primer plano y fondo, detalle nítido y mínimos artefactos le dan al modelo un punto de partida más sólido que fuentes abarrotadas o borrosas.
¿Cuánto duran los clips de imagen a video de DubSmart AI?
Ofrecemos duraciones de 4, 6 y 8 segundos, en formatos horizontal, cuadrado y vertical.
¿Puedo crear videos verticales para TikTok o YouTube Shorts?
Sí. Incluimos un formato vertical de 720×1280 junto con resoluciones cuadradas y horizontales, de modo que los clips se ajustan a plataformas de prioridad móvil.
¿Es adecuada la IA de imagen a video para contenido empresarial?
Puede funcionar para anuncios, elementos visuales de producto, capacitación, contenido social y desarrollo de conceptos, siempre que revises el resultado por su precisión, consistencia de marca, derechos, consentimiento y cualquier afirmación visual engañosa antes de que se publique.